NeurIPS'25 A-Mem晓读:2倍性能算力节省,卢曼笔记法定义AI记忆
旺晓通:深入浅出解读,轻松通晓技术
我一直有个很矛盾的观察:现在的AI智能体,就像一个背完了一整本百科全书,却不会做综合题的学生。
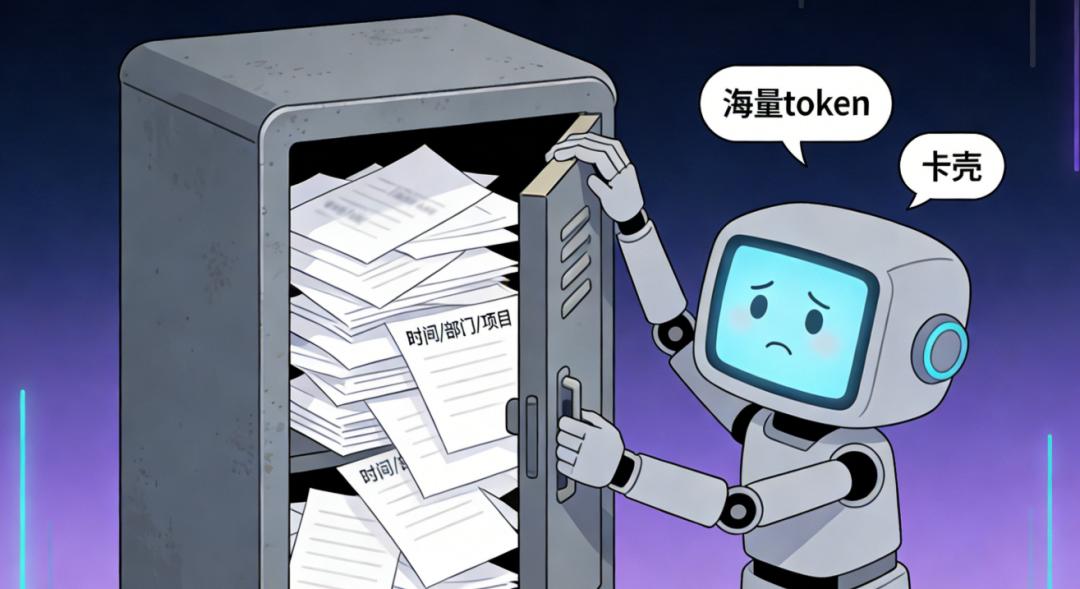
你给它单条信息,它记得比谁都牢;但要它把半个月前的3条碎片化信息串起来,做一次多步推理,它立刻就卡壳了。要么是翻遍所有历史上下文,烧掉海量token也找不到重点;要么是干脆忘了关键信息,一本正经地胡说八道。
直到我看完这篇NeurIPS'25的《A-MEM: Agentic Memory for LLM Agents》论文,才突然明白:问题根本不是AI记不住,而是它的记忆方式,从根上就错了。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
传统AI记忆,本质是个“死归档柜”
你有没有发现,现在绝大多数AI智能体的记忆系统,都在做同一件事:给信息找个固定的“文件夹”。
要么是按时间顺序把所有对话堆在一起,用的时候全量检索;要么是提前定好规则,把信息分成“事实记忆”“流程记忆”“用户偏好”等固定类别,新信息进来必须塞进预设的分类里。
这像极了公司里那个十几年没变过的归档柜:你必须按“年份-部门-项目”的固定规则放文件,一旦你想找“去年3月和A客户对接时提到的B产品售后问题”,而归档规则里没有“客户+产品”的交叉分类,你就得翻遍几十个文件夹。更别说让柜子自己发现,“这个售后问题,和上个月C客户遇到的问题,本质是同一个”。
论文里点破了这个核心痛点:传统记忆系统的所有操作,都依赖预定义的流程和规则。它只能在人类设定好的框架里分类、存储、检索,没法随着信息的增加,自己建立新的关联,更没法让已有的记忆跟着新的经验一起演化。
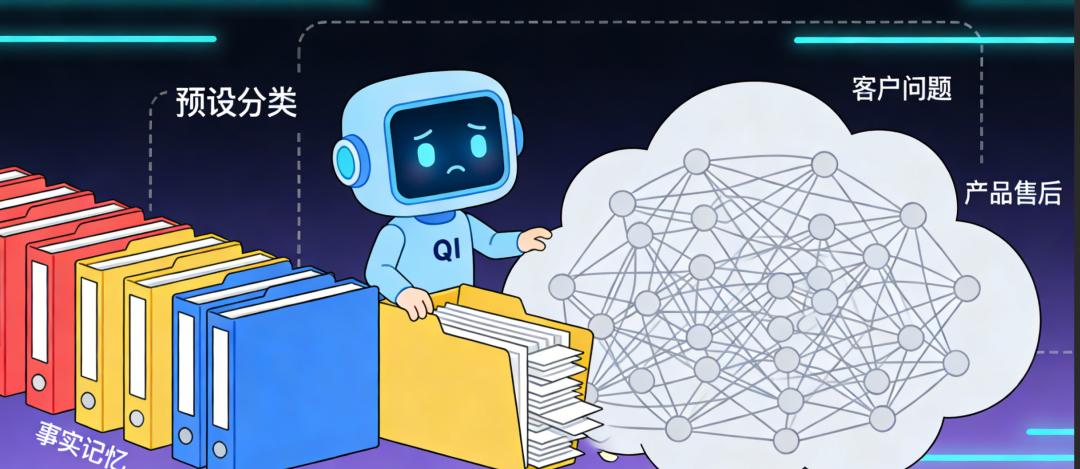
这种僵化,直接导致了AI在长周期、复杂推理任务里的拉胯表现。我们之前测试过不少主流的智能体框架,不管是靠全量上下文堆出来的记忆,还是按固定规则提取的摘要记忆,最终都逃不过两个结局:要么token成本高到离谱,要么记忆变成一堆毫无关联的碎片,根本没法用来支撑深度思考。
把卢曼的卡片盒,搬进了AI的大脑
这套系统的核心灵感来自卢曼的Zettelkasten卡片盒笔记法。做知识管理的人都知道,卢曼的卡片盒,是完全反归档柜逻辑的。它的核心规则只有三条:每张卡片只记一个原子化的知识点,给每张卡片写清上下文和属性,主动给新卡片和已有的卡片建立关联。它没有固定的文件夹,所有的知识都靠链接形成一张不断生长的网,新卡片的加入,不仅是新增了一条信息,还会触发旧卡片的更新,甚至催生出全新的知识关联。卢曼就是靠这套系统,一辈子写了70多本书和数百篇论文。
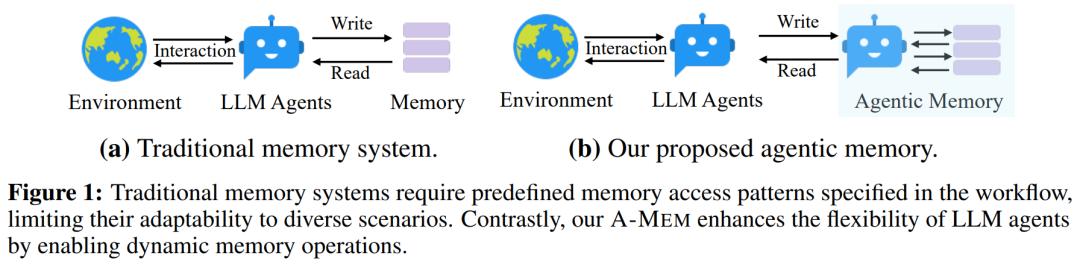
而这篇论文提出的A-MEM自主记忆系统,本质就是把卢曼的卡片盒,完整地搬进了AI的大脑里。
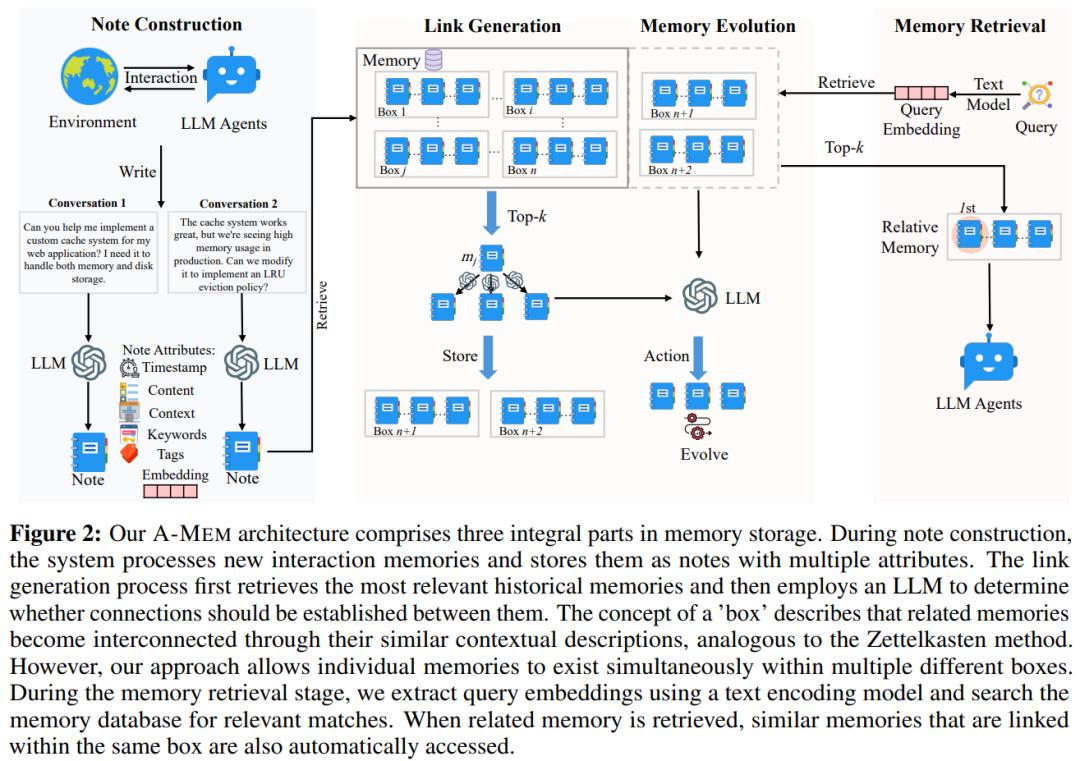
它的核心设计,完全跳出了“预定义规则”的桎梏:
第一,给每一条新记忆,都生成一张完整的“原子化笔记”。 不是随便存一段文本,而是同时包含结构化的属性描述、完整的上下文信息,以及用于语义匹配的嵌入向量,确保每一条记忆都是独立、完整、可被关联的。
第二,自主链接生成。 新笔记进来后,系统会先找到语义最相关的已有记忆,再让大模型自主分析它们之间的共性与关联,自动建立链接,全程没有任何人类预设的分类规则。
第三,记忆自主演化。 新记忆的加入,不只是新增了一条内容,还会触发已有记忆的上下文更新,让整个记忆网络随着新的经验,不断提炼更高阶的规律,完成自主的认知升级。
说实话,我看到这里的时候,第一反应是:没有固定规则,AI会不会乱加链接,把记忆网搞乱?但论文里的消融实验,直接给了我最直白的答案:当去掉链接生成和记忆演化两个模块时,系统在多跳推理和开放域任务里的性能直接暴跌;只保留链接生成模块时,性能只有中等水平;只有两个模块同时工作,系统才能在全场景拿到最优表现。
原来AI自己建立的记忆关联,比我们人类拍脑袋定的规则,要靠谱得多。
15%的算力,换200%的推理提升,这才是最狠的
这篇论文最颠覆行业认知的,从来不是它的设计有多精巧,而是它用极低的成本,拿到了翻倍的性能提升。
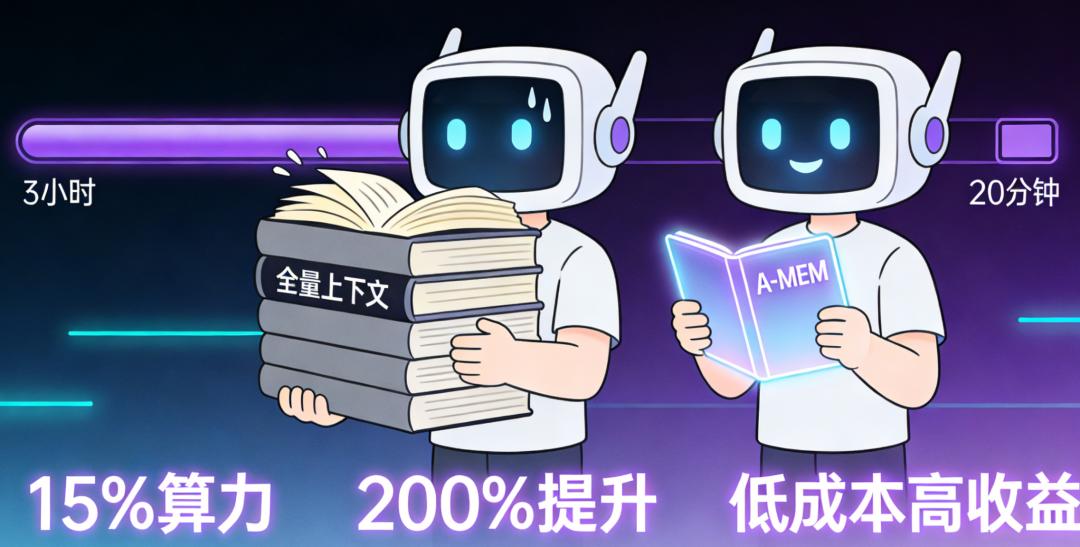
我给你算一笔最直观的账:
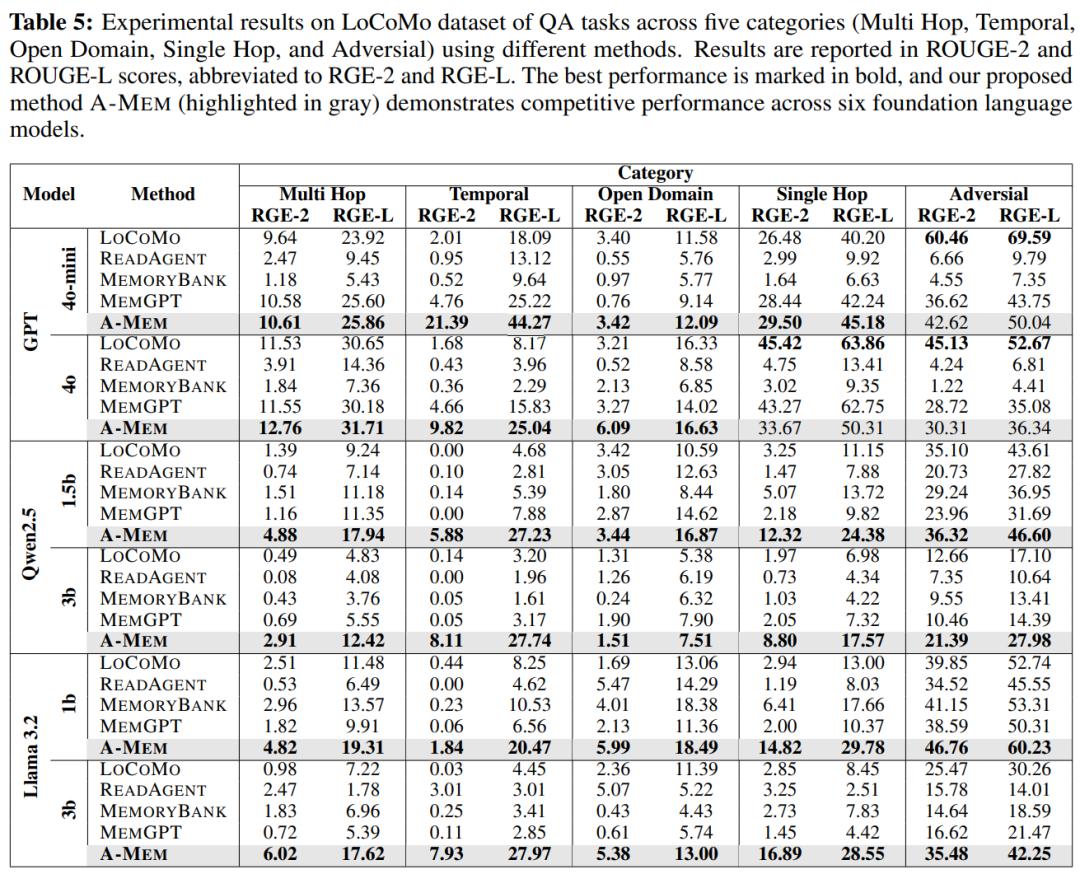
在最考验记忆联动能力的多跳推理任务中,用GPT-4o-mini作为底座模型,A-MEM的ROUGE-L分数达到了44.27,而行业主流的基线模型LoComo只有18.09,性能直接翻了2.45倍,接近200%的提升。
更夸张的是算力成本:完成同样的推理任务,A-MEM只需要消耗1200-2500个token,而基线模型需要整整16900个token。算下来,它只用了基线模型不到15%的算力,就拿到了翻倍的性能。
这像极了两个备考的学生:一个学生把整本书一字不落地背下来,考试的时候把整本书翻一遍,花了3个小时,刚到及格线;另一个学生把知识点做成了关联卡片,理清了所有逻辑脉络,考试的时候只需要翻几张关键卡片,花了20分钟,就考到了优秀。
更难得的是,这套系统的通用性极强。论文里测试了GPT、DeepSeek-R1、Claude等6款主流大模型,在6项不同的评估指标下,A-MEM都能带来稳定的性能提升,不是只适配某一款模型的“定制优化”。
这让我突然想到,现在行业里很多人都在疯狂卷“更长的上下文窗口”,觉得窗口越大,记忆能力就越强。但这篇论文直接给出了一个反常识的答案:真正的长期记忆,从来不是把所有东西都塞进上下文里,而是让AI学会怎么管理自己的记忆,怎么用最少的信息,做最精准的推理。
就像我们人类,从来不会把一辈子见过的所有事,都放在脑子里思考问题。我们靠的是关联、索引和抽象,快速找到需要的信息,用核心信息完成思考。这才是认知的本质,而不是堆容量。
从“死记硬背”到“自主思考”,AI记忆的本质是认知升级
记忆的本质,从来不是存储,而是为了支撑思考。
这也是A-MEM最打动我的地方:它终于让AI的记忆,回归了认知的本质。人类的记忆从来不是一个只读的硬盘,而是一个不断重构的系统——每次我们回忆一件事,都会用新的认知修改这段记忆,让它和新的经验融合,形成更完整的认知体系。而A-MEM的记忆演化模块,恰恰就是模拟了人类的这个认知过程。
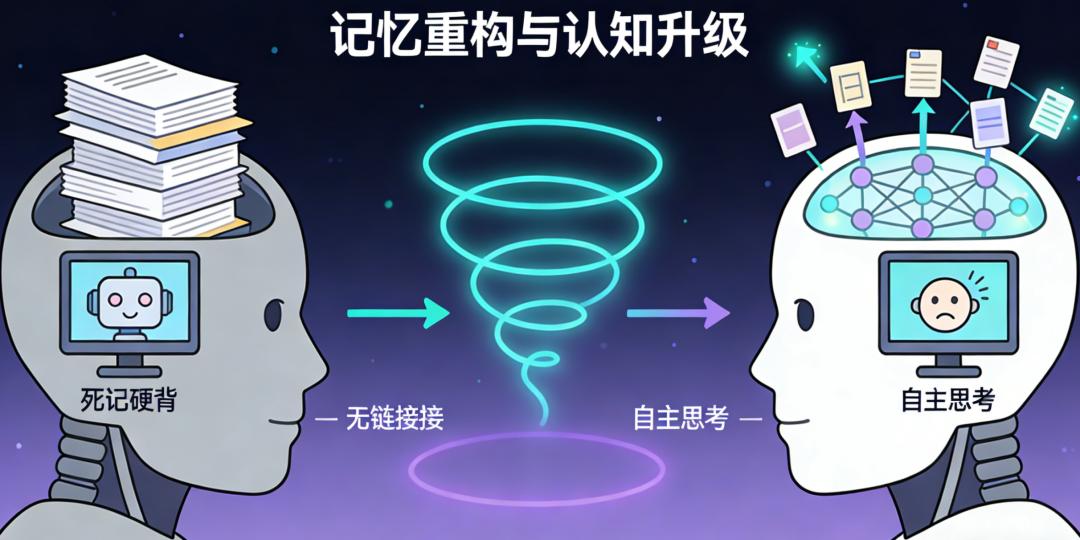
当然,我也必须客观地说,这套系统并不是完美的。论文里的测试,主要集中在长对话和多跳推理任务,在创意生成、开放世界的复杂交互任务中,它的效果还有待验证。同时,完全自主的链接生成,会不会带来“幻觉关联”——比如AI把两个不相关的记忆强行绑定,导致推理错误,这也是未来需要解决的问题。
但这并不妨碍它成为一次极具启发性的尝试。
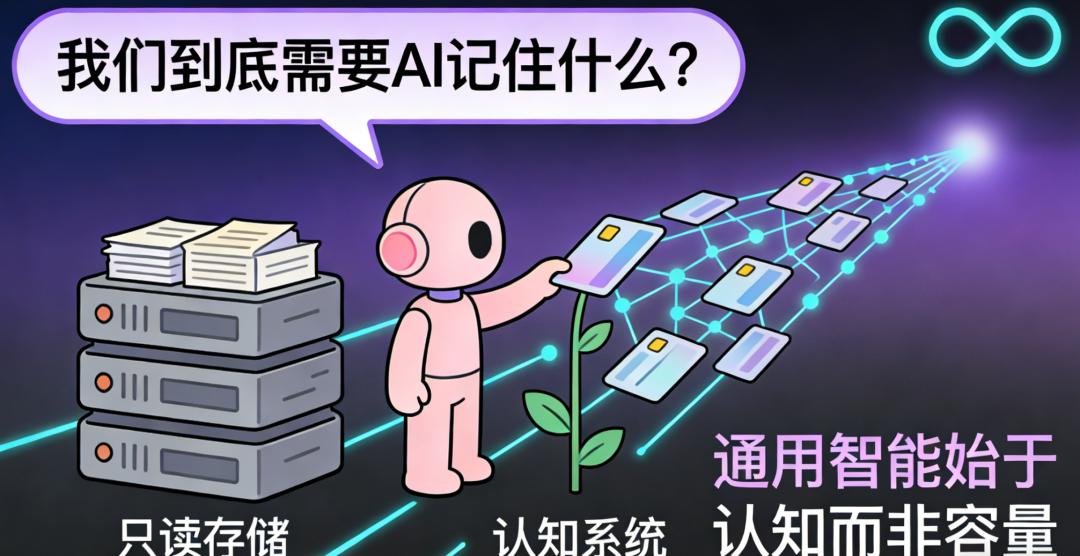
结尾:我们到底需要AI记住什么?
写完这篇解读的时候,我一直在想一个问题:我们到底希望AI拥有什么样的记忆?
是记住人类有史以来所有的知识,做一个永不犯错的百科全书?还是学会像人类一样思考,用记忆支撑自己的认知成长,解决未知的问题?
这篇论文给了我一个清晰的答案。未来的AI,一定不是参数越堆越大、上下文越做越长的“怪物”,而是像人类一样,会记重点,会找关联,会不断更新自己认知的“思考者”。
卢曼的卡片盒之所以伟大,从来不是因为它存了9万张卡片,而是因为这些卡片之间的链接,形成了一个能自己生长的认知系统,能不断帮他产生全新的想法。而A-MEM做的,就是给AI装上了这样一个能自己生长的卡片盒。
我们总说,要让AI拥有通用智能。但通用智能的起点,从来不是记住更多的信息,而是学会怎么用已有的信息,去面对未知的世界。
从这个角度来说,这篇论文重构的,从来不止是AI的记忆系统,更是我们对AI认知升级的核心逻辑。
参考资料
• 标题:A-MEM:面向大语言模型智能体的自主记忆系统(A-Mem: Agentic Memory for LLM Agents)
• 作者:Wujiang Xu、Zujie Liang、Kai Mei、Hang Gao、Juntao Tan、Yongfeng Zhang
• 单位:Rutgers University、蚂蚁集团、Salesforce Research
• 链接:https://openreview.net/pdf?id=FiM0M8gcct