Qwen3.5技术报告晓读:4.3% 激活效率革命,迈向原生多模态智能体
旺晓通:深入浅出解读,轻松通晓技术
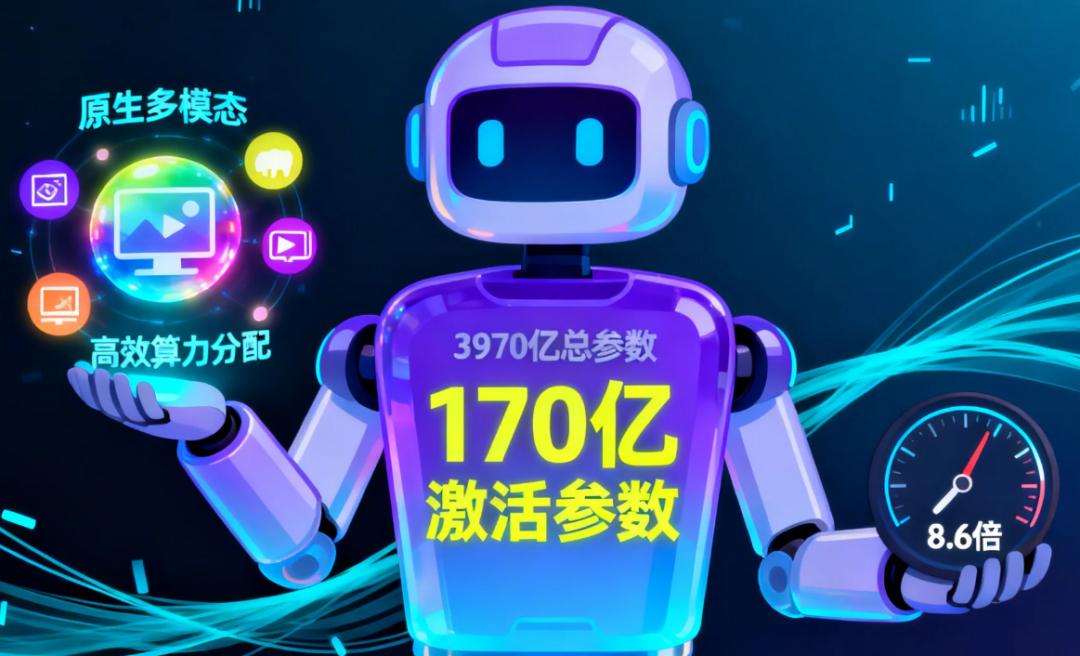
当我点开Qwen3.5的技术博客时,第一眼就被一组数字惊到了:3970亿总参数量的大模型,单次前向传播仅激活170亿参数——意味着超过95%的参数都在“待命”,却实现了8.6倍的解码吞吐量提升。
我第一反应是:这才是大模型该有的进化方向。你有没有发现一个矛盾点?过去两年,大模型行业陷入了“参数竞赛”,千亿、万亿参数量的模型层出不穷,但我们实际使用时,却总感觉“大而不当”——生成一篇短文要等几秒,处理长视频直接卡顿,更别提普通开发者根本负担不起动辄百万级的算力成本。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
Qwen3.5的出现,像给这场“军备竞赛”踩了一脚刹车:原来大模型的进步,不是靠堆参数的“蛮力”,而是靠算力分配的“巧劲”。
大模型的“低效困境”:背着满书包的书去考试
要理解Qwen3.5的创新,得先搞懂现在大模型的“傻大个”问题。
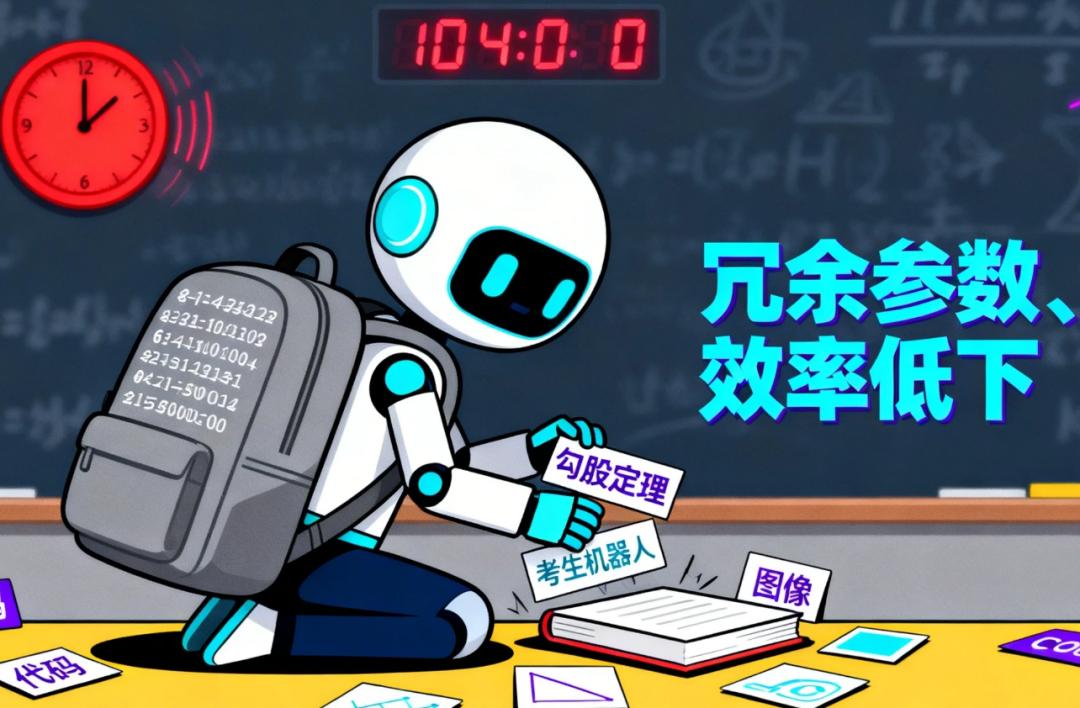
想象一下这样的场景:你去参加一场数学考试,为了应付可能出现的所有题型,你把从小学到大学的所有课本都背进了考场。考试时,你明明只需要用勾股定理,却要在满脑子的知识点里翻找半天,不仅浪费时间,还容易被无关信息干扰。
现在的大模型,就是这个“背满书包的考生”。为了覆盖所有任务场景,它们把海量参数都“激活待命”,但单次推理时,绝大多数参数都是冗余的——处理简单的文本生成,却要调动处理复杂数学推理的参数;理解图片内容,却要激活处理代码的模块。
更麻烦的是多模态融合的“生硬感”。很多所谓的“多模态模型”,其实是先把图片转成文字描述,再让语言模型处理,就像两个人用翻译器沟通,效率低还容易失真。而长文本、长视频处理更是噩梦,上下文窗口一扩大,推理速度就断崖式下跌,就像用小水管灌大水池。
这三个痛点,本质上指向同一个问题:大模型的发展,已经从“有没有”进入“好不好用”的阶段,而“好用”的核心,就是效率。
技术解读:给大模型装一套“智能分工系统”
Qwen3.5的解决方案,说穿了就是给大模型建立“精兵简政”的分工体系,核心靠三个关键设计,用通俗的比喻就能看懂。
1. 混合架构:让“专业的人干专业的事”
Qwen3.5的核心创新是混合架构——融合了门控Delta网络(Gated Delta Networks)的线性注意力和稀疏混合专家模型(MoE)。
这就像一家高效的公司:稀疏混合专家模型是各个“专业部门”,比如“推理部”“编码部”“多模态部”,每个部门只负责自己擅长的任务;门控Delta网络是“智能调度中心”,接到任务后快速判断该激活哪个部门,其他部门则处于“待命状态”,不占用算力。
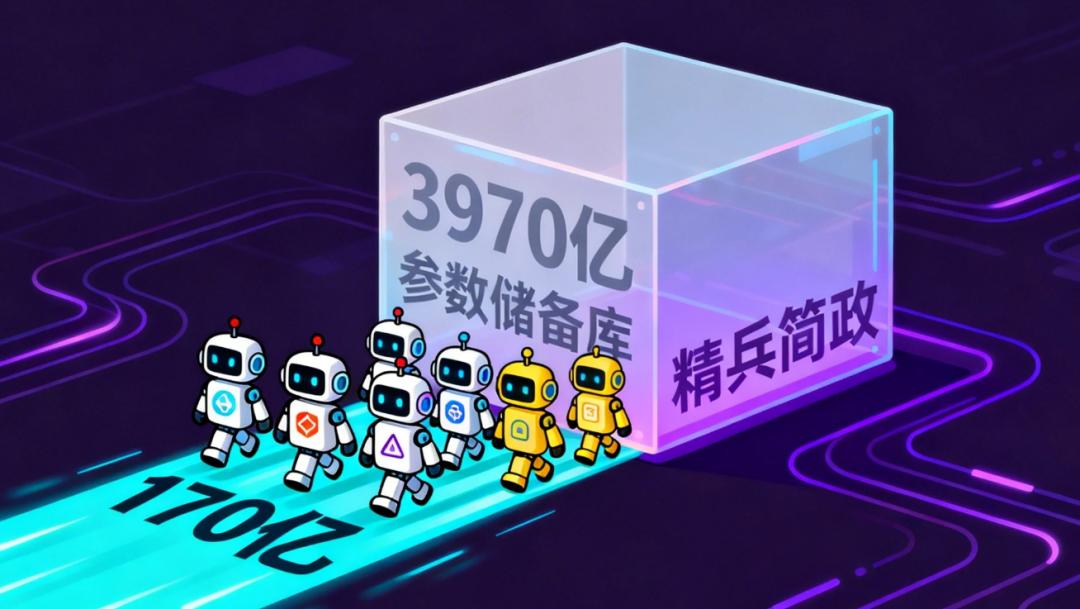
3970亿总参数,就是这家公司的“全部人才储备”,而170亿激活参数,是针对当前任务派出的“精锐团队”。这样一来,既保留了大模型的能力边界,又避免了“全员上阵”的算力浪费。
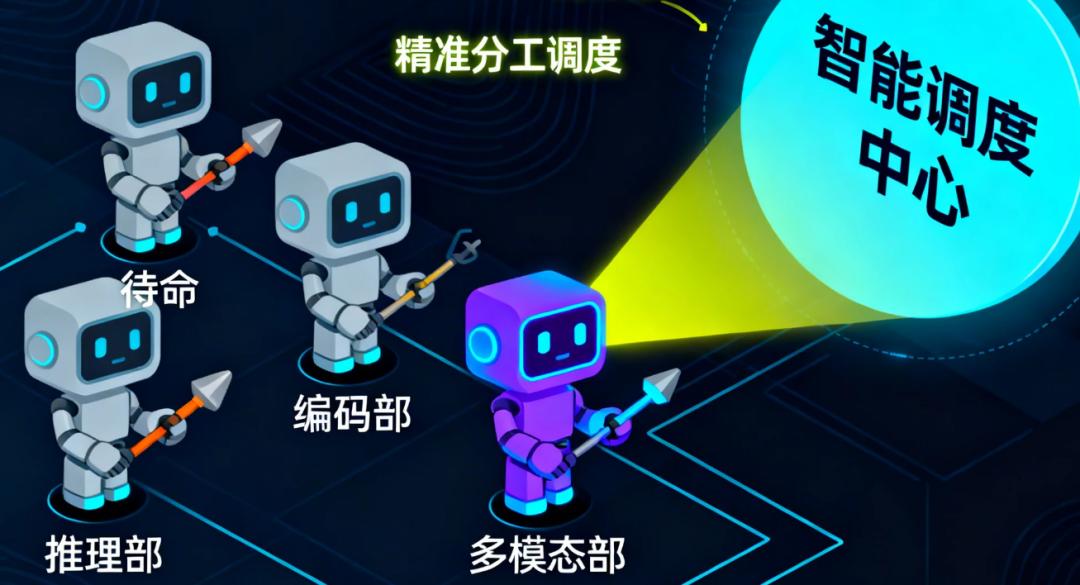
你可能会问:这种分工模式不是早就有了吗?确实,但Qwen3.5做到了“更高稀疏”——简单说就是分工更细、调度更快,不会出现“多个部门重复干活”或“调度耗时超过干活耗时”的问题。
2. 原生多模态:从“翻译沟通”到“无缝协作”
如果说传统多模态模型是“语言和视觉两个团队靠翻译器沟通”,Qwen3.5的原生多模态融合,就是“两个团队从入职起就一起工作”。
它通过早期文本-视觉融合技术,让语言和视觉信息从处理的第一步就深度结合,而不是后期拼接。就像人类看图表时,大脑会同时处理图像中的线条和文字信息,而不是先把图表描述成文字再理解。
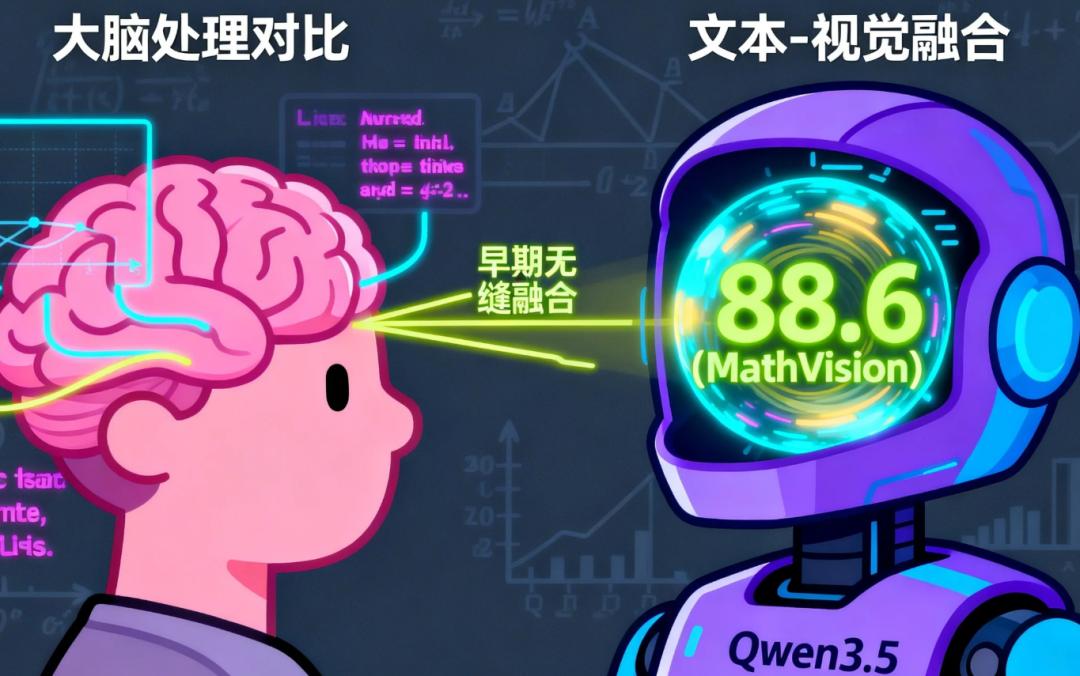
这一点在数学推理任务中表现得特别明显:面对一张数学图表,Qwen3.5能直接提取图像中的数据和逻辑关系,结合文字指令解题,而不是先把图表转成文字描述再推理,效率和准确率都大幅提升——在MathVision任务中,它拿到了88.6的高分,超过了GPT5.2和Gemini-3 Pro。
3. 高效工程优化:给大模型“减负提速”
如果说混合架构是“优化分工”,那Qwen3.5的工程优化就是“优化工具”。
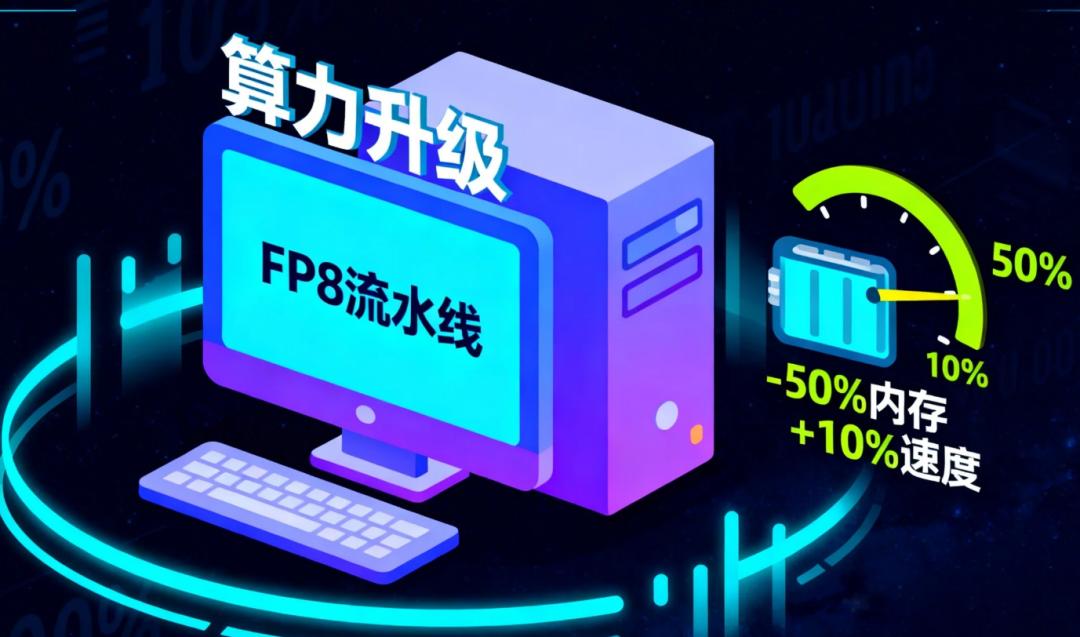
它的原生FP8流水线技术,就像给大模型的“工作电脑”升级了操作系统,在不影响工作质量的前提下,减少了50%的内存占用,还提升了10%以上的速度。而多令牌预测、稳定性优化等技术,相当于给团队配备了高效的协作工具,让整个工作流程更顺畅。
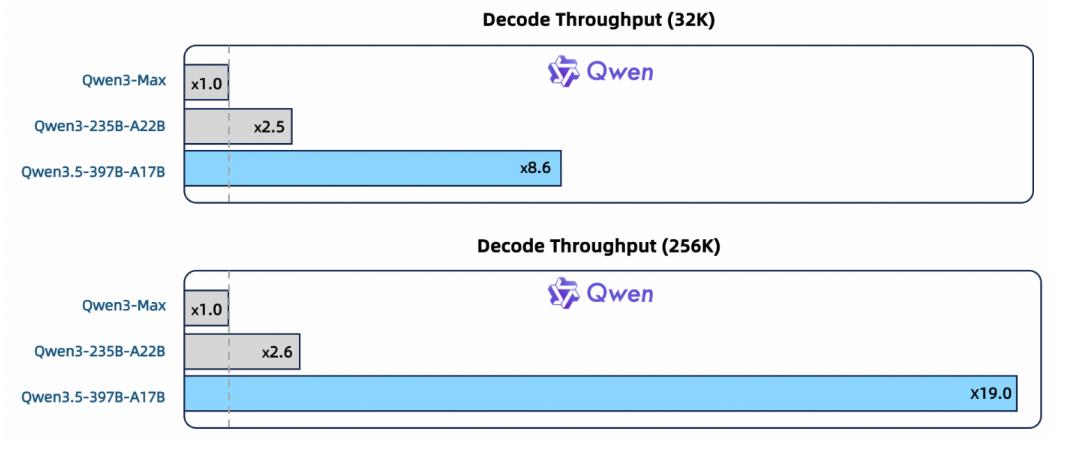
这些优化带来的效果非常直观:在32k上下文长度下,Qwen3.5的解码吞吐量是Qwen3-Max的8.6倍;在256k超长上下文下,更是达到了19倍——意味着处理两小时的视频或百万字的文档,以前要等几十秒,现在几秒就能完成。
效率的本质是“取舍与平衡”
Qwen3.5的设计逻辑,让我想起了心理学中的“认知资源有限理论”——人类的认知资源是有限的,所以我们会发展出注意力分配、选择性记忆等策略,避免把精力浪费在无关的事情上。
比如我们工作时,不会同时思考所有任务,而是聚焦当前核心问题;读书时,不会逐字逐句记忆,而是提炼关键信息。大模型的发展,正在从“模仿人类的能力”走向“模仿人类的认知策略”。
这也让我想到了管理学中的“精益管理”——消除浪费,追求效率最大化。Qwen3.5对算力的精益分配,就是大模型领域的精益管理实践。过去,大模型的进步靠“堆资源”,就像粗放型经济靠扩大生产规模;而现在,靠“提效率”,就像集约型经济靠优化生产方式——这是行业走向成熟的必然。
更有意思的是,Qwen3.5的多语言支持从119种扩展到201种,词汇量从15万增加到25万,却没有增加太多算力负担。这背后是“高效编码”的思路,就像用更简洁的语言表达更丰富的意思,既扩大了能力边界,又没有增加系统负担——这和人类语言的进化逻辑不谋而合,语言的本质,就是高效传递信息的工具。
实验结果:不堆参数,也能打遍主流模型
Qwen3.5的厉害之处,不在于参数多,而在于“用更少的资源办更多的事”。
在语言任务上,它在MMLU-Pro拿到87.8的分数,接近Claude 4.5 Opus的89.5;在IFBench指令跟随任务中,它以76.5的分数排名第一,超过了GPT5.2的75.4。要知道,它的激活参数量远少于这些竞品。
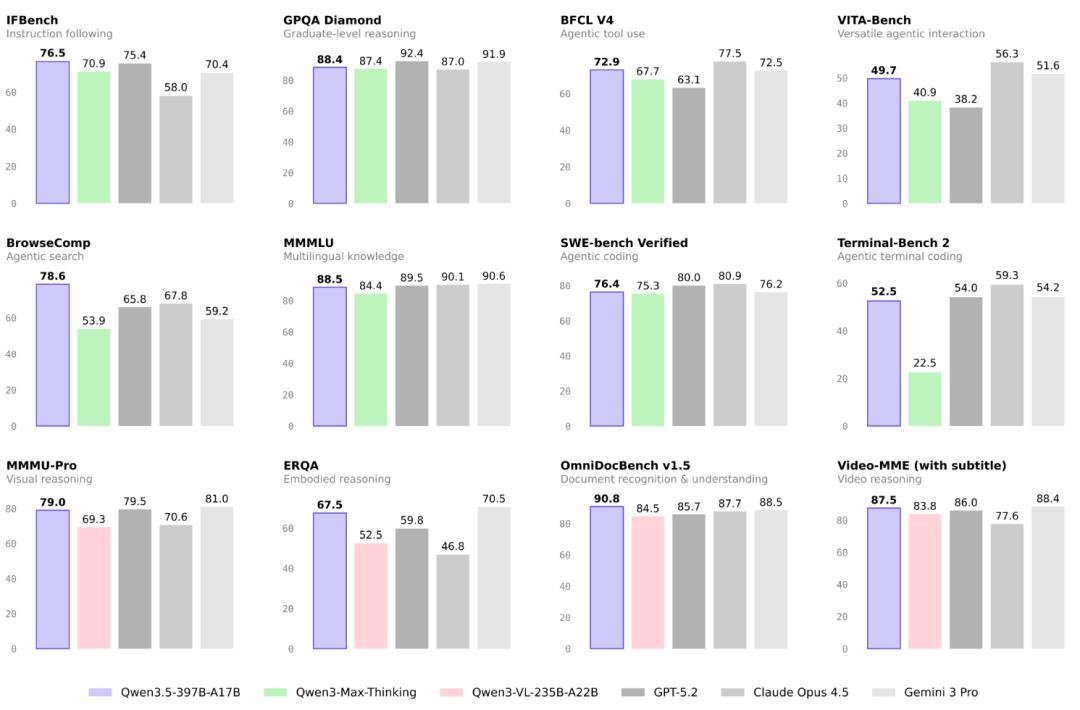
在多模态任务上,表现更亮眼:文档理解任务OmniDocBench1.5拿到90.8的高分,位居所有模型第一;视频理解任务Video-MME(带字幕)达到87.5,和Gemini-3 Pro的88.4不相上下;医学VQA任务SLAKE拿到79.9,相比Qwen3-VL提升了近25个百分点。
最关键的是,这些成绩不是靠牺牲速度换来的。在32k上下文下,它的推理速度是Qwen3-Max的8.6倍,意味着你可以一边和它实时对话,一边让它处理复杂的多模态任务,不会有任何卡顿感。
当然,它也不是完美的。在一些需要极致创意生成的任务上,它的表现和参数规模更大的模型还有差距;在部分小众语言的支持上,虽然覆盖了201种,但部分方言的理解准确率还有提升空间。但这些瑕疵,并不影响它成为大模型效率革命的标志性产品。
个人启发:大模型的未来,是“聪明”而非“庞大”
读完Qwen3.5的技术报告,我最大的感受是:大模型的竞争,已经从“比大小”进入“比聪明”的阶段。
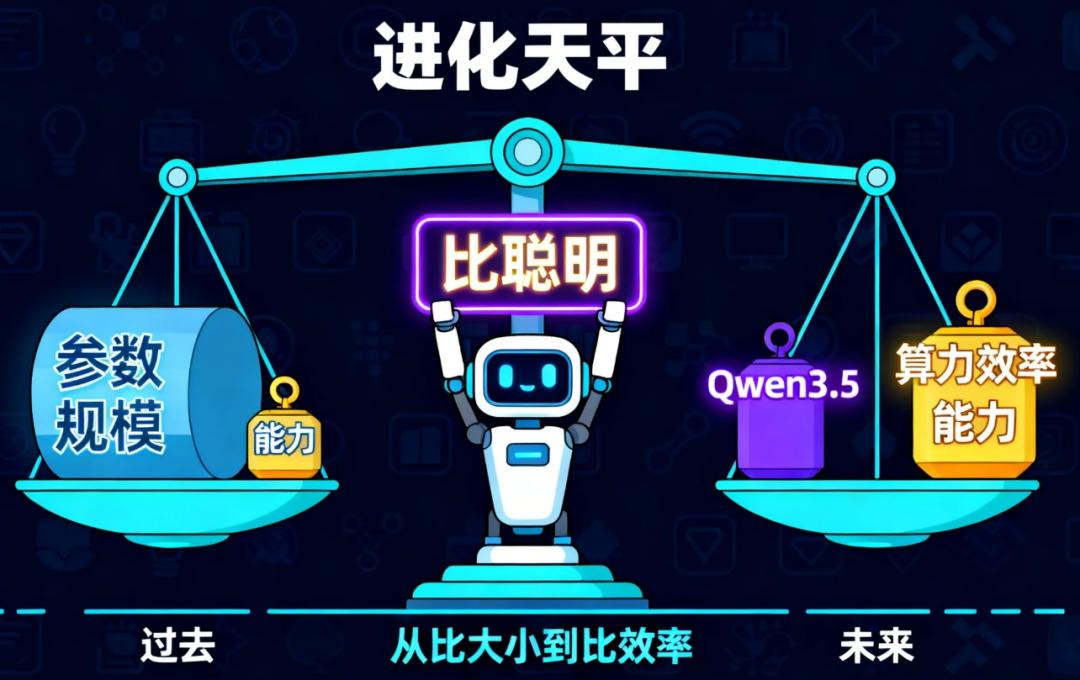
过去,我们判断一个模型好不好,看参数量、看训练数据量;未来,我们会看它的算力效率、看它的任务适配能力、看它是否真正好用。Qwen3.5的出现,给行业树立了一个新标杆:优秀的大模型,不是能做所有事,而是能高效做好该做的事。
这对普通用户来说,意味着AI工具会越来越好用、越来越亲民——不需要高端显卡,不需要支付高昂的API费用,就能享受到强大的AI能力;对开发者来说,意味着技术门槛降低,更多人能参与到AI应用的创新中;对行业来说,意味着大模型的落地速度会加快,从实验室走进更多行业,真正赋能生产生活。
更深远的影响是,它让我们重新思考AI的发展方向。AI的目标不是成为“无所不能的庞然大物”,而是成为“高效贴心的助手”。就像人类的进步不是靠拥有更多知识,而是靠更好地运用知识一样,AI的进步,也不是靠拥有更多参数,而是靠更好地分配参数。
总结展望:效率革命背后的技术哲学
Qwen3.5的效率革命,本质上是技术哲学的转变——从“追求全能”到“追求精准”,从“规模驱动”到“价值驱动”。
在这个人人追求“内卷”和“堆料”的时代,Qwen3.5的出现像一股清流:它告诉我们,真正的进步,不是做加法,而是做减法;不是追求更多,而是追求更优。
未来的大模型,会越来越像“庖丁”,越来越懂“取舍”。它们不会再背着满书包的书去考试,而是带着精准的工具和清晰的思路;它们不会再试图覆盖所有任务,而是在擅长的领域做到极致高效;它们不会再是冷冰冰的算力集合,而是能理解需求、高效响应的智能伙伴。
而这场效率革命,才刚刚开始。
参考资料
• 标题:Qwen3.5:迈向原生多模态智能体(Qwen3.5: Towards Native Multimodal Agents)
• 作者:Qwen Team
• 链接:https://qwen.ai/blog?id=qwen3.5