AI本周Top进展(20260222)|Gemini3.1/Qwen3.5、AI搅动网络安全
如果这周你只刷到一条 AI 新闻,那很可能是谷歌 Gemini 3.1 Pro 屠榜的消息。但如果你以为这就是本周的全部,那可就错过了太多精彩——阿里巴巴拿出了效率革命的 Qwen3.5,Anthropic 用 AI 代码安全工具搅动了整个网络安全股,清华团队用 AI 让韦伯望远镜看到了更深的宇宙,还有强化学习之父泼来的那盆“大模型狂热”冷水。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
我们把这周最重磅的AI进展串成一条线,带你看看技术背后的逻辑。文章最后还有本周技术趋势总结,记得看到底。
Top1. 🔬 Gemini 3.1 Pro 屠榜:推理能力翻倍,0.1 版本号的逆天逆袭
谁能想到,一个只涨了 0.1 的版本号,能让整个 AI 圈集体失眠?
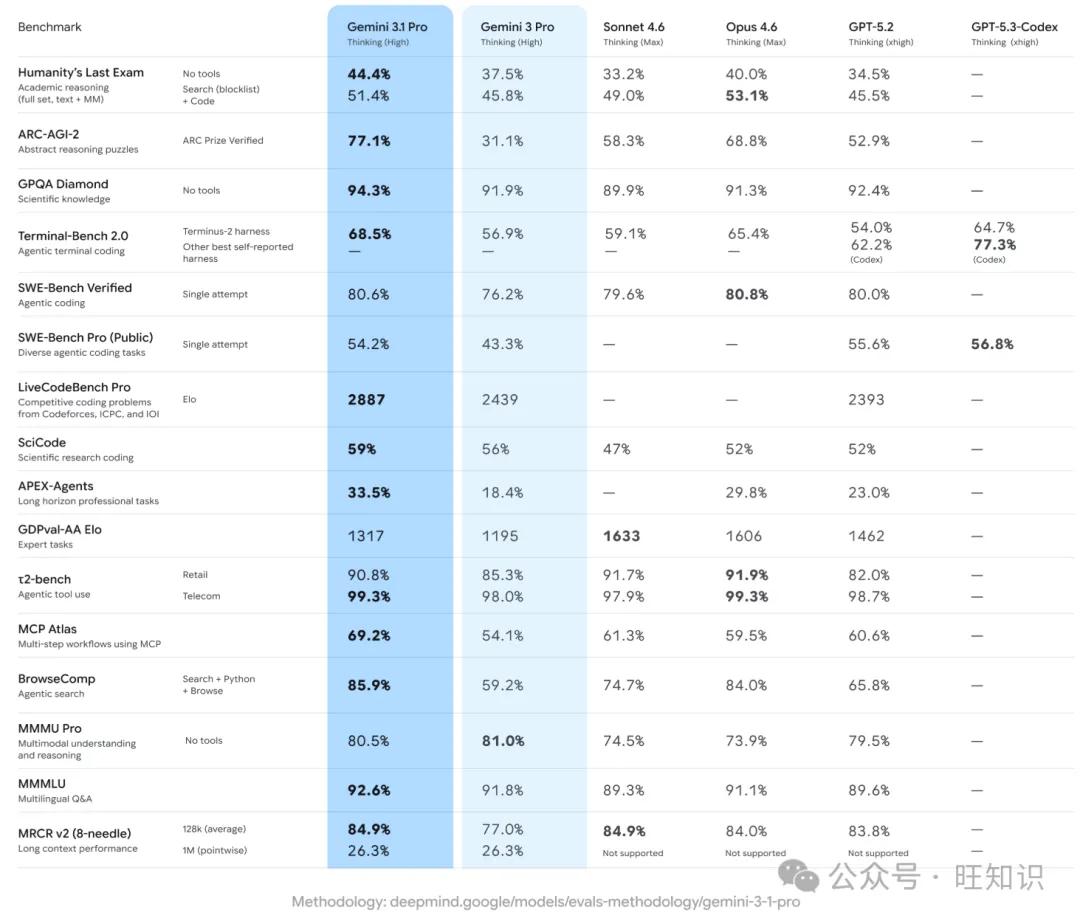
2 月 20 日凌晨,谷歌 DeepMind 突然甩出“核弹级”更新——Gemini 3.1 Pro 横空出世。在 ARC-AGI-2 这个 AI 界公认的“抽象推理终极考试”中,它一举拿下 77.1% 的验证分数,直接登顶榜首。这个数字意味着什么?它不仅比上一代 Gemini 3 Pro(31.1%)翻了两倍还多,更把 Claude Opus 4.6(68.8%)、GPT-5.2(52.9%)远远甩在身后。
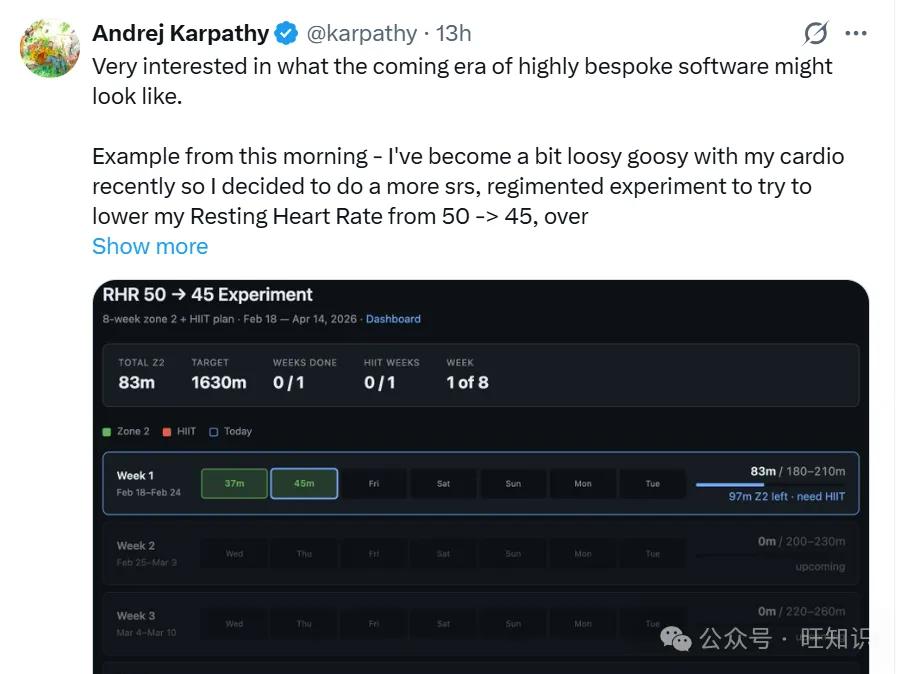
OpenAI 联创 Karpathy 更是宣判:“应用商店的时代,该结束了。”
真正的杀招不只是跑分。Gemini 3.1 Pro 把复杂的专业工作流变成了“一句话的事”:输入一段文字描述,3 分钟就能搓出专业级 SVG 动画;
 接入公开遥测数据,一键搭建追踪国际空间站轨道的航天仪表盘;
模拟城市规划,直接生成包含地形、道路、交通线路的完整城市鸟瞰图。
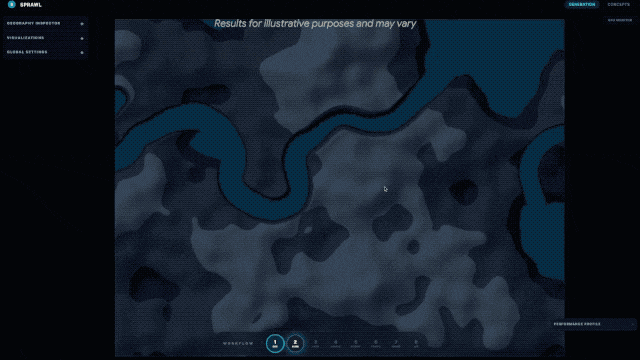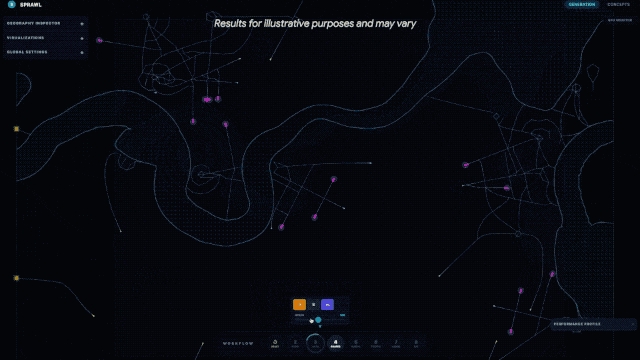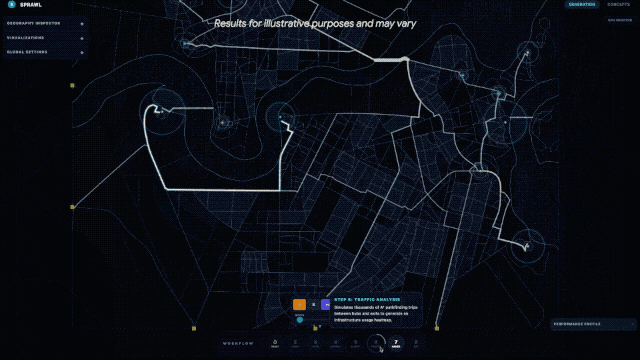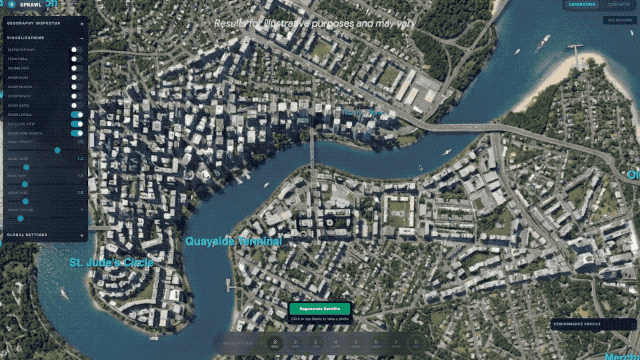
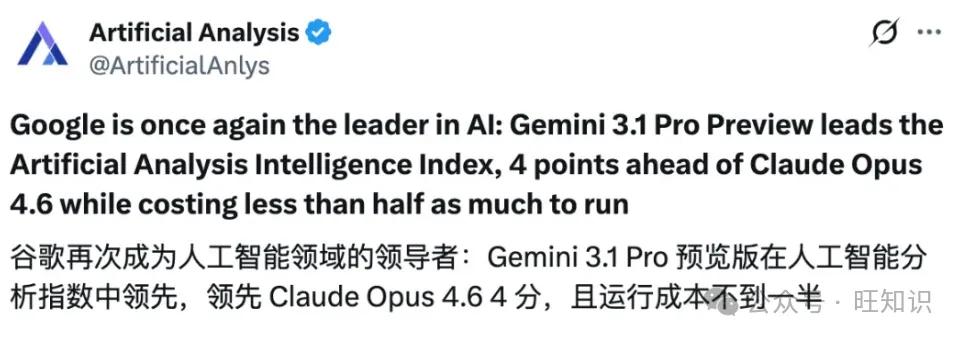
更狠的是性价比。第三方机构 Artificial Analysis 的数据显示,Gemini 3.1 Pro 在智能指数中领先 Claude Opus 4.6 足足 4 分,运行成本却不到后者的一半。ARC-AGI-2 测试每完成一次任务仅需 0.96 美元,彻底打破了传统的成本-智能曲线。
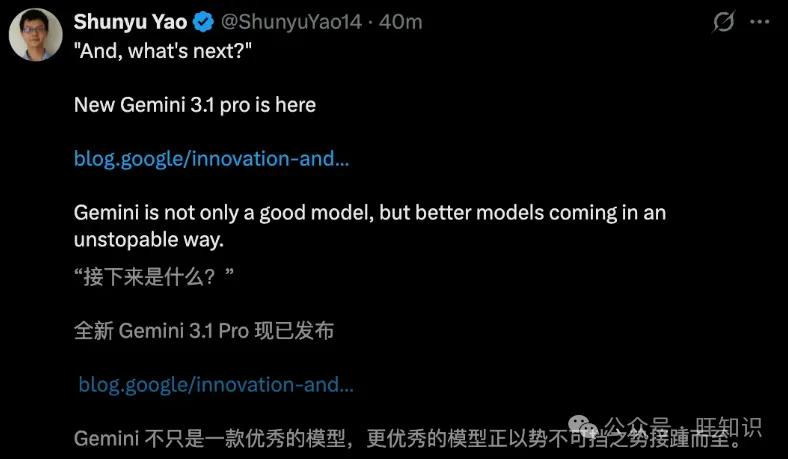
清华物理系特奖得主姚顺宇亲自站台,直言“更好的模型正以不可阻挡的方式到来”。
Top2. ⚡ 阿里 Qwen3.5:4.3% 激活参数,大模型效率革命的答案
当大家都在拼参数量的时候,阿里巴巴通义千问团队选择了一条不一样的路。
Qwen3.5-397B-A17B 模型的总参数量高达 3970 亿,但单次前向传播仅激活 170 亿参数——意味着超过 95% 的参数都在“待命”,却实现了 8.6 倍的解码吞吐量提升。这就是混合架构的魔力:门控 Delta 网络负责智能调度,稀疏混合专家模型(MoE)各司其职,就像一家高效的公司,针对当前任务派出“精锐团队”,其他部门则处于待命状态。
。
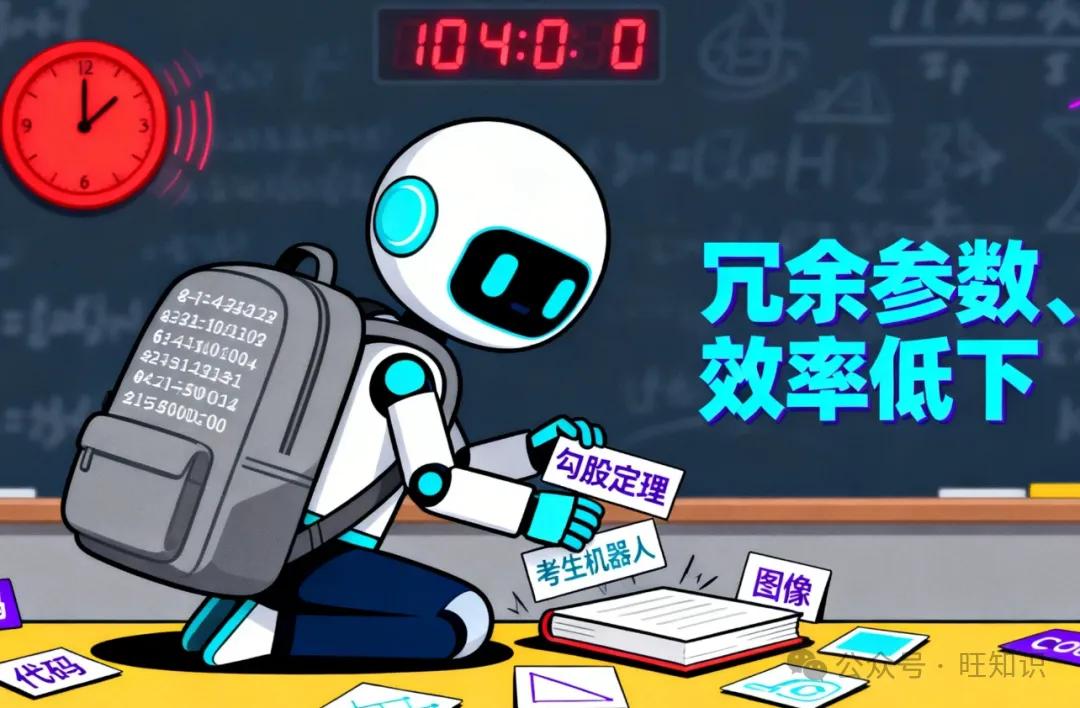
这个设计直接戳中了当前大模型的痛点。想象一下:你去参加数学考试,为了应付所有题型,把从小学到大学的课本都背进考场。明明只需要用勾股定理,却要在满脑子的知识点里翻找半天——现在的大模型就是这个“背满书包的考生”。
Qwen3.5 的原生多模态融合能力也值得关注。它通过早期文本-视觉融合技术,让语言和视觉信息从处理的第一步就深度结合。在 MathVision 任务中拿到 88.6 的高分,超过了 GPT5.2 和 Gemini-3 Pro。
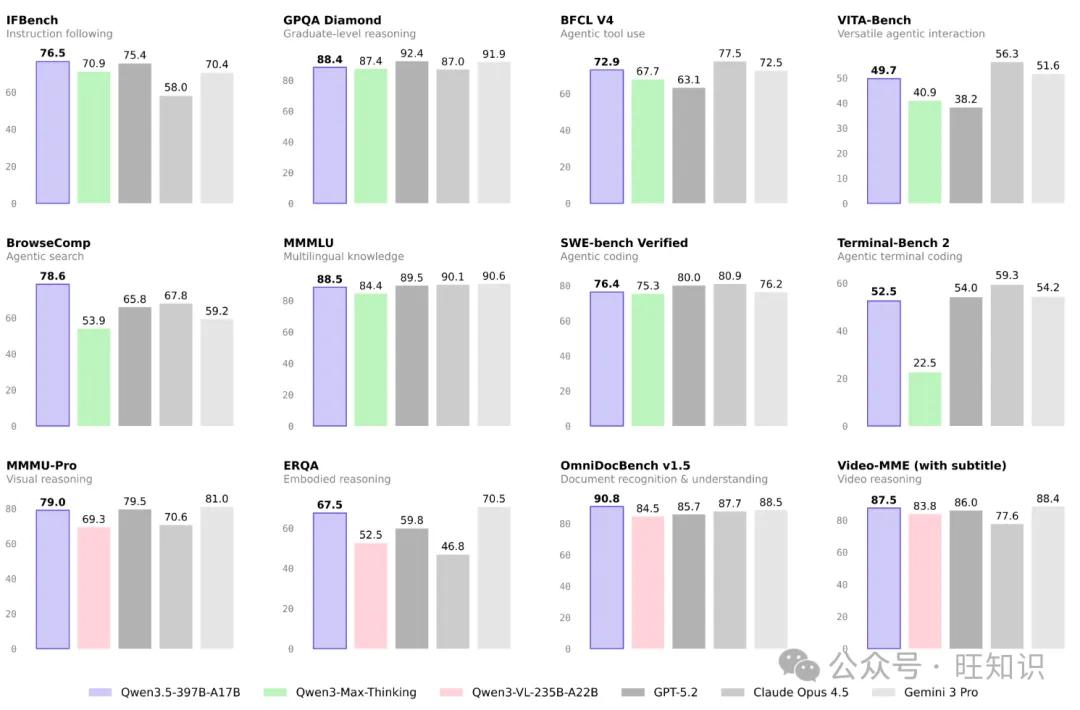
更实用的是,Qwen3.5 的解码吞吐量在 32k 上下文长度下是 Qwen3-Max 的 8.6 倍,在 256k 超长上下文下更是达到了 19 倍。这意味着处理两小时的视频或百万字的文档,以前要等几十秒,现在几秒就能完成。
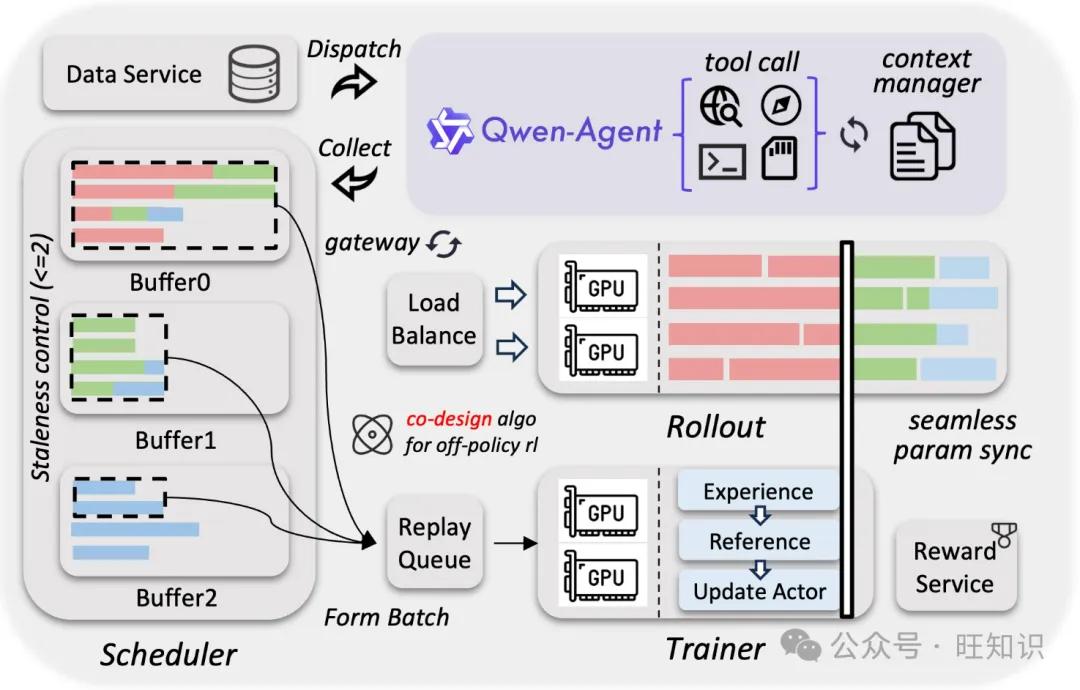
Top3. 🔒 Claude Code Security:Anthropic 一把火烧了网络安全股
2 月 20 日,美股网络安全板块集体跳水。CrowdStrike 收跌约 8%,Cloudflare 跌逾 8%,Okta 下挫 9.2%,追踪全球网络安全公司的 Global X Cybersecurity ETF 当日收跌 4.9%,报收于 2023 年 11 月以来的最低位。
触发抛售的,是 Anthropic 当天发布的 Claude Code Security.
这款工具集成在 Claude Code 中,能够像人类安全研究员那样理解整个代码库,追踪数据在应用程序中的流动方式,分析组件之间的交互逻辑,发现传统静态分析工具难以覆盖的复杂漏洞。Anthropic 内部前沿红队(Frontier Red Team)的测试显示,基于 Opus 4.6 模型,在生产级开源代码库中发现了超过 500 个此前未被检出的漏洞,其中一些存在了数十年。
这不是 Anthropic 第一次搅动市场。1 月 30 日,Claude Cowork 的行业专用插件发布后,软件、金融服务和资产管理板块当天蒸发了约 2850 亿美元市值。Thomson Reuters 暴跌 16%,创公司史上最大单日跌幅。
投资者的恐慌可以理解:如果用 AI 就能完成工作,企业为什么还要花钱买软件订阅?但巴克莱的分析师认为这种抛售“与事实不符”——Claude Code Security 本质上是一个开发者安全工具,不构成对传统网络安全公司的直接竞争。
不过,AI 基础模型公司正在从提供“通用智能”走向提供“垂直功能”,这个趋势已经清晰可见。
Top4. 🎵 Gemini 上线 AI 音乐生成:7.5 亿用户的口袋里住进一位作曲家
如果说 Suno 和 Udio 代表了 AI 音乐的创业浪潮,谷歌本周的举动则标志着这场竞赛正式升级为平台级别的角力。
谷歌在月活 7.5 亿的 Gemini 应用中上线了 AI 音乐生成功能。用户输入一句话或上传一张照片,几秒钟内就能得到一首 30 秒的完整歌曲,带人声、带歌词、带 AI 生成的封面。背后是 DeepMind 最新的 Lyria 3 模型,训练数据涵盖超 200 万首曲目。
Lyria 3 相比前代有明显进步:过去用户需要自己写歌词输入模型,现在可以根据提示词自动生成歌词;用户对风格、人声类型、节拍速度等元素的控制也更精细;输出 48kHz 立体声音频,人声表现更自然,歌词的咬字清晰度也有明显提升。
谷歌的措辞格外谨慎,强调 Lyria 3 的设计目标是“原创表达,而非模仿现有艺术家”。所有生成的音乐都会嵌入 SynthID 水印,Gemini 还新增了音频鉴别功能,用户可以上传一段音频文件,询问它是否由谷歌 AI 生成。
Tom‘s Guide 的编辑在体验后写道,她把丈夫的待办事项清单变成了一首朋克摇滚歌曲,然后通过短信发了出去。这种场景可能正是谷歌想要的:音乐生成的杀手级应用也许并不在录音棚里,而是藏在日常生活的每一条消息、每一次分享中。
Top5. 🌌 清华Science发表“星衍”:AI 让韦伯望远镜看到宇宙更深的秘密
清华大学自动化系戴琼海院士团队和天文系蔡峥副教授团队本周在 Science 杂志发表了一项重磅成果:提出时空自监督计算成像模型——星衍(ASTERIS),攻克极低信噪比下的高保真光子重构难题。
这个突破有多重要?它将詹姆斯·韦伯空间望远镜的探测深度提升 1 个星等,找到 3 倍数量于过往研究的极暗弱高红移候选天体,绘制出迄今最深邃的极致深空星系图像。
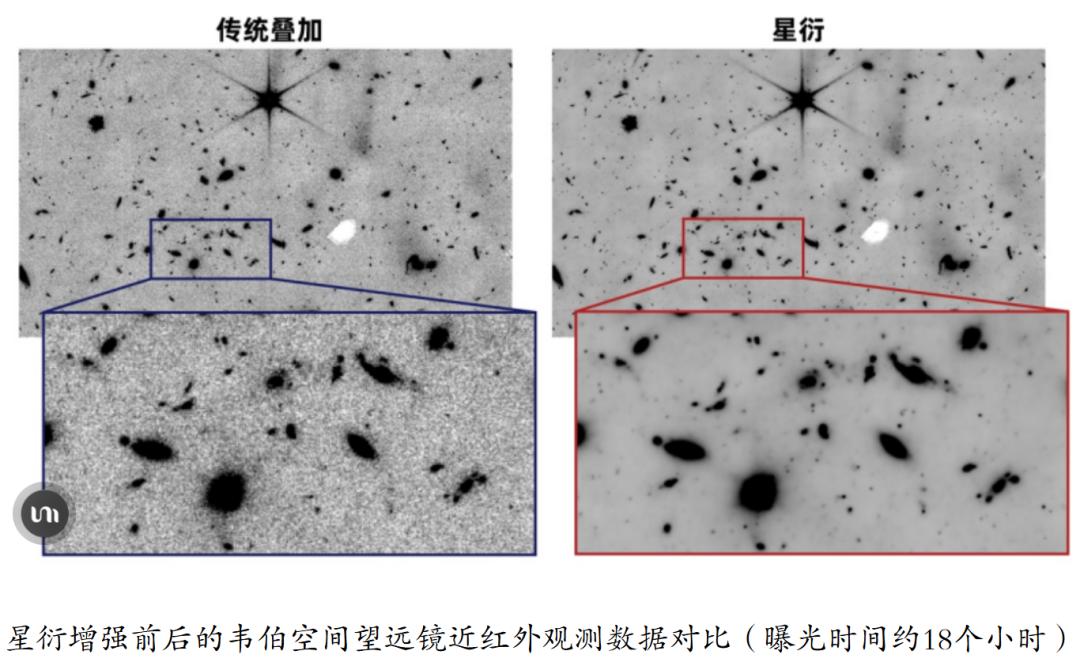
天文观测领域长期面临一个物理瓶颈:明亮的天光背景噪声与望远镜自身的热辐射噪声叠加,形成了一朵遮挡暗弱星光的“乌云”。传统方法基于独立同分布假设的叠加、堆栈,在面对极暗弱信号时力有不逮。
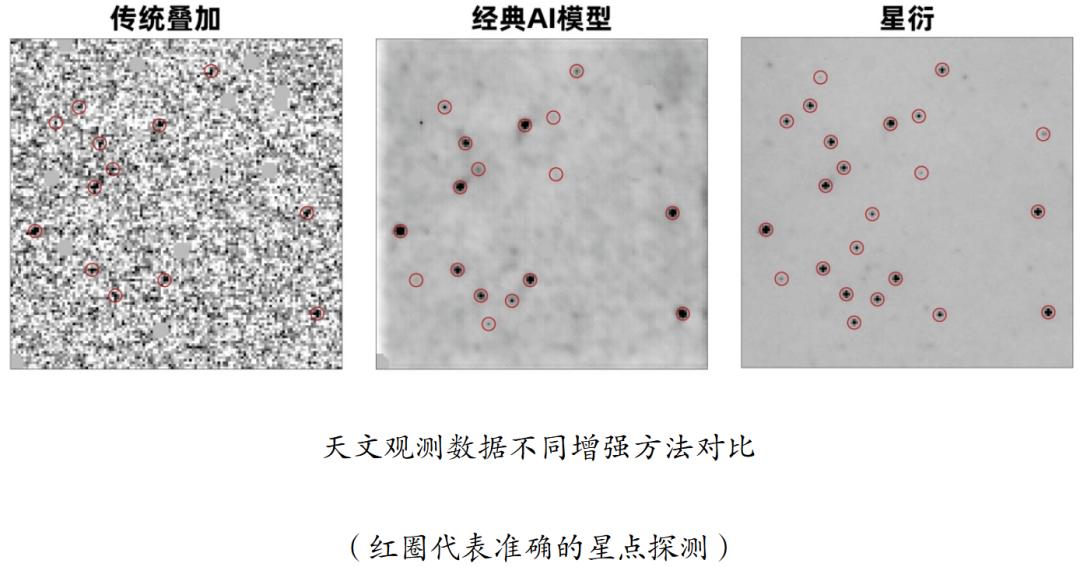
星衍方法的核心在于独特的光度自适应筛选机制。它不再单纯将背景噪声视为随机干扰,而是对噪声的涨落与星体本身的光度进行联合建模。即使信号极其暗弱,信号与噪声在时空分布中的数学期望仍存在显著差异。星衍无需复杂的物理建模,直接利用带有真实噪声的海量真实数据进行训练,即可高保真地还原目标信号。
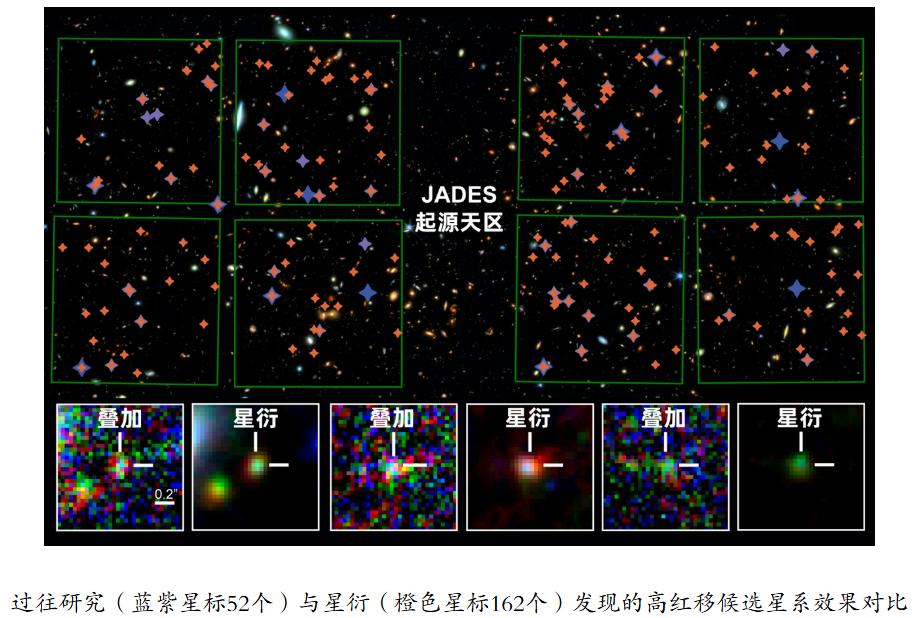
依托这一技术,研究团队在韦伯空间望远镜的深度观测数据中,发现了超过 160 个宇宙早期的候选高红移星系。这些星系存在于宇宙大爆炸后仅 2 至 5 亿年的“宇宙黎明”时代。
星衍的强大之处在于泛化能力。它已成功应用于詹姆斯·韦伯空间望远镜和昴星团地面望远镜,覆盖的波段范围从可见光延伸到中红外。这标志着它不仅能解码空间望远镜的尖端数据,更可兼容多元探测设备,成为通用的深空数据增强平台。
Top6. 🏥 MedOS:全球首个医学世界模型,AI 终于开始理解人体
如果说大语言模型让 AI 学会了“聊天”,那么 MedOS 则让 AI 开始理解人体本身。
斯坦福、普林斯顿与 NVIDIA 联合发布的 MedOS,是全球首个通用医疗具身世界模型。它深度融合感知、推理与物理交互能力,覆盖临床诊断、外科手术、药物研发等全链条,使 AI 真正理解并作用于人体生理与疾病演化的物理现实。
MedOS 的核心是 MedSuperVision 数据集——由持证外科医生策划、包含 85,398 小时多样化手术视频和高质量注释的最大开源手术视频数据集。基于这个数据集,MedOS 实现了 XR-Robot-Human 三方协作:消除人手颤抖和漂移,实现手术精准度;通过沉浸式 XR 反馈,让操作者直观控制机械臂。
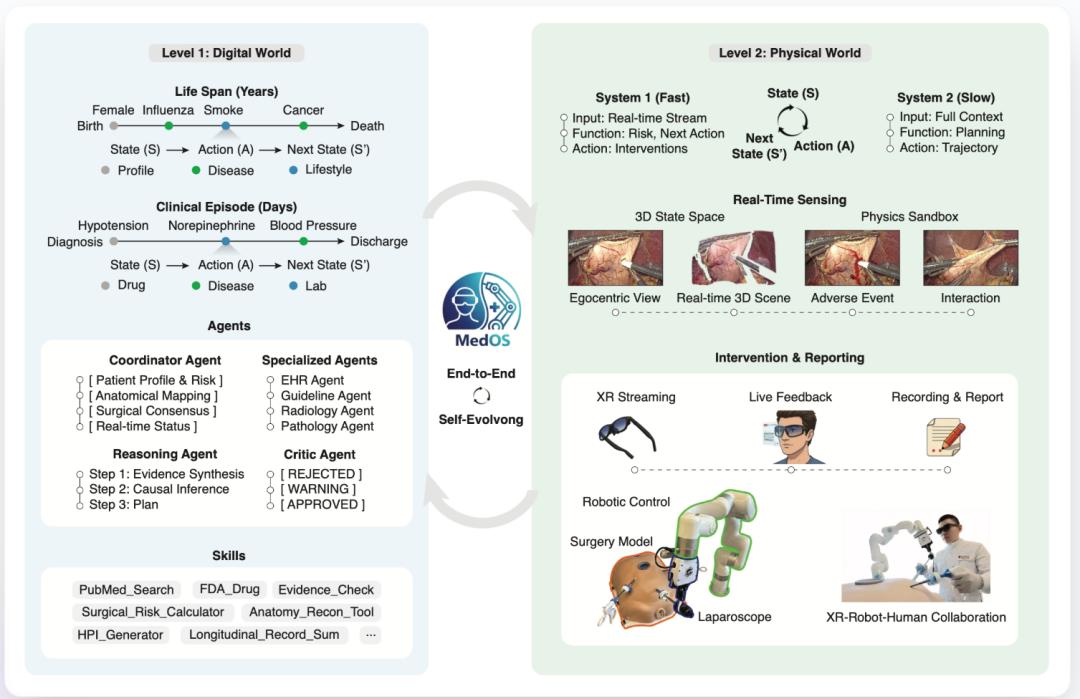
这标志着医疗 AI 从文本推理迈向具身智能的新阶段。过去,AI 医生只能“动嘴”给出诊断建议;未来,AI 医生可以“动手”参与手术操作。
Top7. 🔬 DeepRare 登 Nature:AI 医生助力罕见病诊断
罕见病诊断是全球医学界面临的重大挑战。全球有超过 7000 种罕见病,患者平均需要经历 5 年以上的“诊断奥德赛”,才能找到真正的病因。
本周发表在 Nature 上的 DeepRare 系统,为这个难题提供了一个有力的解决方案。
DeepRare 是一个基于大语言模型的多智能体系统,能够处理包括自由文本临床描述、结构化人类表型本体术语和基因检测结果在内的异质性患者输入。它生成排名候选诊断列表,每个诊断都配有透明的推理链,直接引用可验证的医学证据。
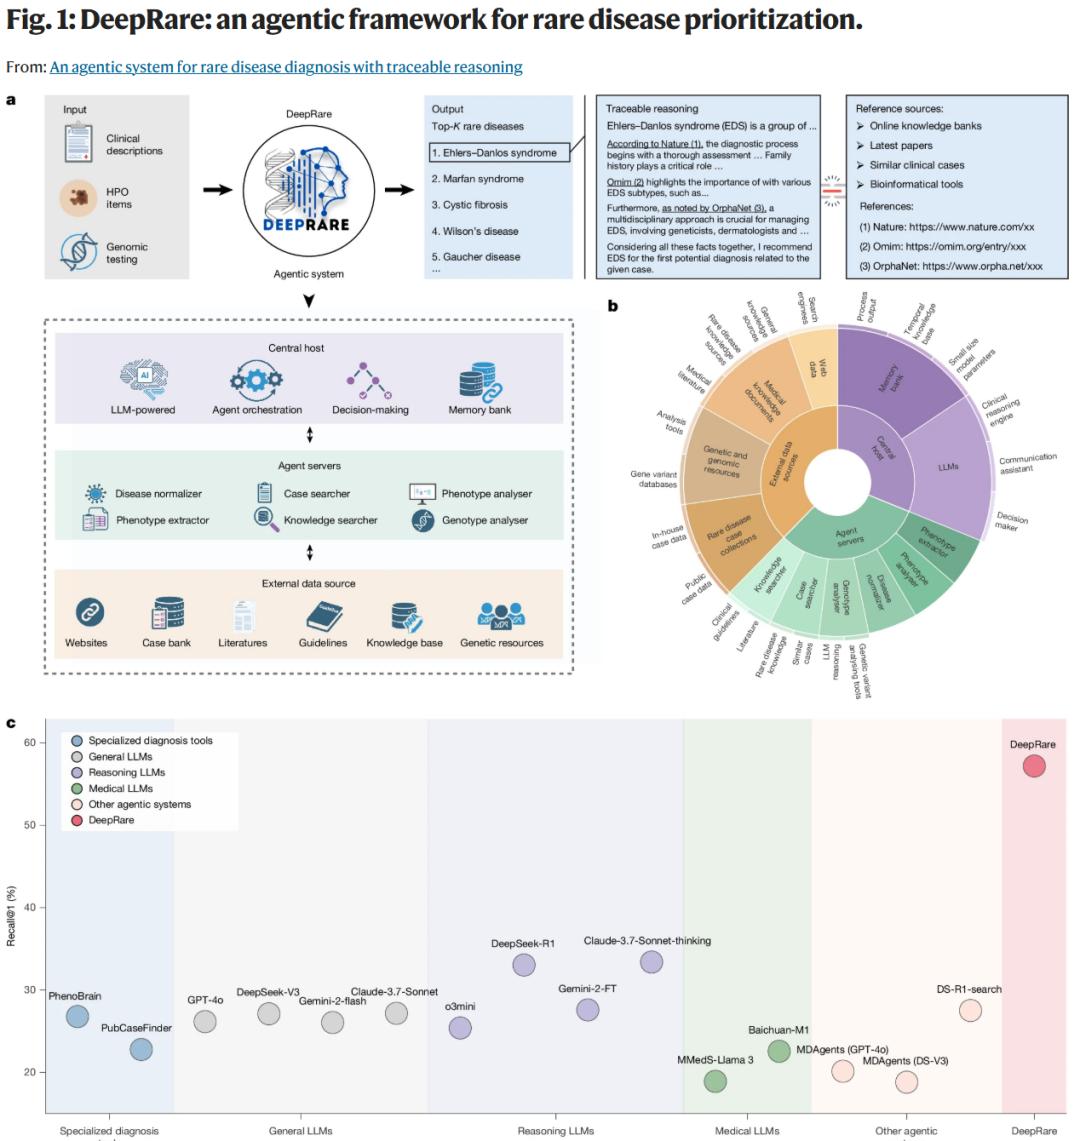
在涵盖 14 个医学专科、2919 种罕见病的 6401 例临床病例评估中,DeepRare 在 HPO(人类表型本体)分析中的 Recall @1 达到 57.18%,比第二名高出 23.79%。在多模态输入场景(结合 HPO 和基因数据)中,Recall @1 更是达到了 69.1%,显著优于传统生物信息学工具 Exomiser 的 55.9%。
更值得关注的是,研究团队邀请十位罕见病专科医生验证了 DeepRare 生成的推理链。结果显示,DeepRare 在证据事实性方面的准确率达到 95.4%,与临床专家高度一致。
Top8. 🧠 强化学习之父泼冷水:大模型只是一时狂热
在所有关于 AI 的乐观叙事中,图灵奖得主、强化学习之父理查德·萨顿(Richard Sutton)的声音显得格外刺耳。
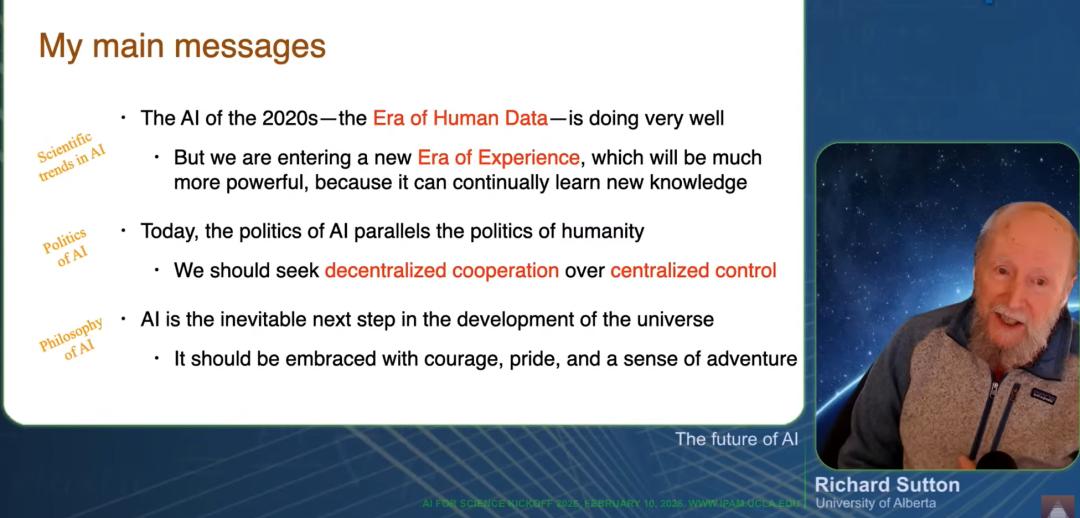
在 UCLA 的最新演讲中,萨顿直言不讳地指出:“当前 AI 的背后,理解很少,调参很多。我们还不知道心智的原理,不知道智能的原理。作为一门科学,它在很多方面是令人不满的。”
他把当下的 AI 模型称为“弱心智”——它们之所以强大,是因为汲取了全人类的知识;但除此之外,它们不可靠,容易跑题,会东拉西扯。“除了拥有大量知识这一点,它们一点也不强大。”
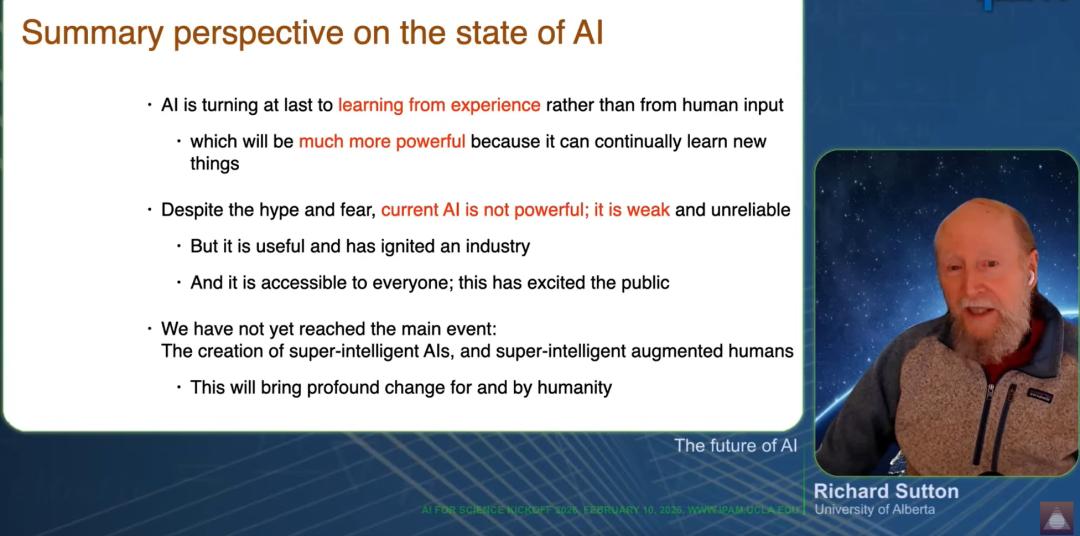
萨顿认为,我们正处在一个“从人类数据中训练”的时代,但正在逼近这个时代的天花板。原因很简单:人类数据快用完了。更重要的是,这种方法无法学到任何真正新的东西,无法产生真正的新知识。
真正的前进方向是什么?萨顿的答案是:从经验中学习的新时代。
“经验方法的核心原则是:智能体与世界交换信号,这些信号是一切智能的基础。真理的定义就在这些信号里,目标的定义也在这些信号里。没有经验,就没有智能存在的根基。”
萨顿把 AI 的发展划分为三个时代:模拟时代(AlphaGo、Atari 游戏)、人类数据时代(大语言模型),以及正在到来的经验时代。他相信,只有经验时代才能真正带来超越人类的能力。
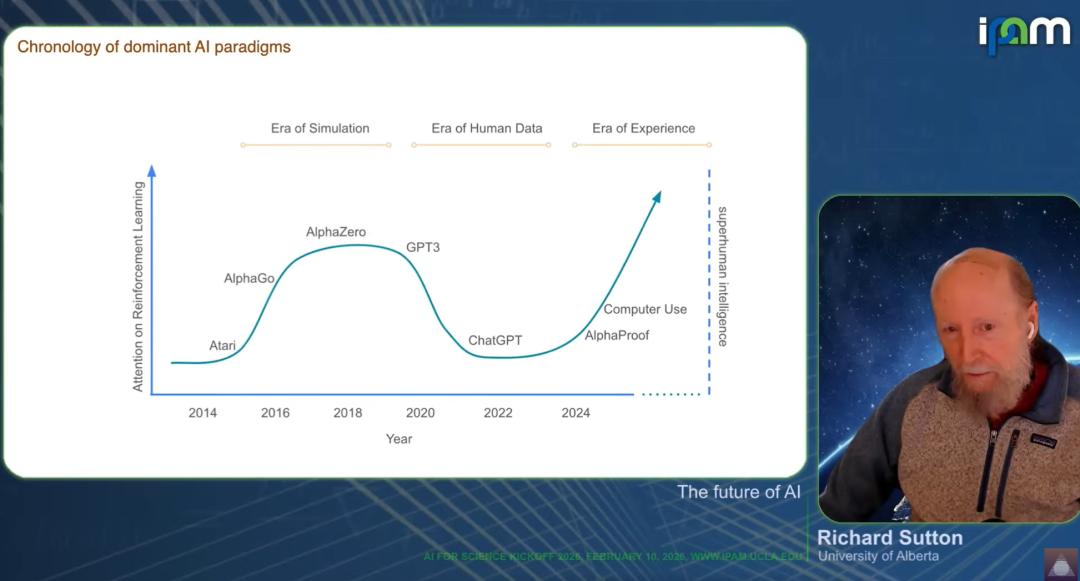
“尽管今天有那么多炒作甚至恐慌,我觉得当前的 AI 并没有那么强大。真正的主角,创造超级智能 AI、创造经过超级智能增强的人类,还没有登场。”
🎯 本周趋势总结:从堆参数到拼效率,从聊天到动手
把这周的进展串在一起看,几条清晰的脉络浮现出来:
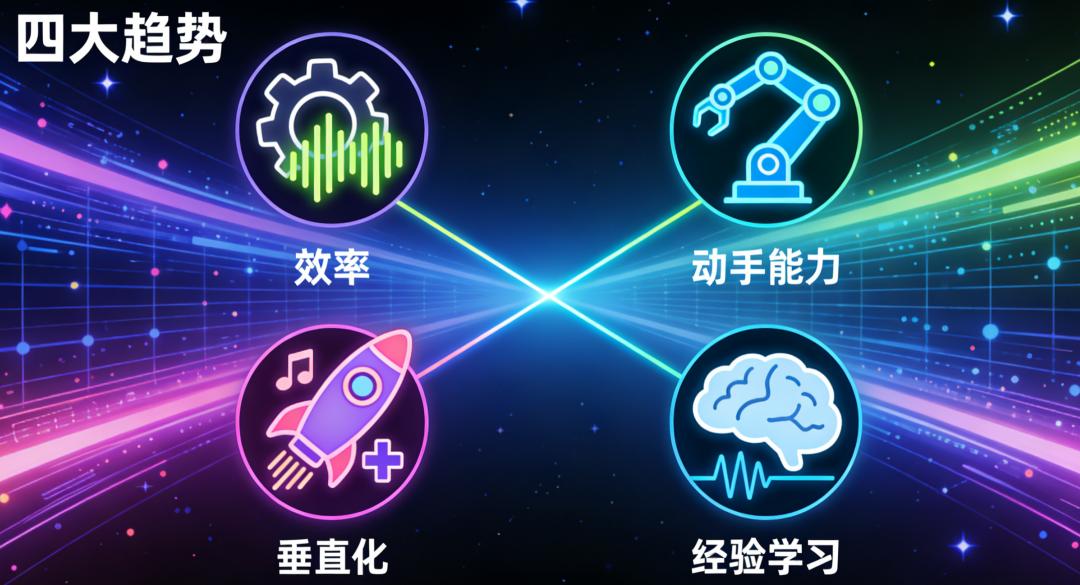
第一,效率正在成为新的竞技场。 Gemini 3.1 Pro 用不到一半的成本实现更强的推理能力,Qwen3.5 用 4.3% 的激活参数实现 8.6 倍的吞吐量提升。大模型的竞争正在从“堆参数”转向“拼效率”,精益分配算力成为新的技术制高点。
第二,AI 正在从“动嘴”走向“动手”。 Claude Code Security 可以自动审查代码,MedOS 可以辅助手术操作,DeepRare 可以给出诊断建议。AI 不再只是聊天工具,而是开始具备实际执行能力。
第三,垂直化正在加速。 谷歌把 AI 音乐塞进 7.5 亿用户的口袋,Anthropic 把 AI 安全工具交给开发者,清华把 AI 成像用于天文观测。通用模型正在快速转化为垂直场景的实际生产力。
第四,经验学习可能是下一个突破口。 萨顿的警告值得深思:人类数据快用完了,大语言模型的天花板正在显现。从经验中学习、持续自我进化的 AI 系统,可能是通往更高智能的必经之路。
看完这周的 AI 进展,你最看好哪个方向?如果你觉得这篇文章有用,欢迎点赞、转发,让更多人看到 AI 世界的精彩。我们下周见。
参考资料
• 谷歌 Gemini 3.1 Pro 官方博客
• Qwen3.5 技术博客
• Anthropic Claude Code Security 公告
• 谷歌 Gemini AI 音乐生成功能
• 清华大学“星衍”模型研究成果
• MedOS 医学世界模型
• DeepRare 罕见病诊断系统 - Nature
• 强化学习之父 Richard Sutton 演讲