FinMTM:多回合多模态金融推理和智能体评估基准
“FinMTM: A Multi-Turn Multimodal Benchmark for Financial Reasoning and Agent Evaluation”
【 扫描文末二维码加入星球获取论文,源码 】
摘要
现有金融基准多单轮、问题格式单一。为此提出多轮多模态基准 FinMTM,数据上整理 11,133 个基于金融可视化的中英双语金融问答对;任务上涵盖多种题型。还设计了特定评估协议。实验显示 22 个 VLMs 存在多方面局限。
简介
大语言模型和视觉-语言模型(VLMs)发展影响多行业,金融领域多专业图表,其复杂任务对VLMs提出挑战。现有金融基准如MME-Finance等评估VLMs有局限:多单轮评估,未系统评估综合能力,忽视金融智能体行为。
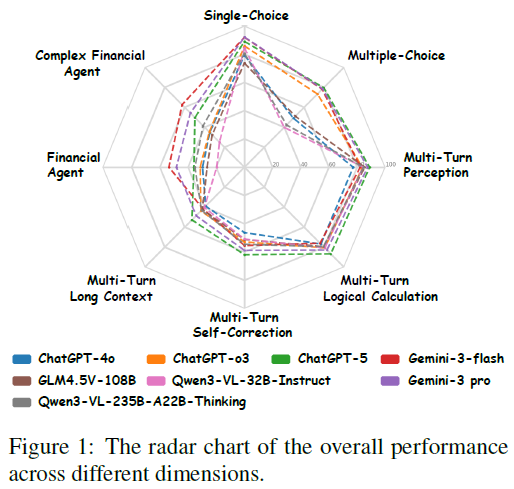
为弥补差距,推出综合金融多模态基准FinMTM,开展对比实验揭示性能差距。构建超10000样本的中英双语基准,涵盖多种题型和任务。设计多维度评估框架。评估22个VLMs,指出性能瓶颈。
相关工作
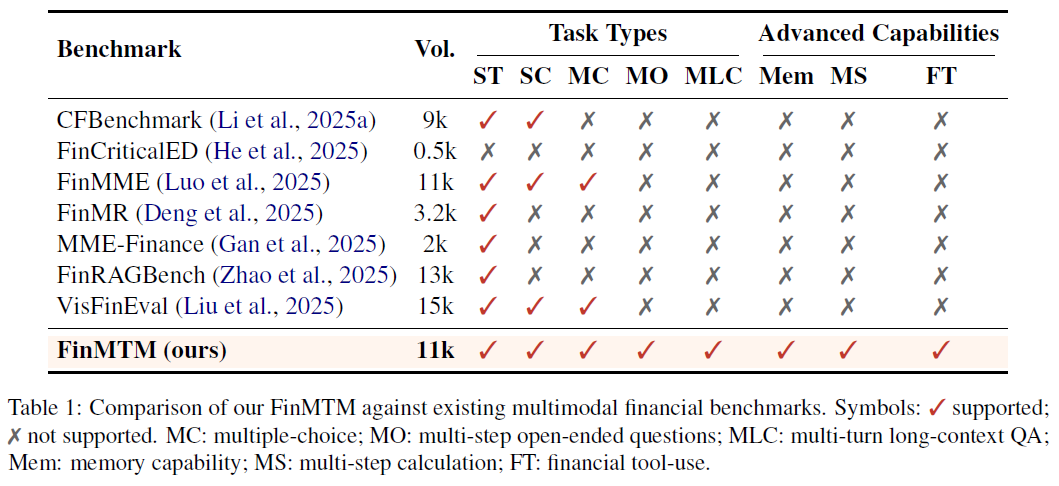
近期出现一系列金融多模态基准用于系统评估金融领域下一代视觉语言模型(VLM)的视觉 - 语言能力,发展轨迹从单轮图表感知到知识密集型推理。早期如 MME-Finance 等主要构建基于图表和报告截图的单轮问答任务,聚焦图表解读等能力评估,但交互范式局限于单轮问答。随后 FinMR 转向知识密集型高阶推理,FinRAGBench-V 纳入多页 PDF 文档评估,VisFinEval 基于业务流程组织样本强调情景理解和决策支持。现有金融 VLM 基准主要关注单轮任务,对多轮可靠性和长上下文推理洞察有限,智能体能力评估不足。为此提出 FinMTM 框架,评估客观问答、多轮对话和工具增强智能体任务。
FinMTM基准
任务定义
将所需金融能力组织成三个代表性评估任务:客观题(含单选、多选)、开放式问题(多轮设置,分理解、计算、自我纠正、记忆四个子任务)、金融智能体(提供MCP工具支持工具调用和规划),构成从基础感知到交互决策和智能体行为的渐进式评估框架,任务有中英双语版。
数据集构建
数据整理:构建 FinMTM 时,从宏观经济与行业研究报告、个股研究报告、公司财务数据、金融媒体图像四个渠道收集美中股市真实数据。
客观问题生成:先精心挑选 1982 个单轮问答对作为高质量种子集,经专家验证为基准;用 Gemini 3 Pro 为种子问题生成干扰项构建单选题;采用负选范式构建多选题,降低猜对概率。
开放式问题生成:用 Gemini 3 Pro 按渐进复杂度原则构建专家级多轮交互,将子任务分为四个递进级别;先自动化统一结构、难度和评估目标,再人工细化使对话自然,模拟真实金融工作流程。
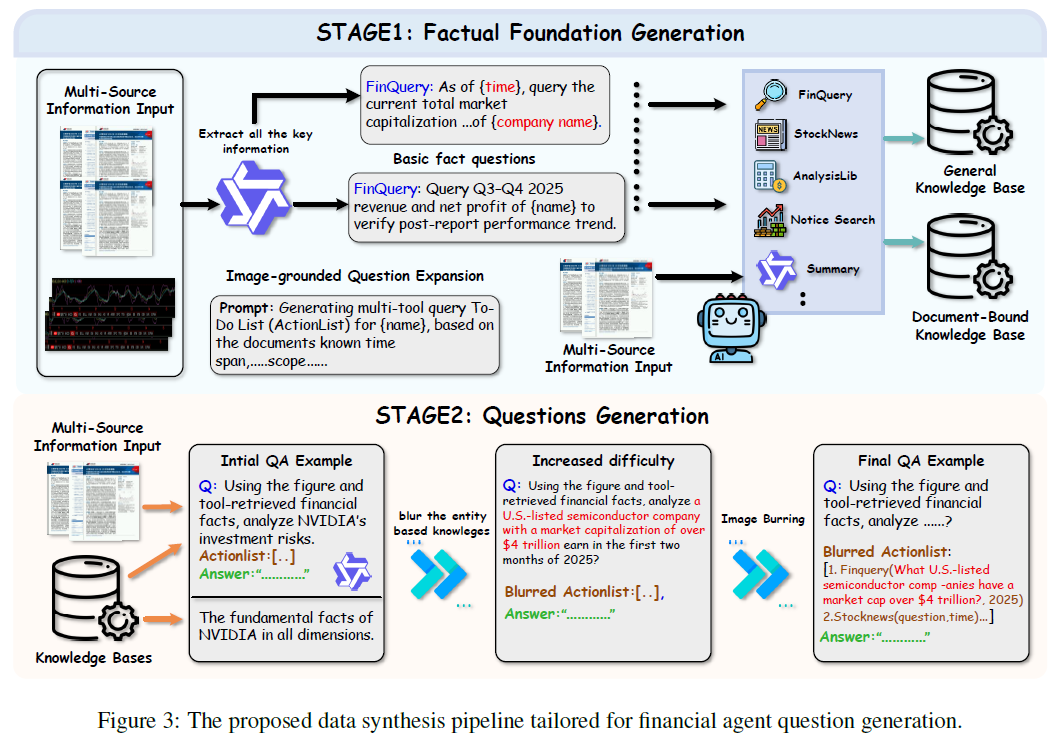
金融机构数据生成:为构建含参考工具调用和真实答案的智能体评估数据集,设计两阶段数据合成流程:先建通用知识库 K1(含跨公司和时间的基础金融事实,支持按公司实体索引检索)和文档相关知识库 K2(含与文档内容相关的金融事实知识);再基于图像和知识库生成初始问答对,用模糊策略混淆实体先验(用知识库替换问题中特定实体),最后检查视觉内容并屏蔽关键信息(如公司名)。
数据集统计
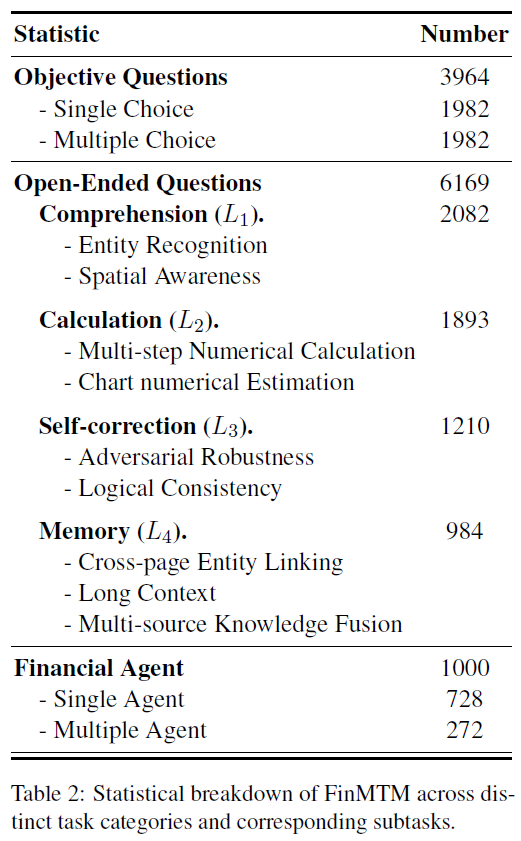
该基准包含三大主要任务,共11133个问题,涉及3600张图像和400个PDF,涵盖美、中A股多行业股票,反映多样金融场景。客观题含1982道单选和1982道多选,考查模型对金融多模态信息的基本理解;开放式问题有6169个样本,平均交互4.25轮、输入4963个令牌;金融智能体任务1000个样本均需外部金融工具,约73%用单工具多次调用完成,27%需多工具,反映真实金融分析决策流程。
综合财务评价
为客观题、开放式问题和金融智能体三个不同任务提供量身定制的评估框架,框架稳健性经人类一致性实验验证。
客观问题评价
采用集合重叠计分规则处理单、多选题。每题有真实答案集 Gi 和模型预测答案集 Pi ,均为候选选项集 O 的子集。计分公式见 (1),执行严格的不超选规则,选错误项得零分,否则按比例给部分分数,单选题是 ∣Gi∣ = 1 的特殊情况。
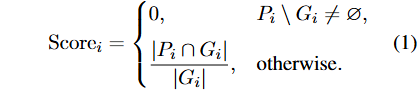
开放式问题评估
本文呢提出双规则评估策略,从回合和会话层面评估模型性能。
回合级评估:对多轮对话中每轮回复按视觉精度、财务逻辑、数据准确性、跨模态验证、时间意识五项金融能力评估,得出每轮能力得分向量,再聚合为回合级得分,各能力权重均为 0.2。
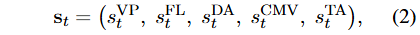
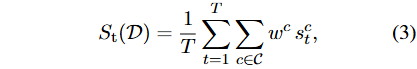
会话级评估:构建数据集时为每个会话标注任务类型,根据对应清单对整个会话评分。
总体得分:将回合级和会话级评估统一,最终对话得分是两者加权组合,α 取 0.5 平衡两者。
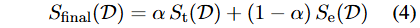
财务智能体评估
本文提出金融多模态智能体基于轨迹的两阶段评估框架,评估其多步、多维度交互。
规划阶段:模型输出指定工具调用路径的结构化轨迹,用基于功能对齐的召回导向 Fβ 分数量化工具使用质量,计算 Precision 和 Recall,得出工具使用质量得分 Qt(范围 [0, 25])。
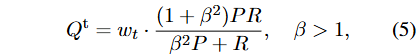
总结阶段:模型综合规划轨迹和工具返回信息生成最终答案,在证据约束下评估推理质量 Qr(范围 [0, 25])和答案正确性 Qa(范围 [0, 50]),最终得分
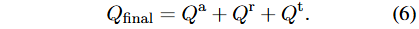
实验
实验设置
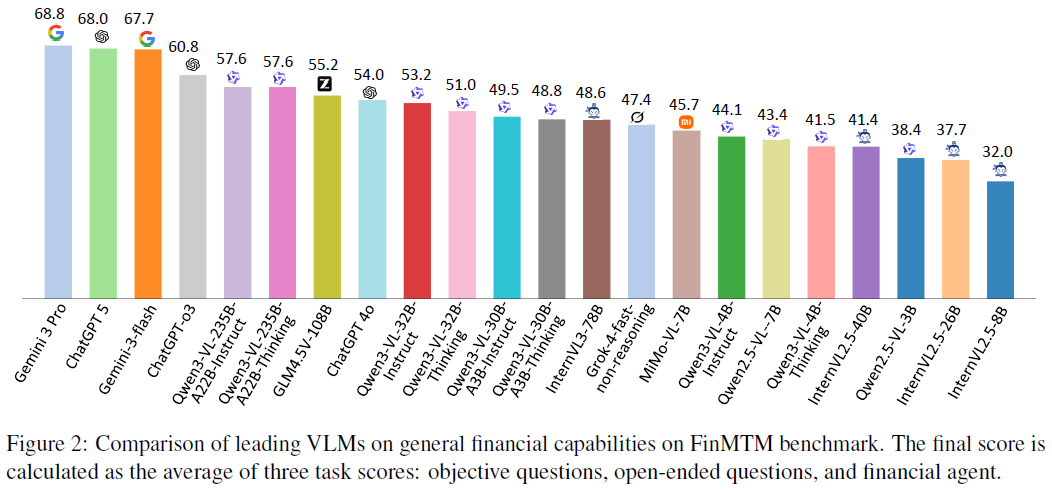
评估 22 个视觉语言模型(VLMs),含专有和开源系统。专有模型有 OpenAI 的 ChatGPT 系列、Google 的 Gemini 3 系列及 xAI 的 Grok-4-fast-non-reasoning;开源模型包括 InternVL 系列、Qwen 家族,还有 MiMo-VL-7B 和 GLM4.5V-108B 以丰富模型多样性。
结果
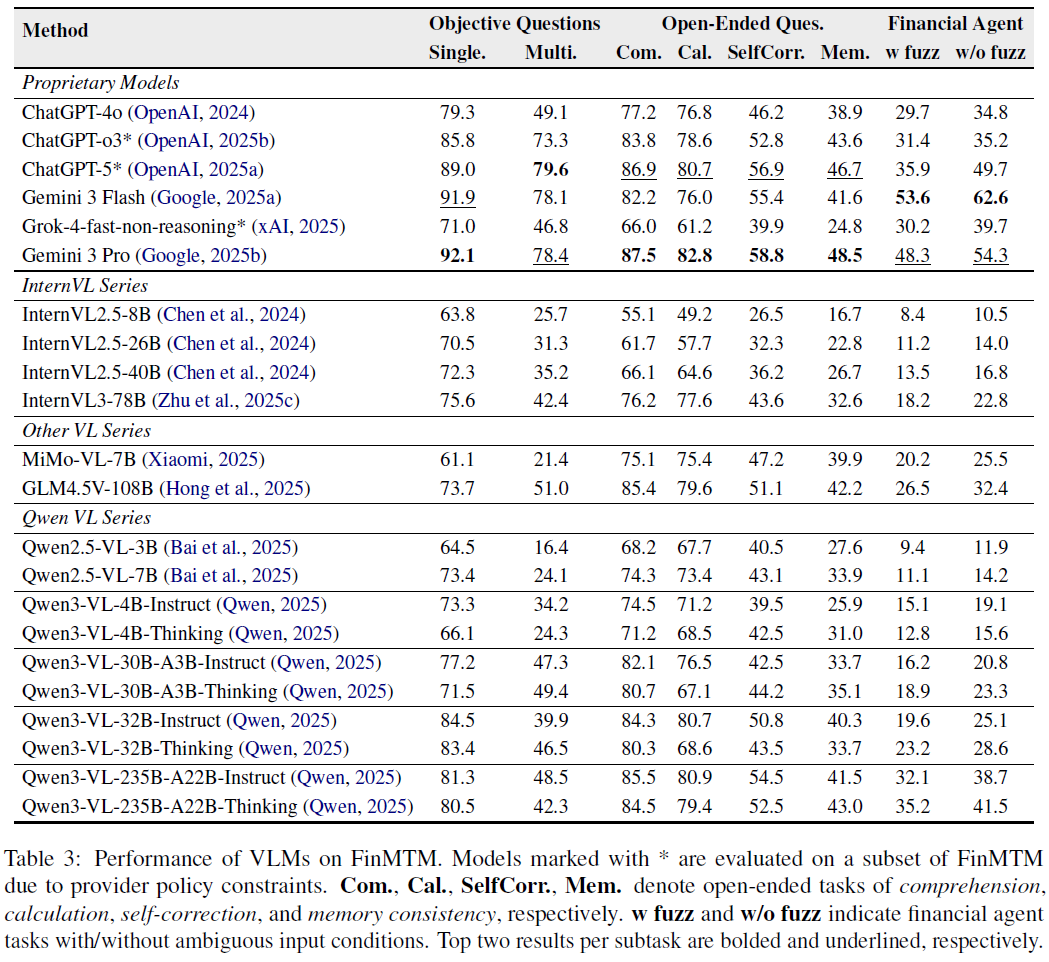
专有模型在多数维度上优于开源模型。
各专有模型表现:Gemini 3 Pro 在开放式任务中出色,如理解、计算等;ChatGPT - 5 多选问题表现最佳,开放式问题排第二;Gemini 3 Flash 在金融智能体任务得分领先。
开源模型局限:在开放式问题和金融智能体任务与专有模型差距明显,在自我修正、记忆密集型开放式任务及多步推理、工具使用环境中表现不佳,如 Qwen3 - VL - 32B 系列。
分析
任务复杂度对模型性能的影响:开放式问题实验显示,随任务复杂度从L1-L4提升,多数模型性能下降。模型在L1(Com.)和L2(Cal.)基础水平表现好,如Qwen3-VL-32BInstruct得分高;L3(SelfCorr.)和L4(Mem.)性能显著降低,长上下文复杂推理是挑战,如Gemini 3 Pro在L4得分48.5,InternVL2.5 - 8B仅16.7。
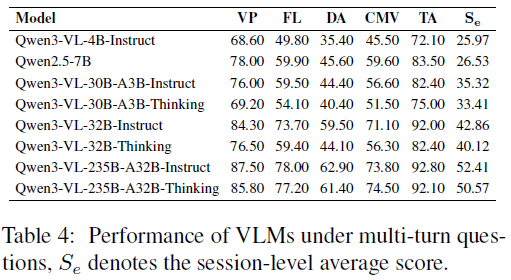
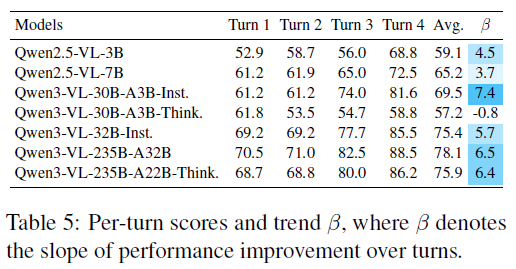
轮次得分详细分析:轮次表现中,模型在视觉精度和时间感知方面强,但金融逻辑、数据准确性和跨模态验证弱,表明视觉感知能力强,复杂逻辑推理待提升。多数VLM受益于扩展交互,能修正错误。
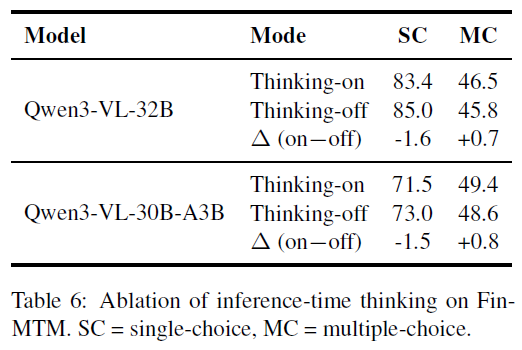
“思考”模式的性能提升:“思考”和“指令”变体存在任务依赖的权衡。“思考”模式在高熵任务(如金融智能体任务)提升性能,在低层次感知任务略有下降,低熵单选题禁用“思考”有小提升,高熵多选题启用“思考”表现更好。
错误分析:对低得分多轮实例进行分析,L1 错误源于初始对关键数字或实体误判且未依视觉证据复核;L2 失败主因是变量值错绑、参考框架不明或单位/尺度不一致;L3 挑战在于后续轮次引入外部事实或改变前提时未修正先前假设;L4 失败多因多页文档证据支撑不足,检索困难且会编造细节。
专家验证:由 15 位金融专家和学术研究者验证数据集,开展人类对齐实验验证开放式问题评估准确性。
限制
FinMTM存在局限:
一是开放式评估部分依赖LLM评判,有主观性且受提示设计影响,提升评判稳健性和校准是后续方向;
二是金融智能体设定假定工具和参考轨迹固定,现实工具生态更广泛且动态变化;
三是长文档任务约束严格,可能低估实质正确但未遵循协议的回答能力,未来版本可加强自动验证、扩大工具覆盖。
总结
本文介绍FinMTM多轮多模态基准用于评估视觉语言模型(VLMs)金融推理与工具使用能力,对前沿VLMs评估发现其在长轮次一致性、多文档金融推理和结构化金融规划方面存在不足,未来将基于基准洞察开发更强大的金融VLMs,提升长上下文推理、证据关联和工具驱动决策能力。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
