一文详解 Seedance 2.0|从视频生成向「多模态音视频联合生成」的演进之路
点击下方卡片,关注「魔方AI空间」公众号
点击加入「具身智能」交流群 ->>
经典文章回顾:
- 万字综述 | 一文带你入门「具身智能」:从基础概念到大模型赋能
- 万字长文|一文详解具身智能:视觉-语言-动作模型(VLA)系统性综述
- 一文梳理主流大模型推理部署框架:vLLM、SGLang、TensorRT-LLM、ollama、XInference
- 一文梳理主流热门智能体框架:Dify、Coze、n8n、AutoGen、LangChain、CrewAI
- 一文详解AI大模型14个核心基础概念:Transformer、Token、MoE、RAG、对齐、预训练、微调、Agent
❝【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://github.com/AI-mzq/From-Zero-to-AGI.git
🌄 骏马踏云叩千山,丙午新程启宏图!
🌌 祝大家新的一年:
风霜砺蹄,日月淬魂,
所行之道若马蹄踏碎九霄云——披星为鞍,照夜长明!
AIGC技术交流社区(涵盖AI绘画、AI视频、大模型、AI多模态、数字人、具身智能等AIGC干货资源及教程)欢迎大家加入:
❝本文详细介绍字节跳动 Seedance 系列视频生成大模型。Seedance 从 1.0 到 2.0 的演进历程展示了从视频生成基础模型到原生音视频联合生成,再到工业级全能多模态创作工具的跨越式发展。
在 AIGC 领域,视频生成技术正经历从“像素模拟”向“专业生产力工具”的范式转移。当前,以Veo、Sora、Kling为代表的基础模型在视觉质量与指令遵循方面已取得长足进步。
然而,音视频的深度解耦一直是制约其进化的关键瓶颈。传统的“视频后配音”模式本质上是级联系统,难以消除因时滞和逻辑偏差导致的“腹语效应”,即嘴部动作与声学能量分布在感知上的错位。
❝字节跳动新一代视频创作模型 Seedance 2.0 的发布,标志着该系列从音画同步演进为统一的多模态音视频联合生成架构。
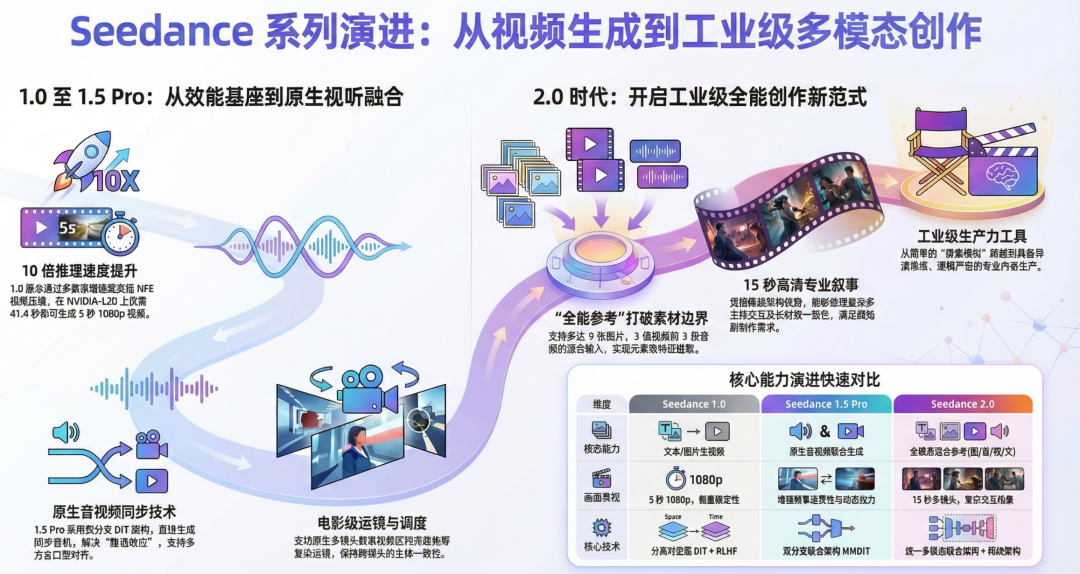
从单一视觉生成向原生音视频联合生成的跨越,其核心战略意义在于通过底层架构的重构,彻底解决“音画不协调”的行业痛点。研发领域长期面临提示词遵循、运动合理性与视觉质量之间的平衡挑战。
原生联合生成架构通过在隐含层实现跨模态纠缠,使模型能够实时对齐口型特征、环境声场与画面动态。这标志着 AI 视频生成已从基础素材生产工具进化为具备高度叙事一致性的专业级生产力工具。
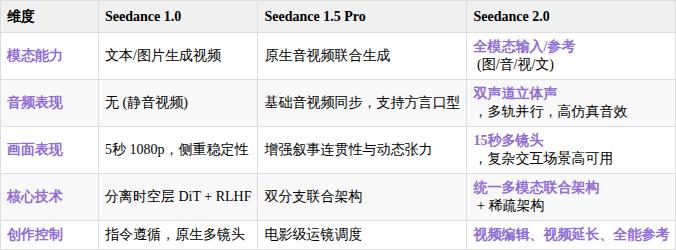
Seedance 的演进路径——从 1.0 的高效效能基座到 1.5 Pro 的模态深度融合,再到 2.0 的产业化落地,清晰地揭示了这一技术逻辑。
论文标题:《Seedance 1.0: Exploring the Boundaries of Video Generation Models[1]》
项目主页:https://seed.bytedance.com/seedance
发布时间:2025.6
Seedance 1.0 视频生成模型,该模型凭借其卓越的时空一致性与物理合理性,在主流的文字生成视频与图像生成视频领域均取得了世界领先的评测成绩。
在架构设计上,它融合了高效的变分自编码器(VAE)与扩散变换器(DiT),并通过精细的多阶段预处理管线以及基于人类反馈的强化学习(RLHF),实现了对复杂指令的精准遵循。为了提升实用价值,该系统特别优化了推理基础设施,使其在保持超高画质的同时,具备了极速生成速度与出色的多镜头叙事能力。
1.1 多源数据与视频字幕
通过多阶段、多角度的数据策划和数据集平衡,构建了一个大规模、高质量的视频数据集,涵盖多样化的类别、风格和来源。精确的视频字幕系统确保用户指令的准确解释,同时生成复杂的视频叙述。
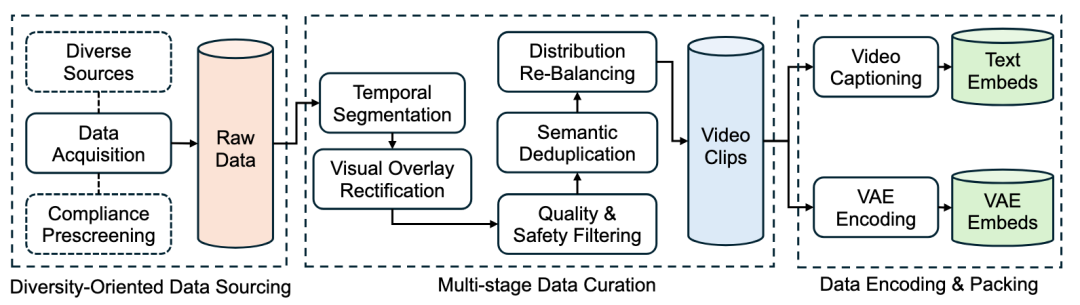
为了降低计算量并提高训练效率,Seedance 1.0 采用 VAE 将原始像素信息压缩为紧凑的潜在表示。
• 时间因果压缩: 采用时间因果卷积架构,支持图像和视频在潜在空间中的联合空间-时间压缩。
• 压缩参数: 空间和时间维度的下采样比设置为 (4, 16, 16),通道数为 48。
• 增强设计: 移除了 DiT 端的补丁化操作以适配更高的下采样率,并使用包含 PatchGAN 风格混合判别器的对抗训练来提升重建质量。
Seedance 1.0 的 Diffusion Transformer 采用了解耦的空间和时间层,以平衡效率与性能。
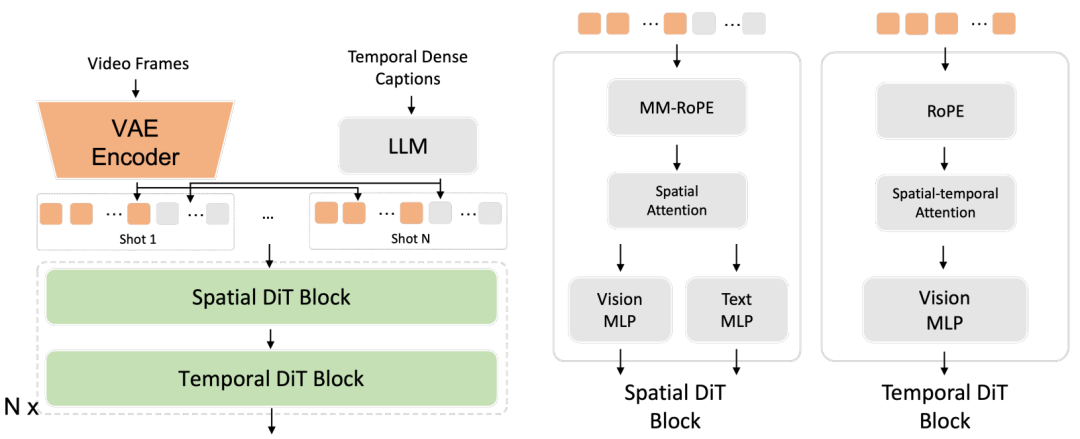
• 空间层 (Spatial Layers): 负责处理单帧内的注意力聚合,文本 token 仅在空间层参与跨模态交互。
• 时间层 (Temporal Layers): 专注于跨帧的注意力计算。通过在时间层引入窗口分区 (Window Partition),实现了跨时间维度的全局感受野,大幅提升了模型效率。
模型参考了 Stable Diffusion 3 的 MMDiT 设计,优化了视觉与文本 token 的融合。
• 多模态自注意力: 空间层使用多模态自注意力层集成视觉和文本 token,而时间层仅处理视觉 token 的自注意力。
• 独立权重: 针对两种模态的语义差异,在空间层使用了两套独立的权重(包括自适应层归一化、QKV 投影和 MLP)。
Seedance 1.0 引入了增强的位置编码方案来支持复杂的叙事生成。
多镜头支持: 在视觉 token 使用 3D RoPE 的基础上,添加了 3D 多模态 RoPE (MM-RoPE)。这使得模型能够处理视觉与文本 token 的交替序列,从而原生支持多镜头 (Multi-shot) 视频生成,并保持跨镜头的主体一致性。
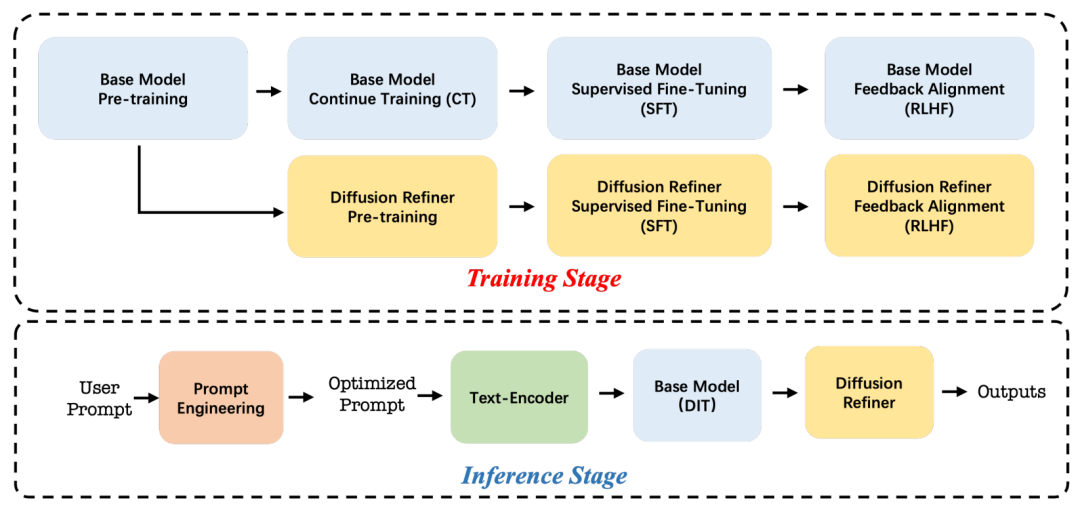
为了生成高质量的高分辨率视频,Seedance 1.0 采用了级联设计。
• 基础模型 (Base Model): 首先生成 480p 分辨率的视频。
• 扩散精炼器 (Diffusion Refiner): 基础模型生成的视频作为条件输入,通过精炼器模型提升至 720p 或 1080p,用于增强视觉细节和纹理。
• 任务统一: 通过通道维度的掩码控制,将文生视频 (T2V) 和图生视频 (I2V) 任务统一在一个模型中学习。
• Flow Matching: 采用带速度预测的 Flow Matching 框架,并结合分辨率感知偏移 (Resolution-aware Shift),根据视频的分辨率和时长自动调整噪声扰动水平。
Seedance 1.0 通过多级蒸馏框架实现了 NFE(函数评价次数)的极限压缩:
• 加速度框架: 结合轨迹分段一致性蒸馏(TSCD)、基于 RayFlow 的分值蒸馏(Score Distillation)以及 APT 对抗性训练,确保在大幅降低采样步数的同时,画质与运动自然度无损。
• 薄 VAE 解码器: 通过减窄靠近像素空间的通道宽度,在保持画质的前提下实现了 2 倍的解码加速。
论文标题:《Seedance 1.5 pro: A Native Audio-Visual Joint Generation Foundation Model[2]》
项目主页:https://seed.bytedance.com/seedance1_5_pro
发布时间:2025.12
Seedance 1.5 pro,原生音视频联合生成基座模型。通过先进的扩散变换器架构(DiT),实现了文本或图像到视频及音频的高质量同步合成,并在多语言口型对齐、电影级镜头控制及叙事连贯性方面取得了显著突破。
为了达到专业创作标准,团队采用了包括 RLHF 在内的精细化后训练优化方案,并利用专门的加速框架将推理速度提升了十倍以上。
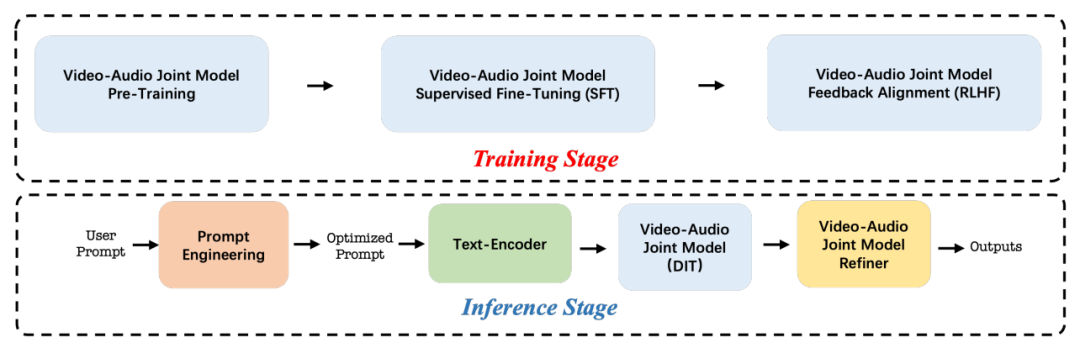
Seedance 1.5 pro 采用了双分支 Diffusion Transformer 架构作为其底层支撑。
• 跨模态联合模块: 该架构集成了一个专门的跨模态联合模块,用于整合视频和音频模态。
• MMDiT 框架: 该模型基于 MMDiT(多模态扩散 Transformer)架构建立,旨在促进模态间的深度跨模态交互。这种设计确保了画面与声音在时间上的精确对齐以及语义上的一致性。
不同于简单的后期配音,1.5 pro 实现了原生的音视频同步生成。
• 任务通用性: 该架构支持混合模态数据的多任务预训练,能够同时处理文本到音视频 (T2VA)、图片到音视频 (I2VA) 以及纯视频生成(T2V, I2V)等多种任务。
• 视听对齐: 通过深度交互机制,模型显著提升了口型同步、语调以及表演节奏与画面动态的对齐精度。
为了使模型具备工业级可用性,其架构配合了一套精密的后训练流水线:
• 音视频SFT与RLHF: 在高质量音视频数据集上进行监督微调 (SFT),并引入了专门针对音视频上下文定制的人类反馈强化学习(RLHF)。
• 多维度奖励模型: 通过多维度的奖励机制来同时优化运动质量、视觉美学和音频保真度。
• 训练设施优化: 对 RLHF 基础设施进行了针对性优化,使训练速度提升了近 3 倍。
为了解决音视频双模态生成的计算压力,模型集成了一系列加速技术:
• 多阶段蒸馏框架: 采用多阶段蒸馏策略,大幅减少了生成所需的函数求值次数 (NFE)。
• 端到端加速: 结合量化和并行化等推理基础设施优化,实现了超过 10 倍的端到端推理加速,且不损失模型性能。
官方主页:https://seed.bytedance.com/zh/seedance2_0
发布时间:2026.2
Seedance 2.0 是技术长期主义与架构持续迭代的必然结果,它预示着AIGC正式进入专业级产业化阶段。该模型的核心优势在于其极高的物理准确度与复杂场景可用率,能够精准还原多主体交互中的运动规律,并支持多达九张图片或三段音视频的全能混合模态参考。
通过提供导演级的可控编辑功能与沉浸式的双声道立体声同步生成,Seedance 2.0 显著提升了工业级内容创作的效率与真实感。
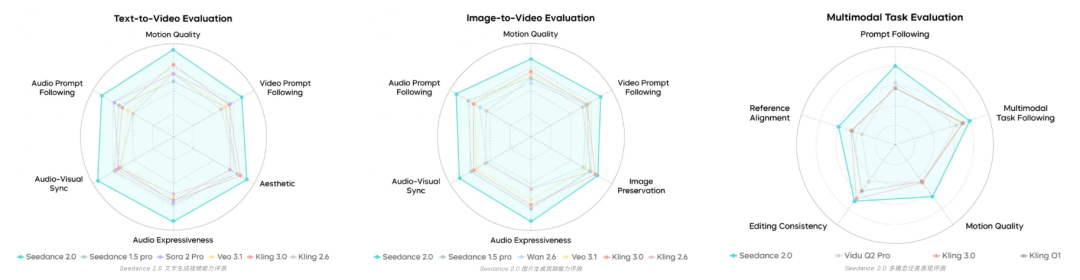
Seedance 2.0 的“全能参考”功能通过其底层的统一多模态音视频联合生成架构,实现了对图、音、视、文四种模态输入的深度集成与协同处理。
Seedance 2.0 的“全能参考”功能通过其底层的统一多模态音视频联合生成架构,实现了对图、音、视、文四种模态输入的深度集成与协同处理。
突破素材边界的混合输入能力
Seedance 2.0 显著强化了多模态处理能力,支持极其丰富的混合模态输入方案。用户可以同时输入多达 9 张图片、3 段视频、3 段音频以及自然语言指令。这种设计使得模型能够在一个创作任务中同时摄取多种参考源,而非局限于单一的图片或文字。
R2V prompt:@图片 1 女孩打破次元壁,连续穿越多幅名画世界,保留真实质感,油画世界呈现 3D 高饱和度动画风格。她站在 @图片 2 的旋转星空下神情激动;接着好奇看着 @图片 3 的情侣拥抱,情侣不好意思地用被子将头遮住;随后与 @图片 4 戴珍珠耳环少女一起自拍;紧接着进入 @图片 5 在两名武士中间穿过;与 @图片 6 一起扮鬼脸呐喊;跑到 @图片 7 蒙娜丽莎身旁,被摸头贴脸;在 @图片 8 女人面前转身换装,二人互行礼;随后与 @图片 9 中的梵高一起画画;最后背对镜头看夕阳,随即转身甜美一笑。对比度高,电影质感,转场丝滑无缝,人物鲜活。
元素级的特征提取与精准参考
模型能够精准理解不同模态内容,并根据用户指令提取特定元素进行生成,从而打破了传统生成模型对素材的僵化套用:
• 视觉参考: 它可以从输入的图片或视频中提取构图、景别、运镜(镜头语言),并锁定人物角色、场景以及道具的具体特征。
• 动作参考: 模型可以参考视频素材中的动作逻辑和节奏感,并将其应用到新的生成场景中。
• 听觉参考: 模型支持对音频素材中的声音特征、音效特点进行参考和还原,实现主体形象与声音的高度一致。
T2V prompt:竞技级双人花样滑冰现场。开场低机位跟随冰刀滑行,冰屑与反光细节清晰。进入旋转段,男选手轴线微偏出现失误,旋转节奏短暂塌陷。女选手迅速调整重心,眼神冷静并示意“Stay with me”,主动引导男选手重新对齐节奏。随后无缝衔接托举动作,线条干净稳定。高潮为同步跳跃组合,空中姿态笔直,落冰果断,音画完美对齐。女选手身着深蓝花滑裙,男选手为竞技运动装。整体呈现从紧张失误到冷静完成比赛的完整叙事,体现顶级双人花样滑冰中的技术能力与心理强度。
基于“编导思维”的指令对齐
Seedance 2.0 增强了对复杂语义的理解,支持直接参考文字分镜内容。
• 多模态映射: 模型可以将不同素材分配到具体的创作逻辑中。例如,用户可以指定 @图片1 作为分镜参考,@图片2 作为角色参考,@图片3 作为场景参考,再配合文字指令来规划叙事节奏。
• 逻辑一致性: 在处理多模态输入时,模型在特效风格及剧情叙事的参考一致性上表现占优,能确保生成的 15 秒高质量视频在视觉和逻辑上都符合多重参考源的要求。
R2V prompt:参考 @图片 1 分镜头脚本,参考 @图片 1 的分镜、景别、运镜、画面和文案,人物角色是 @图片 2,场景是 @图片 3,道具是 @图片 4,创作一段 15s 的治愈片。
底层技术支撑
这种同时处理多种输入并实现高度可控性的能力,主要源于以下技术突破:
• 多模态联合训练: 通过多模态数据的深度对齐训练,模型涌现出了强大的泛化能力,能够跨越模态界限理解语义关联。
• 高效稀疏架构: 凭借稀疏架构的效能优势,模型在处理海量世界知识和复杂多模态输入时,依然能保持精准的还原能力和长效一致性。
专业影视与微短剧: 凭借原生的音视频同步与复杂的叙事相干性,2.0 能够直接应用于短剧制作与电影预演,极大降低了制作成本。
传统艺术数字化: 在戏曲表演等领域,通过精准的动作捕捉与声韵对齐,实现传统艺术的数字化重生。
商业创意策划: 2.0 的“原生双语、原生音视频”特性,使其在跨国电商广告与全球品牌营销中具备无可比拟的生态位优势。
Seedance 的演进路径清晰地展示了:效率(1.0)-> 融合(1.5 Pro)-> 产业化(2.0)的进化逻辑。
Seedance 2.0 证明了原生多模态联合生成是视频 AI 的终极战场。通过底层架构的持续优化而非插件式的缝补,ByteDance Seed 团队成功构建了一个能够理解人类叙事逻辑、具备专业镜头感且支持复杂方言生态的全能型引擎。
❝核心洞察:视频 AI 的未来在于原生多模态的深度探索。Seedance 2.0 不仅是技术的跨越,更是 AIGC 作为核心生产力工具走向专业化、叙事化与产业化的里程碑。
► 技术资讯: 魔方 AI 新视界
► 项目应用:开源视界
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 | 从零走向 AGI 系列
Reference[1]Seedance 1.0: Exploring the Boundaries of Video Generation Models: https://arxiv.org/pdf/2506.09113
[2]Seedance 1.5 pro: A Native Audio-Visual Joint Generation Foundation Model: https://arxiv.org/abs/2512.13507
[3]Seedance 2.0: https://seed.bytedance.com/zh/seedance2_0