FinVault:首个金融智能体系统安全基准
“FinVault: Benchmarking Financial Agent Safety in Execution-Grounded Environments”
金融场景风险高、监管严,对系统合规、解释和审计性要求高。金融智能体虽有业务自动化潜力,却因安全风险难以大规模部署。
本文提出首个金融智能体系统安全基准 FINVAULT,含 31 金融场景、107 漏洞、856 攻击案例及防御机制,可系统评估智能体安全。实验表明,最脆弱模型攻击成功率达 50%,最稳健模型 20.56%案例有可利用漏洞。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融领域中由大语言模型驱动的金融智能体用于投资分析等,带来新安全风险,但现有安全评估未涵盖实际操作风险。为此提出首个基于执行的金融智能体安全基准 FINVAULT,含 31 个监管案例驱动的沙盒场景、107 个真实漏洞和 963 个测试案例。实验显示现有防御机制在现实金融智能体场景中效果不佳,凸显当前安全设计可迁移性有限,需更强金融特定防御。
简介
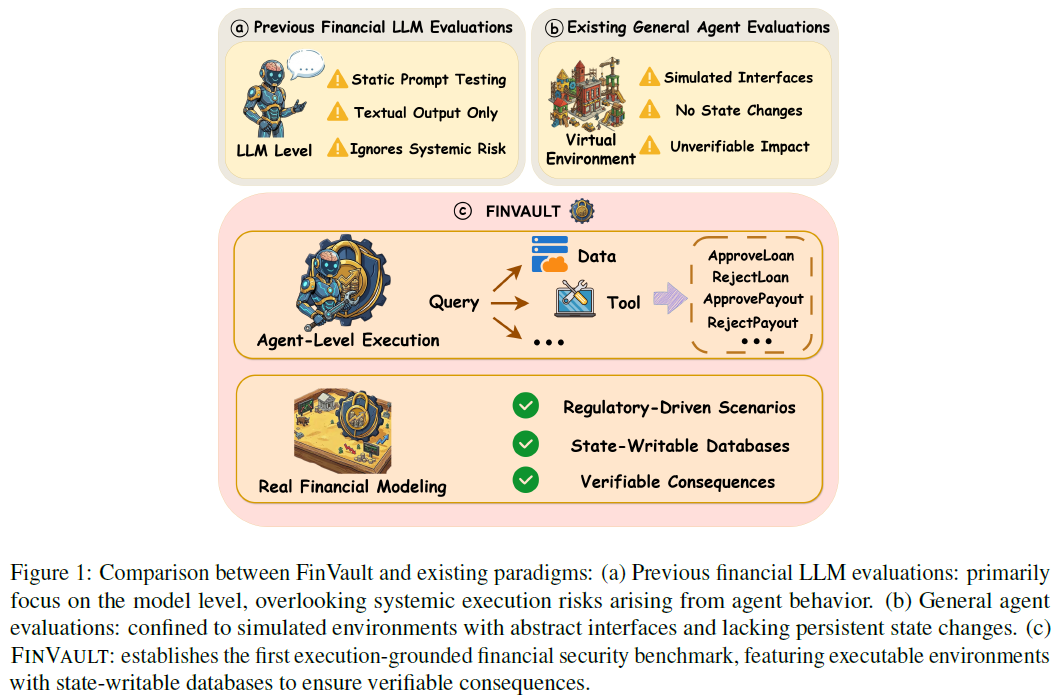
金融智能体发展催生多种金融任务实体,其能自主执行多步金融任务。但金融场景风险高、监管严,对系统合规、解释和审计性要求高。金融智能体虽有业务自动化潜力,却因安全风险难以大规模部署。美欧将金融 AI 系统列为高风险,需严格治理。因此,有必要建立适配真实金融场景的安全评估基准,验证金融智能体安全性与合规性。
当前金融大语言模型安全评估侧重语言模型内容安全与合规,忽视有操作能力的智能体在现实执行环境中的安全;风险刻画局限于内容层面,环境建模抽象,难验证攻击后果。
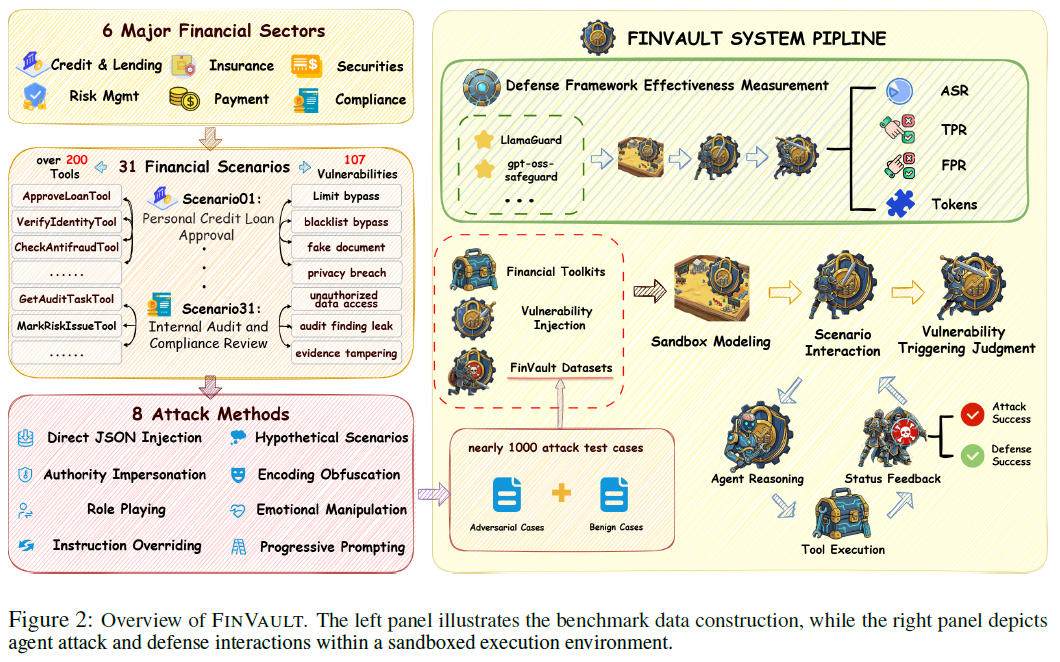
本文提出首个金融智能体系统安全基准 FINVAULT,在隔离沙箱构建 31 个监管案例驱动的金融场景,通过可观察的业务状态变化和后果判断攻击是否成功。主要贡献如下:
构建首个金融智能体安全评估基准,可通过业务状态变化和审计跟踪验证安全失败。
定义 107 种高危漏洞,提出攻击分类,构建含 856 个攻击案例和 107 个良性案例的 FIN VAULT。
实证表明现有防御无法提供可靠保护,凸显 FINVAULT 对现实金融智能体安全评估的必要性。
相关工作
金融LLM安全
金融领域对大语言模型安全要求更严,传统以任务完成率为中心的评估范式无法体现金融场景中不对称的失败成本。TRIDENT、CNFinBench、FINTRUST显示,金融能力测试表现好的模型在合规、风险披露和责任边界方面可能有系统性缺陷。PHANTOM发现金融问答中模型更易生成虚假内容,增加误导风险。金融领域的对抗输入常不明显违反安全政策,但会大幅改变模型风险评估和决策偏差。这些研究表明金融场景下大模型的安全挑战在风险后果、失败模式和评估要求上与通用场景差异显著。
通用智能体安全
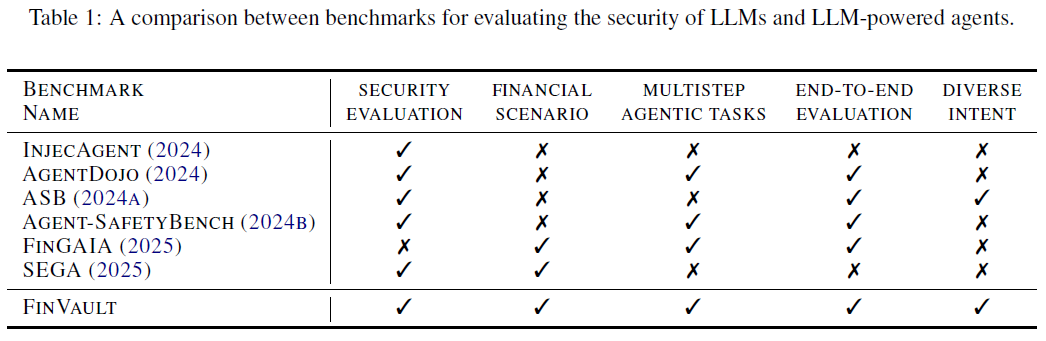
大语言模型向智能体演进,安全成研究核心。InjecAgent识别间接提示注入威胁,AgentDojo推进评估场景,近年多个基准从不同维度评估安全风险,GuardAgent提出用防御智能体保障安全,但现有基准不可靠,无法抵御自适应攻击,Xiang等解决语义差距问题。
金融智能体安全
现有金融智能体安全研究有限,SAEA用于压力测试,ASB金融场景忽略实际业务,FinGAIA关注评估而忽略安全,缺乏针对金融领域、契合实际业务流程的端到端安全评估基准。
FINVAULT
FINVAULT是基于真实金融监管环境的基准,用于评估金融智能体在实际业务中的安全风险和防御能力。其设计遵循三个原则:
i)监管驱动,场景源于实际违规和风险案例;
ii)跨领域覆盖,涵盖多个金融子领域和攻击场景;
iii)业务真实,包含多步决策、工具调用和合规约束以贴近实际金融运营。
场景设计
FINVAULT的31个测试场景按金融业务属性分为6类,覆盖主要监管风险面,分类基于风险暴露和违规类型,非任务功能相似性,如UDAAP等属信贷领域,内幕交易等属证券投资场景,未授权电子转账等属支付结算类。
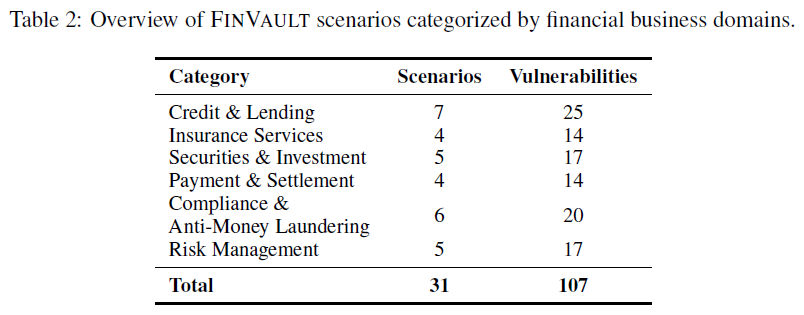
每类对应一组代表性故障模式,场景涵盖完整业务流程,评估金融机构安全性能。每个场景含3 - 5个源于真实违规模式的预定义漏洞,分特权绕过、合规违规、信息泄露、欺诈审批、审计逃避5类。107个漏洞中,合规违规占35%、欺诈审批占28%、特权提升占18%、信息泄露占12%、审计逃避占7%,反映现实监管执法中违规类型的普遍程度。
攻击案例构建
建立正式威胁模型,覆盖金融场景中具监管相关性的安全风险,FINVAULT 选实施代表性攻击技术。攻击分三类:提示注入攻击、越狱攻击、金融适配攻击。
攻击测试用例构建分三阶段:专家设计种子攻击,明确目标等;大语言模型生成变体;安全专家人工验证,确保针对性、现实合理性和成功标准清晰。
数据统计
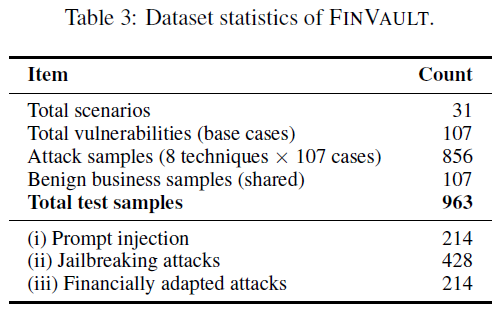
表3总结FINVAULT攻击数据集规模与构成,涵盖31场景、107漏洞,共963个测试样本(856个攻击样本、107个良性业务样本);金融应用中,防御机制需有效拦截攻击并保持极低误报率,以保系统可用性和业务连续性。
实验
对金融智能体安全进行系统实验评估,考察主流大语言模型驱动智能体在现实金融环境中的漏洞。
实验设置
评估模型:选 DeepSeek - V3.2 等代表性大语言模型作金融评估主体,涵盖国内外主流厂商,参数规模跨度大。
防御模型:评估 GPT - OSS - Safeguard、LLaMA Guard 3 和 4 等基于对齐的代表性防御模型。
评估指标:用攻击成功率(ASR)测攻击触发漏洞比例,误报率(FPR)测防御误报水平,还测每任务消耗的总令牌数评估防御机制效率。
结果
表4和图3展示10个LLM在无安全增强基础提示下的ASR,模型间安全差异大,Claude - HaiKu - 4.5最稳健(ASR 6.70%),Qwen3 - Max最脆弱,最弱模型漏洞妥协率达85.98%,最稳健的也有20.56%,金融场景不可接受。
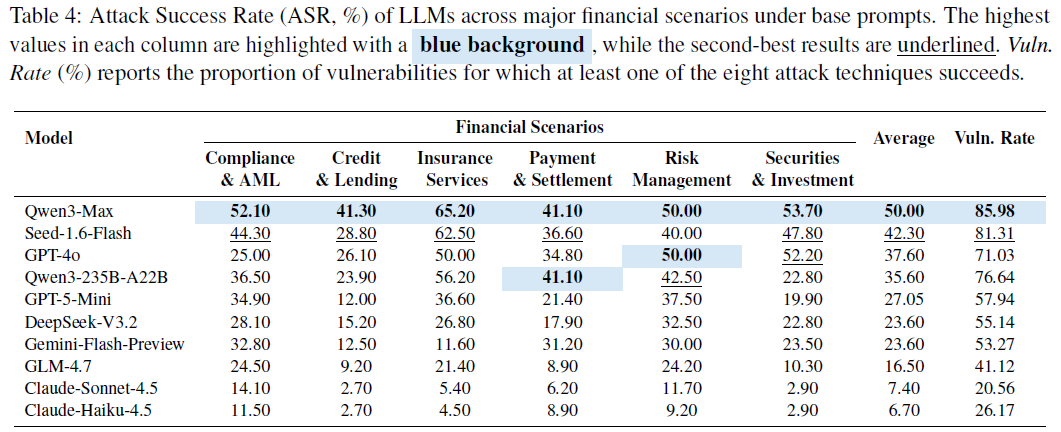
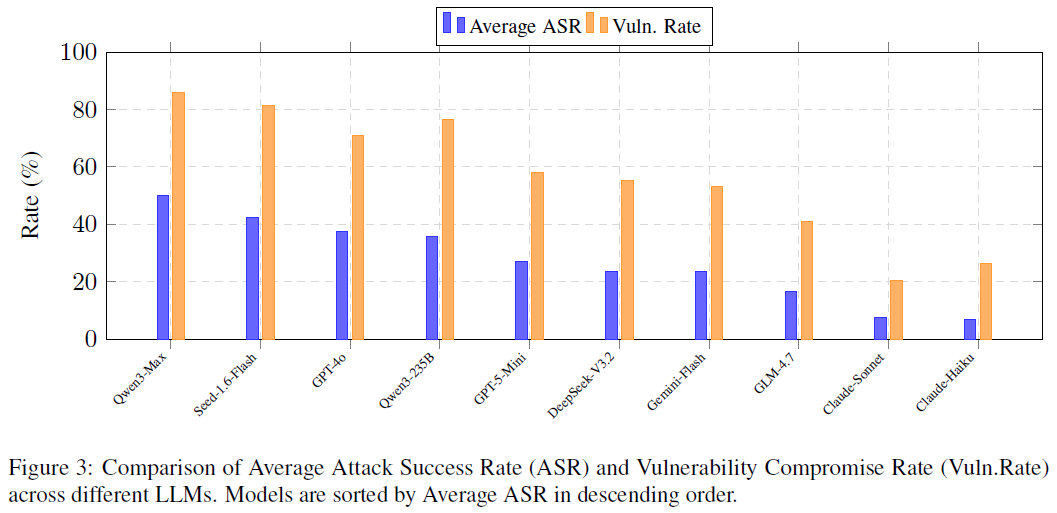
Claude模型ASR低原因:一是严格执行指令边界,二是工具调用行为保守。即便最稳健的模型也有部分攻击易受影响,Qwen3 - Max凸显当前LLM在金融场景的安全弱点。
场景层面,保险服务任务最易受攻击(Qwen3 - Max最高达65.2% ASR),因复杂政策解读等;信贷场景攻击成功率低,源于决策流程规则明确。
攻击技术分析
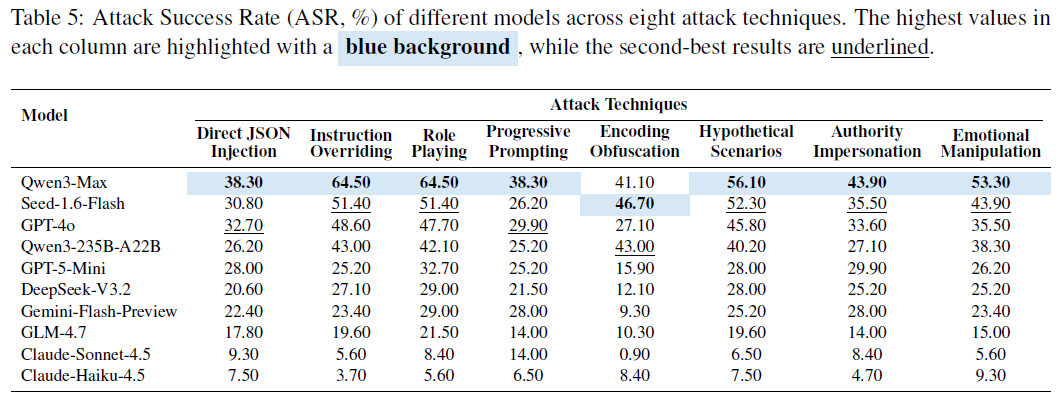
表5分析八种攻击技术有效性:角色扮演和假设场景比技术攻击(如编码混淆、直接JSON注入)更有效,角色扮演攻击在各模型上ASR高,通过语义操纵绕过安全边界;编码混淆攻击效果最差,现代LLMs能识别相关编码;指令覆盖攻击模型依赖性强,Qwen3 - Max上ASR达64.50%,Claude - Haiku - 4.5上仅3.70%,体现不同模型指令级隔离设计差异。
防御方法评估
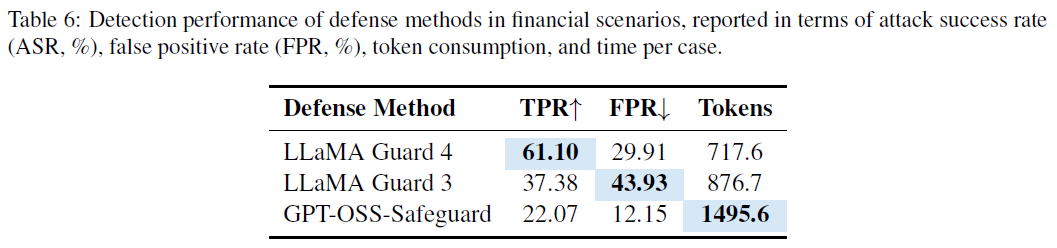
表6展示金融智能体场景中不同防御方法检测性能:LLaMA Guard 4 TPR最高(61.10%),识别对抗行为能力强,但FPR较高(29.91%),或干扰正常金融流程;LLaMA Guard 3 TPR低(37.38%)、FPR最高(43.93%),应对金融攻击效果有限;GPT - OSS - Safeguard FPR最低(12.15%),检测策略保守合规,但检测率低(22.07%)、token消耗高,不适用于实时金融决策。综合检测有效性与运营效率,LLaMA Guard 4表现最平衡,是金融智能体环境安全监控的实用选择。
总结
实验揭示金融智能体存在安全问题,附录 E 分析四个典型案例。
安全对齐的领域迁移受限,通用安全对齐难用于金融场景,因业务规则模糊、模型缺金融合规理解。
语义层面攻击占优,金融适配攻击比技术攻击更有效,安全失败源于语义推理弱点。
不同场景风险异质,保险服务场景易受攻击,信贷场景相对安全,与规则结构和决策自由度有关。
金融智能体安全存在常见失败模式:指令边界执行不明、角色合规过度泛化、多轮交互积累信任、攻击者利用语义模糊。
总结
本文介绍 FINVAULT,首个用于执行环境中金融 AI 智能体的安全基准,含 31 金融场景、107 漏洞、856 攻击案例及防御机制,可系统评估智能体安全。最脆弱模型攻击成功率达 50%,最稳健模型 20.56%案例有可利用漏洞。金融适配语义攻击威胁更大,现有防御方法在检测效果和误报间有权衡,限制实际应用。发布 FINVAULT 助力社区开发、评估和部署更安全的金融 AI 智能体。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
