QuantaAlpha:LLM驱动的自适应Alpha挖掘,IC达0.1501,ARR为27.75%,MDD低至7.98%
“QuantaAlpha: An Evolutionary Framework for LLM-Driven Alpha Mining”
金融市场是高维、非平稳随机系统,量化投资依赖Alpha挖掘提取信号。现有智能体框架缺乏可控多轮搜索和有效经验重用。本文提出QuantaAlpha 挖掘框架,通过轨迹级自适应提升因子质量。
实验显示,QuantaAlpha在四年评估期内于CSI 300市场表现优于所有基线,用GPT-5.2时IC达0.1501,ARR为27.75%,MDD低至7.98%。且挖掘的因子可有效迁移到中证500和标普500指数,展现出强鲁棒性。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融市场嘈杂且非平稳,使Alpha挖掘对回测结果噪声和市场制度转变敏感,现有智能体框架缺乏可控多轮搜索和有效经验重用。为此提出QuantaAlpha框架,将每次挖掘视为轨迹,通过轨迹层面的变异和交叉操作改进因子,定位次优步骤修正、重组高回报片段以复用有效模式,生成因子时保证语义一致、控制复杂度和冗余度。实验显示其在沪深300指数表现优于基线模型和先前智能体系统,使用GPT-5.2时信息系数等指标良好,且挖掘的因子可有效迁移到中证500和标普500指数,展现出强鲁棒性。
简介
金融市场是高维、非平稳随机系统,量化投资依赖Alpha挖掘提取信号。近期大语言模型和基于大语言模型的智能体框架被引入因子研究工作流,可自动构建因子并通过回测反馈迭代优化。
用于挖掘Alpha的代表性智能体框架,模拟人类量化研究流程,如AlphaAgent抑制因子拥挤、减轻Alpha衰减,RD-Agent实现全栈自动化和联合优化,可降低因子研究成本、保留可解释性。
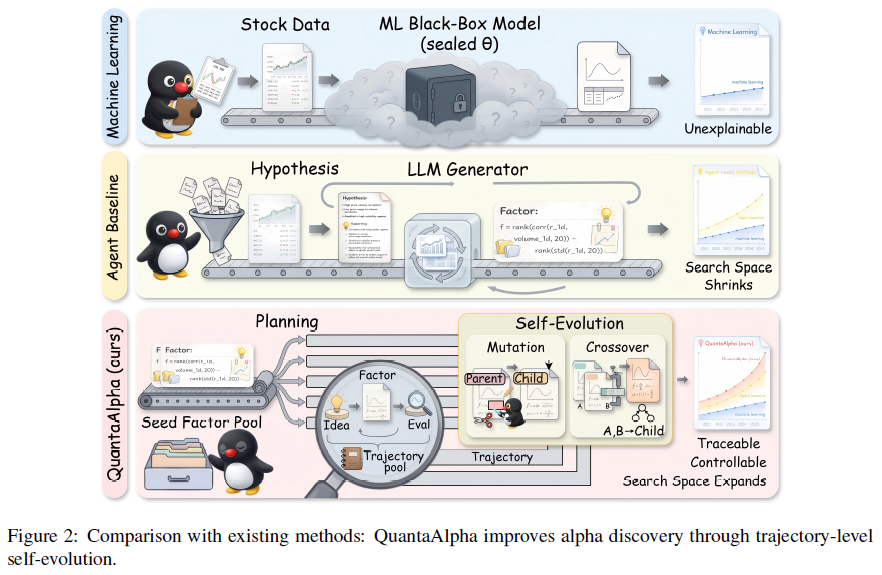
现有系统在真实市场下有三局限:
一是可控性脆弱,迭代优化受噪声反馈影响,易偏离经济机制;
二是可信度有限,方法缺乏迭代间有效传承,因子难审计;
三是探索性受限,搜索易集中局部,覆盖范围小、长周期发现能力弱。
为应对上述挑战,文本提出 QuantaAlpha 自适应Alpha挖掘框架,通过轨迹级自适应提升因子质量。借鉴 Lin 等(2025),将每次端到端挖掘视为轨迹,直接自适应轨迹而非依赖噪声反馈无约束再生。具体措施:
一是引入多样化规划初始化,生成多互补研究方向,扩大假设空间初始覆盖;
二是通过轨迹级变异和交叉实现自适应,变异定位致败步骤修改对应片段,交叉重组高回报父轨迹互补片段;还应用生成约束确保语义一致、控制复杂度与冗余。
这些机制在实盘噪声和非平稳性下拓展探索并稳定优化。对 CSI 300 及跨市场转移至 CSI 500 和 S&P 500 的大量实验表明,其预测能力和策略表现优于强基准和先前智能系统。
相关工作
金融智能体。金融大语言模型及评估基准拓展了自动金融推理范围,相关研究探索智能体系统开展决策导向研究工作流,如因子发现与交易分析。追求Alpha因子从手动工程转向大语言模型驱动的闭环发现,近期强调工作流系统化,如 RD - Agent 提出多主体框架,AlphaForge 关注因子动态组合,Alphafin 和 AlphaEval 建立评估协议。但交易约束多为事后过滤,导致实盘交易泛化性和可解释性欠佳。
自适应智能体。自适应智能体实现从静态指令遵循到与环境交互自主学习的范式转变。AlphaEvolve以编码为核心自适应,CSE引入可控自适应。金融领域应用该框架处理复杂数据,研究聚焦多智能体协调与结构化反馈。TradingAgents等利用机构式辩论优化交易假设,QuantAgents等用模拟交易绩效优化提示。FinMem和FinCon借助分层记忆与概念强化保留交易经验。但低信噪比和非平稳性阻碍其向金融领域过渡,QuantaAlpha采用稳定优化单元及算子,通过结构化存档确保自适应路径可靠可追溯。
问题建模
Alpha 挖掘
市场特征张量 X 学习 alpha 因子 f,用于预测股票横截面回报 y,将其表述为优化问题
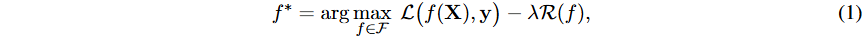
Alpha 挖掘轨迹
引入市场假设 h 指导基于大语言模型的因子构建,每次挖掘运行用轨迹
τ = (s0, a0, s1, a1, ..., sn) 表示,轨迹质量由终端奖励 R(τ) 衡量。
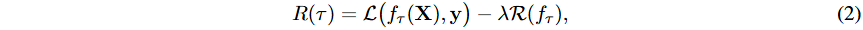
目标
找到多智能体系统的轨迹生成机制 π,使生成的挖掘轨迹的期望终端奖励最大化,即
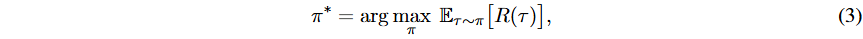
方法
本文将Alpha挖掘视为智能体研究工作流,多智能体系统依据市场背景和用户种子生成完整挖掘轨迹。先介绍单轨迹端到端挖掘流程,再基于评估轨迹引入自适应优化方案迭代提升挖掘质量。
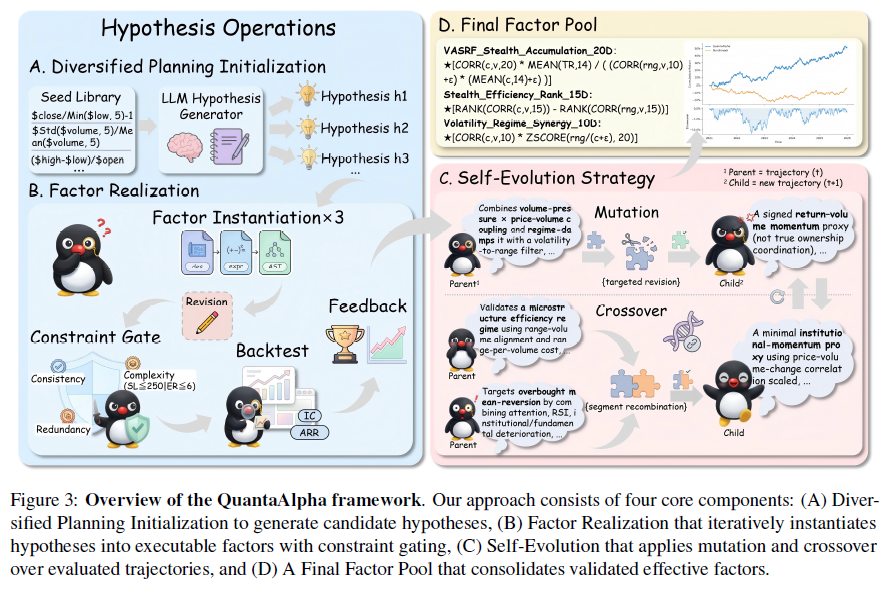
Alpha挖掘过程
独立的Alpha挖掘流程包括假设生成、因子创建和基于回测的评估,此过程转化为多智能体协作,各负责工作流不同阶段特定任务。
假设生成
利用智能体 AI 进行结构化知识整合以生成市场假设。基于当前市场观察、金融理论与实证的领域先验及参数设定,AI 产出描述市场机制的可行假设,作为后续因子生成的输入。
可控因子构建
为有效实例化假设驱动因子,提出以下方法:
因子生成:基于标准化算子库 O 和抽象语法树(AST)引入中间符号表示,因子智能体 Af 根据假设 h 和原始特征 X 生成符号表达式 f 并解析为 AST T(f),再编译成可执行代码 c,编译失败时用 LLM 修复。
一致性验证:用 LLM 验证假设 h、语义描述 d、符号表达式 f 及生成代码 c 间的语义一致性,不通过则重写。
复杂度和冗余控制:通过结构约束控制复杂度和冗余度,计算复杂度 C(f) 和候选因子与现有因子的最大相似度 S(t),违规则重写。
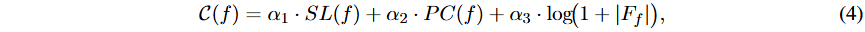
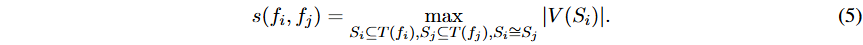
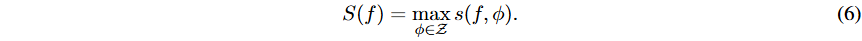
自适应Alpha挖掘
通过对挖掘轨迹进行迭代优化改进Alpha挖掘。从用户提供的种子因子生成多样化初始假设,按4.1节工作流将假设转化为评估后的挖掘轨迹形成初始轨迹池T₀,再经迭代自适应获得更优因子。
多样化规划初始化
利用用户提供的种子因素,初始化智能体 A0 提出多样化初始假设集 H0,要求假设在语义和结构层面互补。对 H0 中每个假设运行挖掘工作流得挖掘轨迹 τ i0,这种多样化初始化拓宽假设空间搜索范围,使后续自适应过程并行探索多区域,降低过早收敛至局部最优风险。
自适应
具体通过两种自适应原语实现更新:
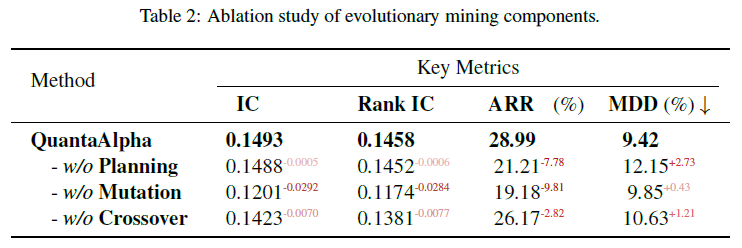
变异(Mutation):针对上一轮轨迹,诊断导致低终端奖励的次优决策节点,重写局部动作或短片段,其余步骤不变,可更新假设、表达式、代码等并引入机制级变化。
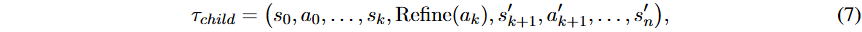
交叉(Crossover):基于轨迹奖励选父轨迹子集,从优质父轨迹中选取高绩效片段合成新子代轨迹,继承验证过的决策。
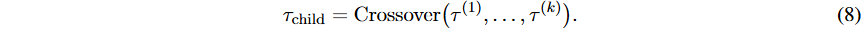
实验
实验设置
数据集与指标:实验采用 CSI 300 数据集,含中国市场 300 只大盘 A 股。按时间划分训练(2016.1.1 - 2020.12.31)、验证(2021.1.1 - 2021.12.31)、测试(2022.1.1 - 2025.12.26)集。从因子预测能力(IC、ICIR、Rank IC、Rank ICIR)和策略表现(ARR、IR、MDD、CR)两方面评估。
基线模型:将 QuantaAlpha 与传统机器学习模型、深度学习时间序列模型、经典因子库和基于大语言模型的因子研究智能体(RD-Agent、AlphaAgent)对比。
结果
表1显示QuantaAlpha在四年评估期内于CSI 300市场表现优于所有基线,用GPT-5.2时IC达0.1501,ARR为27.75%,MDD低至7.98%,表明挖掘的因子可支持生产交易,且不同基础模型下表现一致,改进具有鲁棒性。
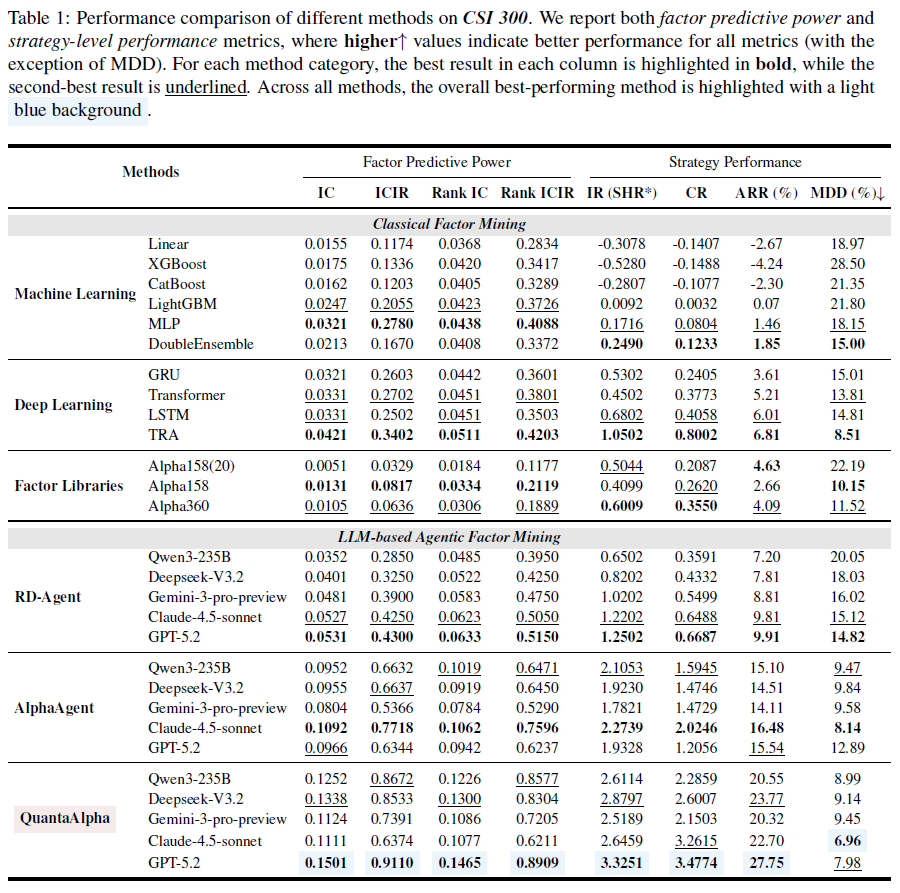
与RD-Agent相比,QuantaAlpha和AlphaAgent纳入生成阶段正则化,表现更优。在GPT - 5.2下,QuantaAlpha相对RD - Agent IC提高0.0970、ARR提高17.84%、MDD降低6.84%。
QuantaAlpha进一步优于AlphaAgent,IC提高0.0535、ARR提高12.21%、MDD降低4.91%,凸显轨迹中心自适应的价值。
消融分析
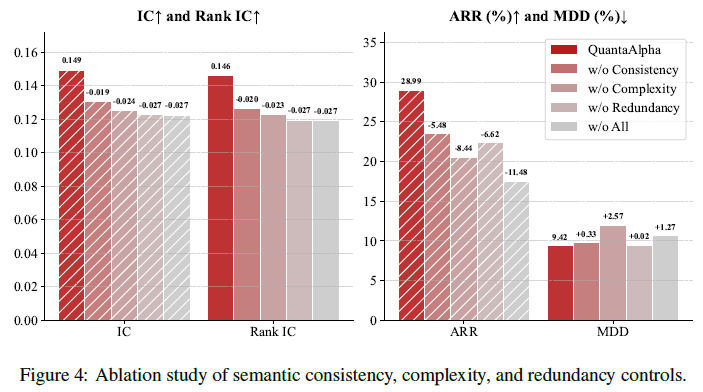
一致性、复杂度和冗余控制消融:因子生成中去除语义一致性验证、复杂度正则化和冗余过滤任一控制都会降低性能,复杂度控制去除在策略层面降幅最明显,三个控制都去除降幅最大,说明三者互补,联合保障可靠生成。
进一步分析
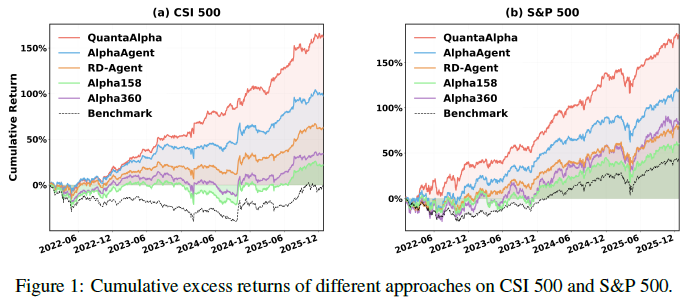
因子泛化能力:通过零样本迁移实验,在CSI 300挖掘选择的因子直接用于CSI 500和标普500,QuantaAlpha比基线方法有更强的分布外泛化能力,2023年12月后优势明显,评估期末在CSI 500和标普500累计超额回报分别约160%和超137%。
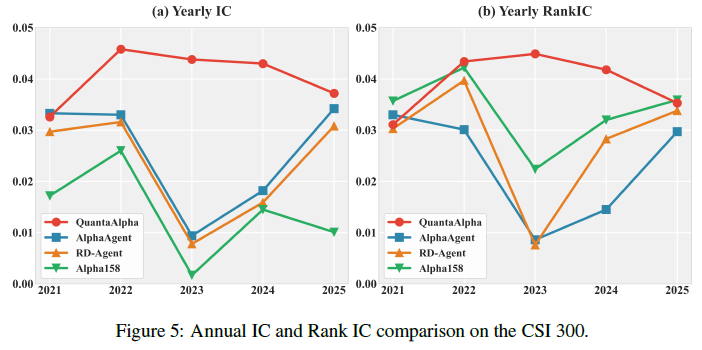
市场风格转变及影响:2023年CSI 300市场风格从大盘核心资产转向小盘和主题股,增加日内噪音等,挑战依赖稳定日内结构或快速均值回归的因子构建。
与市场微观结构一致的因子语义:
隔夜和拍卖信息:基于缺口的因子在2023年成为主导稳定信号。
波动率结构和基于范围的信号:基于波动率聚类的范围偏差因子在2023年仍有预测性。
趋势质量和流动性重新评级:QuantaAlpha强调低残差波动率和改善流动性支持的趋势延续,过滤噪音伪趋势,保留更多强表现因子。
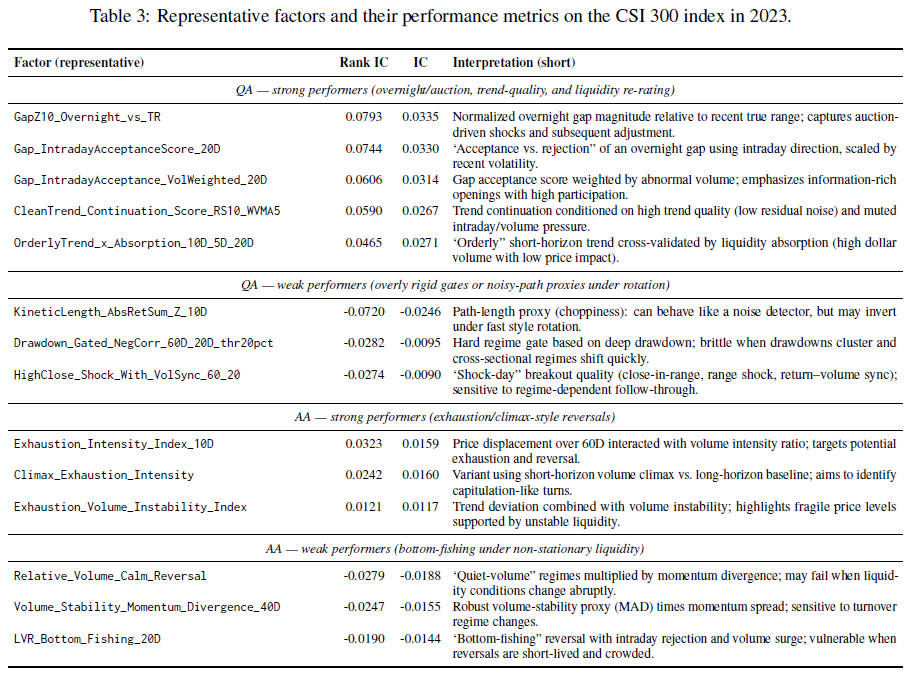
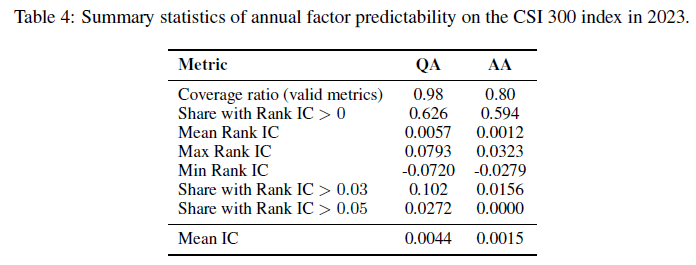
因子统计作为支撑证据:2023 年因子级统计为语义解释提供量化支持,QA 覆盖度高、Rank IC 右尾更重,AA 尾部压缩、强信号少,差异与 2023 年市场风格下特定渠道主导有关;QA 通过因子变异机制促进语义多样性,避免单一市场假设,增加因子与市场微观结构契合概率,减轻特定制度下的Alpha衰减,Alpha稳健性源于市场风格与因子语义的契合及信息渠道的多样性,QA 靠维持广泛且适应性强的因子群体保持表现。
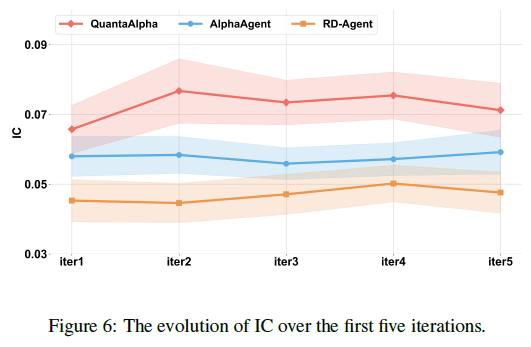
自适应Alpha挖掘效率:通过跟踪各轮次 IC 分布分析因子挖掘迭代动态,QuantaAlpha 在五轮迭代中 IC 始终最高,早期提升快且后期稳定在高位,样本效率高,IC 有适度且持久的离散度,反映探索因子的多样性;RDAgent 的 IC 较低且同质化,探索能力弱、信号易拥挤;AlphaAgent 优于 RDAgent 但低于 QuantaAlpha,表明轨迹级自适应能更有效地积累和复用成功生成模式。
案例分析
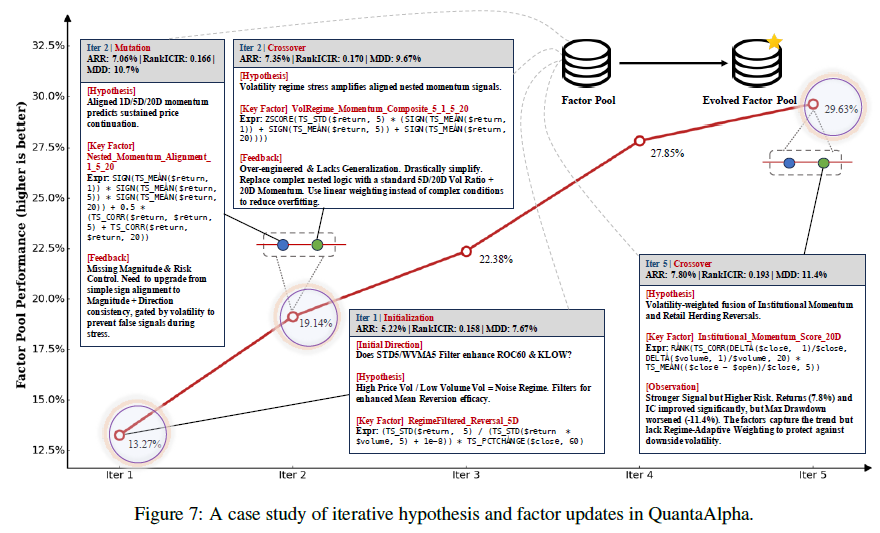
研究设置:对 CSI300 运行 QuantaAlpha 共 15 次迭代,用 Deepseek - V3.2 为骨干大语言模型,设因子复杂度约束,每次迭代含突变和交叉阶段,每次迭代结束后维护全局优质因子池。
因子示例:图 7 展示各迭代通过突变和交叉阶段优化假设和因子表达,前五次迭代各有特点,自适应中维持累积因子池,前 15 次迭代内预测性能先提升后衰减。
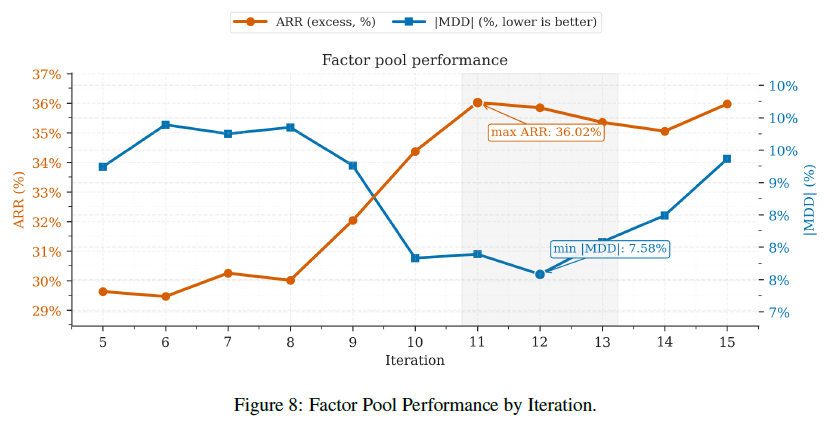
迭代收敛:图 8 显示因子池从第五次迭代起的预测性能,迭代次数与性能非线性增长,11 - 12 次迭代时收益与最大回撤达平衡,后续迭代可能降低策略鲁棒性,此阶段约 350 个因子为收益与风控的最优平衡点。
总结
本文介绍QuantaAlpha,这是一个可解释的Alpha挖掘自适应框架,将因子发现表述为受限多智能体研究过程。中美股市实验表明,其生成的因子比基线更稳定、更具泛化性,强调多样性、可控性和可信赖性三个关键特性。未来将拓展至多资产和跨市场,融入自适应制度感知自适应,与投资组合构建和风险管理更紧密结合,认为智能体自适应是高噪声、非平稳领域发现问题的有前景范式。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
