蚂蚁集团扩散大语言模型新突破:超800Token/s,速度与质量兼得
扩散模型(Diffusion Models)在视觉生成领域大放异彩,但在文本生成领域一直难以追赶预测下一个Token的自回归模型。
刚刚,蚂蚁集团LLaDA更新到了2.1。
LLaDA2.1通过引入“草稿-编辑”机制打破了扩散模型推理速度与质量的对立僵局,在代码生成任务上实现了超越800 TPS(每秒生成Token数)的惊人速度。
给AI装上橡皮擦
传统扩散大语言模型的文本生成就像是用打字机写文章,每个字一旦敲下去就印在纸上,无法更改。
这种模式被称为掩码到令牌(Mask-to-Token, M2T)的单向流动。
模型从一堆[MASK](掩码)开始,逐步填入具体的词。这种刚性的生成方式要求模型每一步都必须精准无误。
一旦模型在前期生成了一个错误的词,为了保证语句通顺,后面生成的词就不得不迁就这个错误。
这就像撒了一个谎,为了圆谎必须撒更多的谎,最终导致整段生成的崩塌。
这种现象在学术上被称为暴露偏差(Exposure Bias)。
LLaDA2.1对此提出了一个直击本质的解决方案。
它赋予了模型“后悔”的权利,也就是引入了令牌到令牌(Token-to-Token, T2T)的编辑能力。
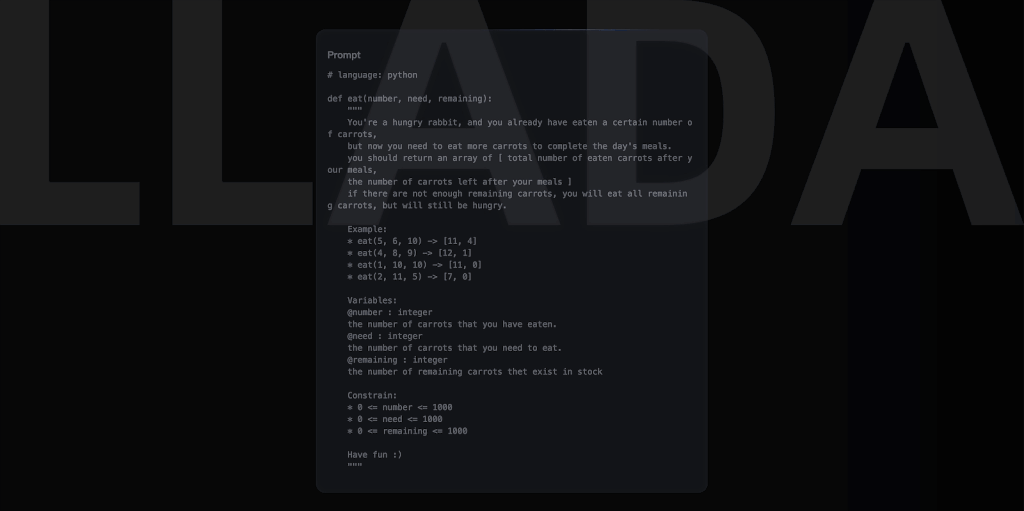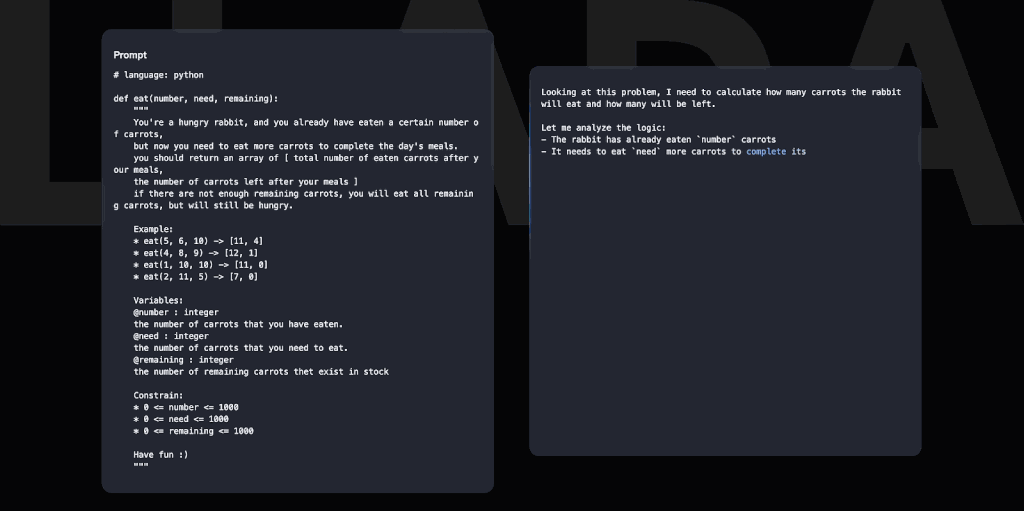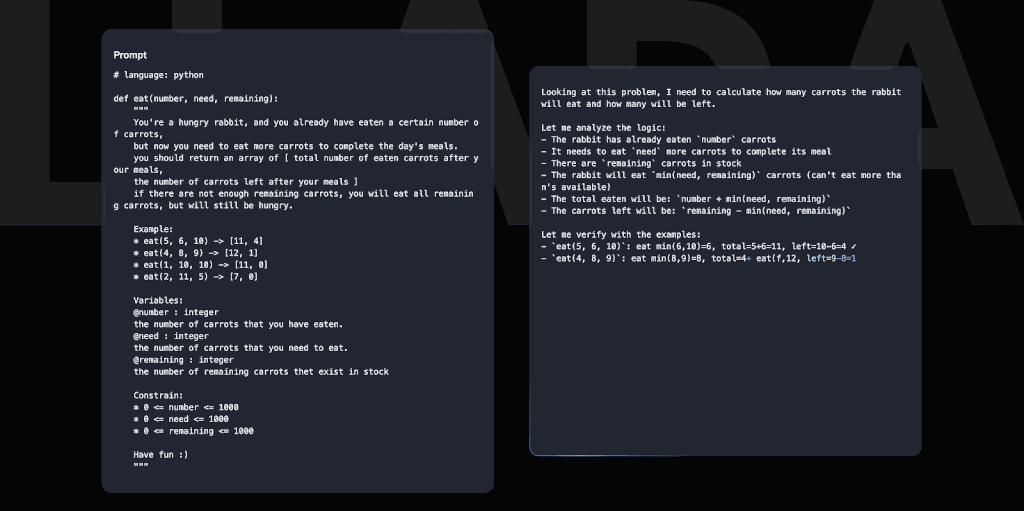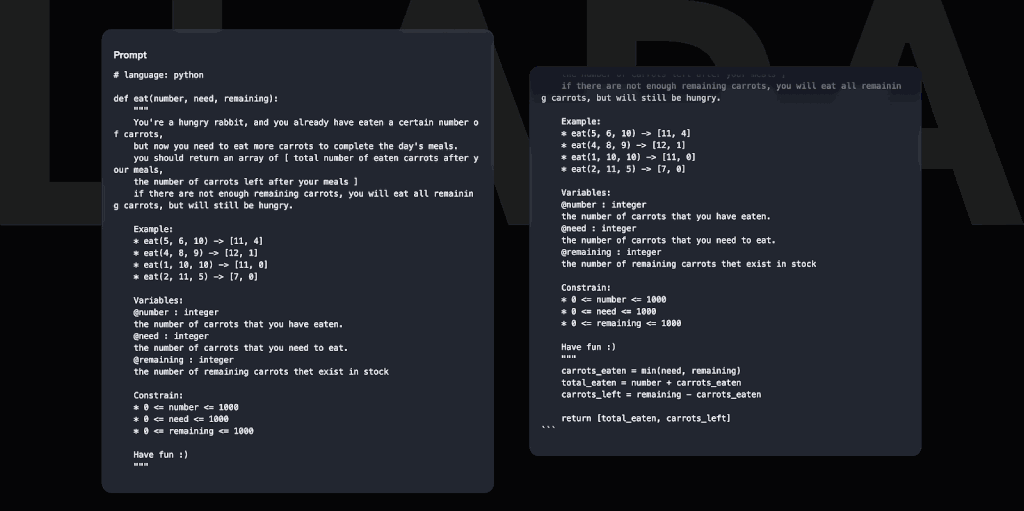
这就好比从用打字机写作进化到了用文字处理软件写作。
模型不仅可以填空,还可以把已经写好的词删掉重写。这种机制的引入,让文本生成过程从“落子无悔”变成了“精益求精”。
在具体的推理过程中,模型维护着两个集合。
一个是负责填空的“揭秘集”,另一个是负责修改的“编辑集”。
模型在每一步都会同时评估哪些空需要填,以及哪些已经填好的词需要改。
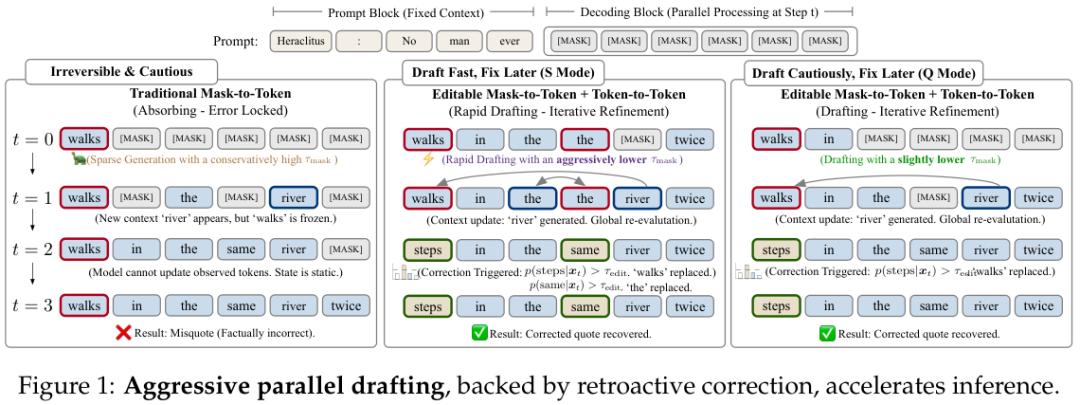
我们看上面这张图就能明白其中的奥妙。
传统的生成方式像是在过独木桥,小心翼翼。
而LLaDA2.1则是先快速铺出一条路,哪怕中间有几块砖铺歪了也没关系,因为它回头还能把歪掉的砖扶正。
比如在生成这句“Heraclitus: No man ever steps in the same river twice”时,传统模型一旦卡住就停滞了。
而LLaDA2.1在快速模式下,可能先生成了“walks in the the river twice”这样并不完美的句子。
紧接着的步骤里,模型发现了不对劲。
它会触发修正机制,把“walks”改成“steps”,把多余的“the”替换成“same”。
通过这种自我修正,模型最终得到了正确且高质量的结果。
这种机制让模型在面对复杂推理时更加从容。
它不再需要为了追求一步到位而畏手畏脚,而是敢于先给出一个大概的答案,再通过迭代来完善细节。
速度与质量的动态平衡
拥有了编辑能力后,LLaDA2.1展现出了两种截然不同的性格。
这种性格的切换完全取决于用户对生成门槛的设定。
第一种性格是极速模式(S Mode)。
在这种模式下,模型像是一个思维敏捷但略显潦草的快枪手。
它大幅降低了初始填空的置信度门槛,允许模型在不太确定的时候就先把词填上去。
这样做的好处是生成速度极快,大段的文字瞬间就能铺满屏幕。
虽然初稿可能包含一些错误或不通顺的地方,但没关系,后序的编辑机制会迅速跟进,像一个负责任的校对员一样把错误修正过来。
第二种性格是质量模式(Q Mode)。
这时候模型变身为一位严谨的学者。它保持着较高的置信度门槛,只有在非常有把握时才生成内容。
即便如此,编辑机制依然在后台运行,作为一道额外的安全防线,确保最终输出的逻辑严密性和准确性。
虽然牺牲了一定的速度,但换来了在复杂基准测试上的优异表现。
设计巧妙地将速度与质量的硬性权衡转化为了一种可调节的连续谱系。
用户不再需要像以前那样在两个极端之间做非此即彼的选择,而是可以根据具体场景灵活调整。
对于代码补全这样对实时性要求极高的场景,极速模式简直是量身定做。它能以数百词每秒的速度狂飙,让程序员几乎感觉不到延迟。
而在需要深度思考的数学解题或逻辑推理任务中,质量模式则能确保模型不会因为急于求成而犯下低级错误。
LLaDA2.1包含两个版本。
一个是16B参数量的Mini版,另一个是100B参数量的Flash版。
即使是千亿参数的巨无霸,在引入这种机制后也能跑得飞快。
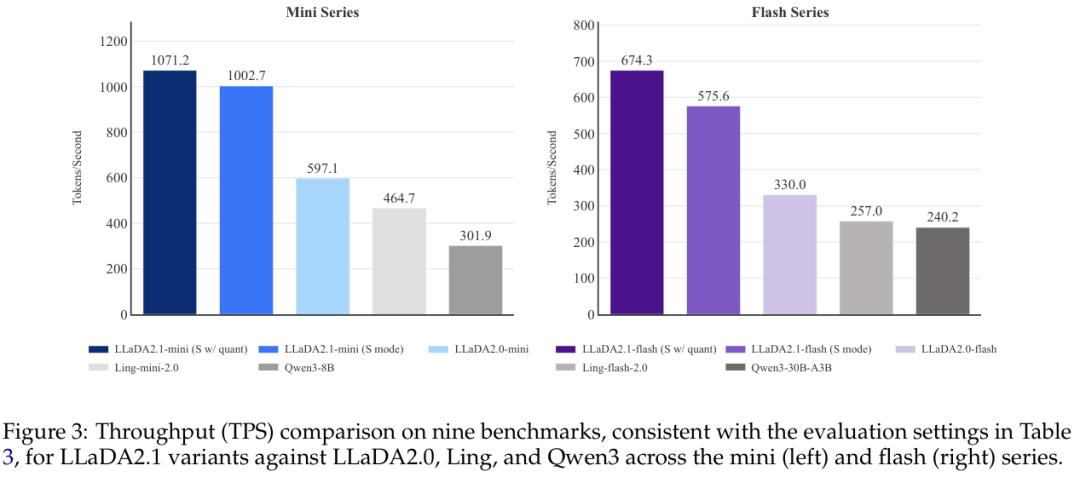
从图表中我们可以直观地感受到这种速度上的碾压优势。在同样的硬件条件下,LLaDA2.1的吞吐量远远将同类模型甩在身后。
为扩散模型定制的训练方案
为了让模型真正掌握“草稿-编辑”这项技能,研究团队在训练阶段下足了功夫。
他们没有沿用传统的单一训练目标,而是设计了一套混合训练流程。
在持续预训练(CPT)和监督微调(SFT)阶段,模型同时接受两类任务的训练。
一类是传统的填空任务,训练模型无中生有的能力;另一类是去噪任务,训练模型从混乱中恢复秩序的能力。
这种双流训练确保了模型在同一个参数空间内同时内化了作家和编辑两种角色。
它既知道怎么写新词,也知道怎么改错词。
更进一步,团队引入了大规模强化学习(RL)来对齐人类意图。
将强化学习应用于扩散模型一直是个技术难题,因为计算序列的对数似然概率极其困难且昂贵。
LLaDA2.1采用了一种名为基于ELBO的块级策略优化(EBPO)的框架。
这个名字听起来很拗口,但其核心思想非常精妙。它利用变分推断中的下界(ELBO)作为替代指标,绕过了精确计算似然概率的死胡同。
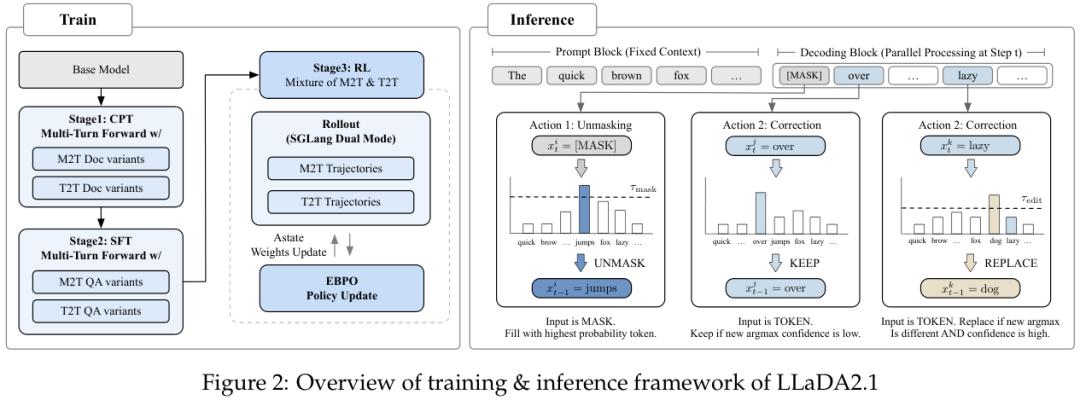
这张流程图展示了整个训练架构。从基础模型开始,经过多轮前向传播的数据增强,最终通过强化学习进行策略更新。
配合SGLang推理引擎和Alpha-MoE(混合专家模型)内核的优化,这套系统实现了高效的训练与推理。
特别是在长文本处理上,采用了分块因果掩码技术,使得长序列的键值缓存(KV cache)可以在一次前向传播中计算完成。
这种基础设施层面的优化,为上层的算法创新提供了坚实的底座。
它保证了模型不仅理论上行得通,在实际工程落地时也能保持高效稳定。
强化学习的引入不仅仅是为了提升分数,更是为了让模型学会何时该坚持己见,何时该自我修正。
模型在面对模糊指令或复杂逻辑时,表现得更加像一个经过深思熟虑的人类。
实测数据验证技术红利
LLaDA2.1在涵盖知识、推理、代码、数学等维度的33个严格基准测试中交出了答卷。
在代码生成任务上,LLaDA2.1的表现尤为抢眼。
100B参数的Flash版本在HumanEval+测试集上达到了892 TPS的惊人速度,在BigCodeBench上也达到了801 TPS。
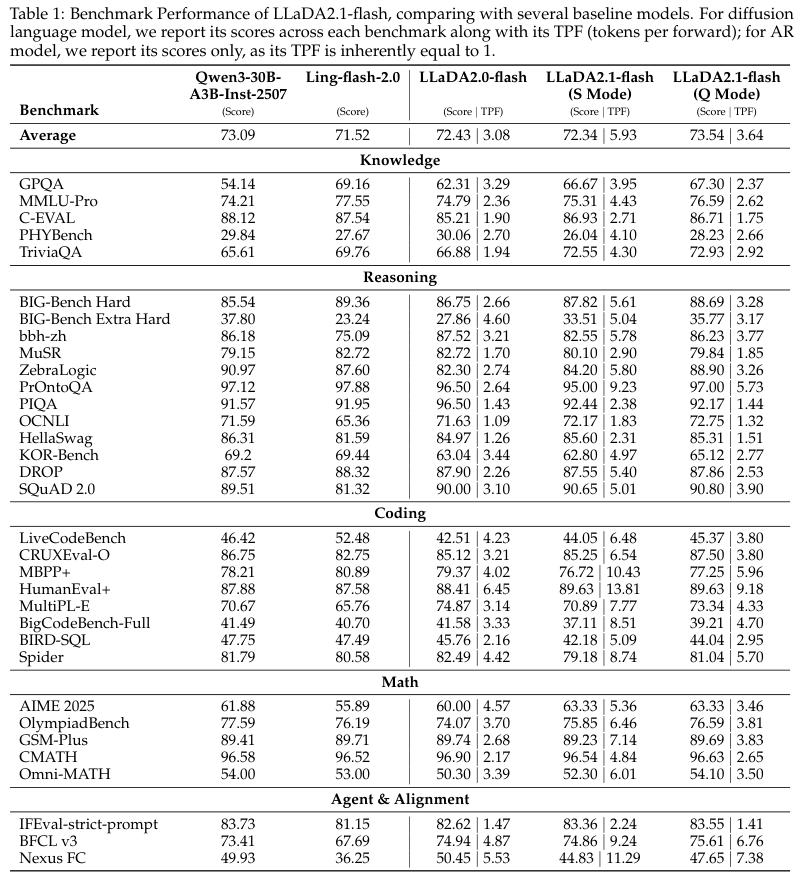
表格数据清晰地展示了LLaDA2.1在不同模式下的表现。
我们可以看到,在S模式下,模型的每次前向传播(TPF)能生成近6个Token,它的效率是传统自回归模型的6倍左右。
即便是在追求极致速度的S模式下,其各项指标的得分也并没有出现崩塌式下跌,反而与之前的版本及竞品互有胜负。
在HumanEval+代码测试中,它甚至在保持超高速度的同时,分数还略有提升。
这种多快好省的特性在实际应用中极具价值。
对于用户来说,等待一个长回答生成完是一件痛苦的事情。LLaDA2.1将这种等待时间压缩到了极致。
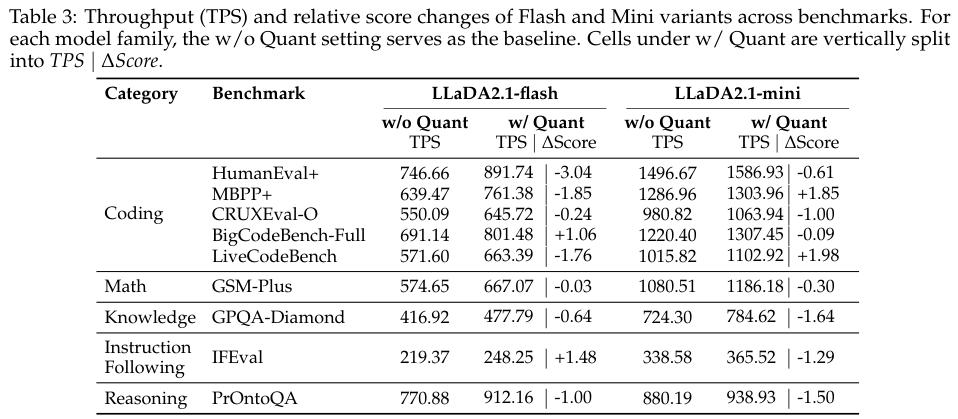
量化后的模型速度更是达到了飞起的状态。
Mini版本在代码任务上甚至突破了1500 TPS。这意味着生成一段完整的代码片段,几乎瞬间完成。
值得注意的是,这种速度的提升在不同领域的表现是不同的。
在结构化程度高的代码和数学领域,加速效果最为明显。而在需要精细措辞的指令遵循任务中,速度提升相对温和。
研究团队还引入了多块编辑(Multi-Block Editing, MBE)机制,允许模型不仅修改当前的句子,还能回过头去修改之前的段落。
这种全局的修正能力进一步提升了长文本生成的一致性。
尽管目前在某些极端情况下,过度激进的草稿模式可能会产生一些重复或不自然的片段,但瑕不掩瑜。
LLaDA2.1用事实证明,通过引入自我纠错机制,扩散语言模型完全有能力在速度和质量的博弈中找到新的最优解。
参考资料:
https://arxiv.org/pdf/2602.08676
https://github.com/inclusionAI/LLaDA2.X
https://huggingface.co/inclusionAI/LLaDA2.1-mini
https://huggingface.co/inclusionAI/LLaDA2.1-flash