Yann LeCun非生成世界模型前瞻:开年三篇论文展示JEPA工程化拐点
2022年,Yann LeCun提出联合嵌入预测架构 (Joint Embedding Predictive Architecture,JEPA):杨立昆路线的新胜利:VL-JEPA来了,抛弃预测下一个词,不靠生成,照样SOTA。
2026年,Yann LeCun团队3篇论文展示了基于 JEPA 框架的非生成世界模型工程化拐点。
让预测从像素表演退场,让语义和控制走上主舞台。
三篇论文像同一张地图的三条等高线:Rectified LpJEPA把JEPA的表示做得更像大脑的稀疏放电,GRASP(梯度松弛随机规划器)把长时域规划从串行推演改成并行求解,EB-JEPA(能量式JEPA轻量库)把整套方法装进可复用的代码积木。
它们合在一起,给Yann LeCun提出的非生成式世界模型提供了一条更省算力、更可控、更能落地的技术路线。
稀疏的Rectified LpJEPA让表示更省力
JEPA(联合嵌入预测架构)把学习的焦点放在表示空间,它更关心语义是否稳定,而非像素是否逼真。
为了防止坍缩,过去常见做法是把表示分布拉向各向同性高斯。
各向同性高斯很干净,也很吵闹。每个维度都被鼓励保持连续的数值,表示天然偏向稠密,和生物神经元那种大多数时间沉默、少数时间放电的节奏不合拍。
Rectified LpJEPA把问题换了一个问法。
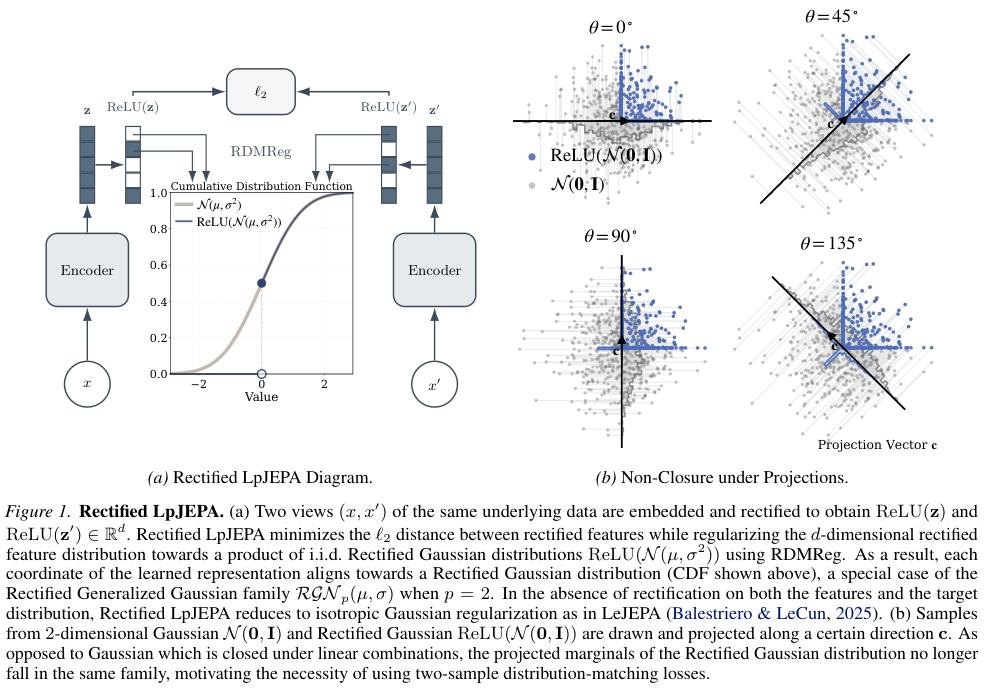
它把稀疏性当作表示应该自带的结构,而不是训练后期才靠剪枝补救。
论文提出RDMReg(整流分布匹配正则),用切片的两样本分布匹配,把表示对齐到RGG(整流广义高斯)这一族分布。
直觉很像把一团复杂的高维云雾,沿着很多随机方向切成一叠一维影子,再逐片校准影子的形状。
RGG靠整流把大量维度推到0附近,ReLU(线性整流单元)在这里不再只是网络里的激活函数,更像一把把信号推到正半轴的闸门。
RGN(整流高斯分布)是RGG的一个特例,它让稀疏与非负变成可控的目标,而不是偶然的副产物。
防坍缩仍然要做,而且要做得克制。
论文把最大熵原则放进约束里,在期望的ℓp规模与稀疏度边界内,让分布尽量保持随机性,这让表示既有骨架,也保留了表达空间的呼吸感。
下面是ImageNet-100线性探针结果。表里Acc1越高越好,L1 Sparsity与L0 Sparsity越低越稀疏。
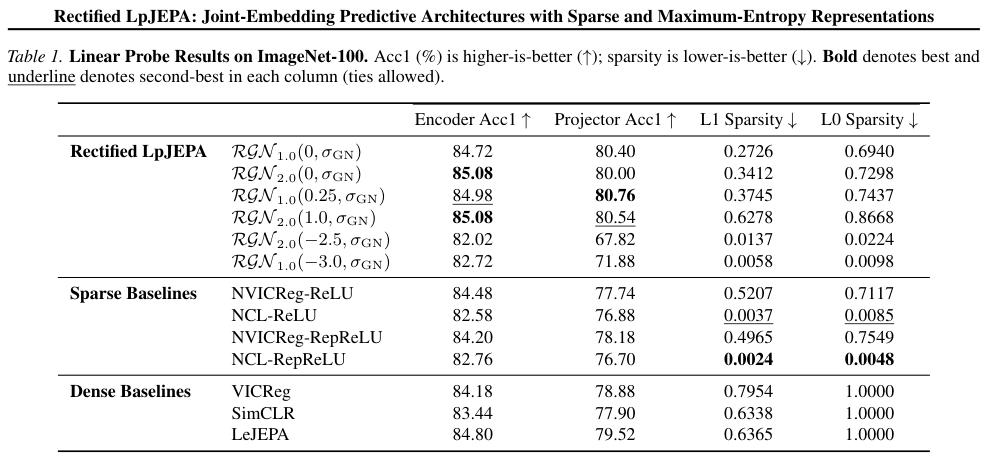
表里最醒目的对比来自L0 Sparsity。VICReg与LeJEPA这类稠密基线的L0为1.0000,Rectified LpJEPA可以把L0压到0.6940,甚至压到0.0224或0.0098,同时编码器Acc1仍维持在82.02到85.08之间。
SIGReg(切片信息高斯正则)曾用随机投影把高维分布匹配转为一维问题,Rectified LpJEPA沿着同一条思路继续走,只是把目标分布从高斯换成了更贴近稀疏表示的RGG。
它把JEPA的世界模型底座向类脑表征推了一步。
GRASP把长时域规划改成并行求解
世界模型一旦能预测,下一个问题立刻冒出来,怎么用预测做规划。
长时域任务里,路径往往要先绕远路才到终点,贪心更新很容易把自己锁死。
GRASP(梯度松弛随机规划器)把一条长轨迹拆成一组可并行优化的虚拟状态,并用软动力学约束把它们和世界模型连接起来。
想象在时间轴上放一串临时站点,先允许站点不完全守规矩,再在优化里把它们拉回到可行轨道。
并行化来自一个简单的算术事实。串行rollout必须等t步算完才有t+1步,虚拟状态把所有t步同时摆上桌面,计算被自然地摊开。
为了探索,GRASP给虚拟状态加噪声。
噪声像是在地图上多画几条备选小路,帮优化跳出局部凹坑。
另一个关键动作是停止状态梯度,只保留动作梯度。
视觉世界模型的状态空间高维且脆弱,状态梯度很容易变成可被利用的捷径,动作梯度相对更稳。
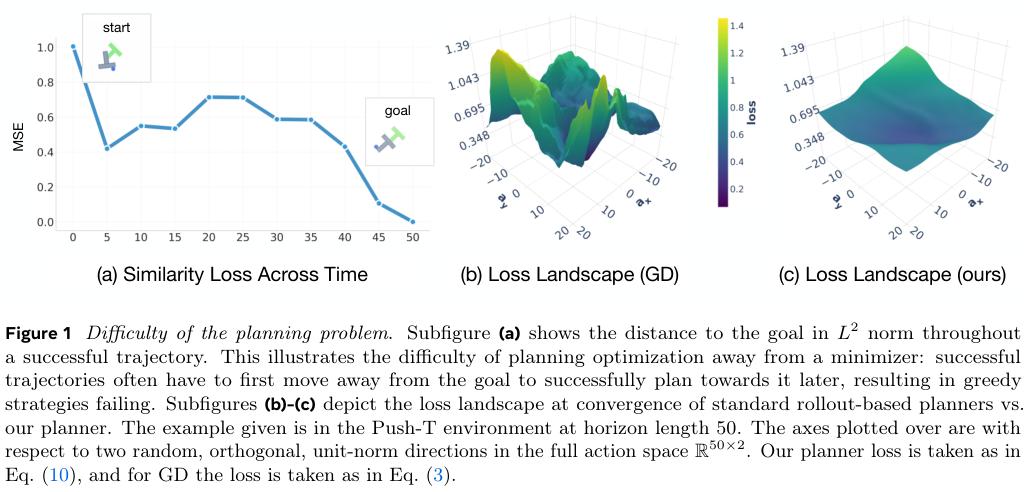
图a中纵轴是到目标的平均平方范数距离,横轴是时间t。曲线出现回升,路径在靠近目标前先拉远距离,这类轨迹在带障碍的长时域任务里并不罕见。
GD(梯度下降)的地形更崎岖,GRASP的设计目标是把优化地形变得更平滑,从而减少被局部极小值卡住的概率。
下面是Push-T任务的长时域开环规划结果,单元格为成功率百分比与成功样本的中位完成时间。
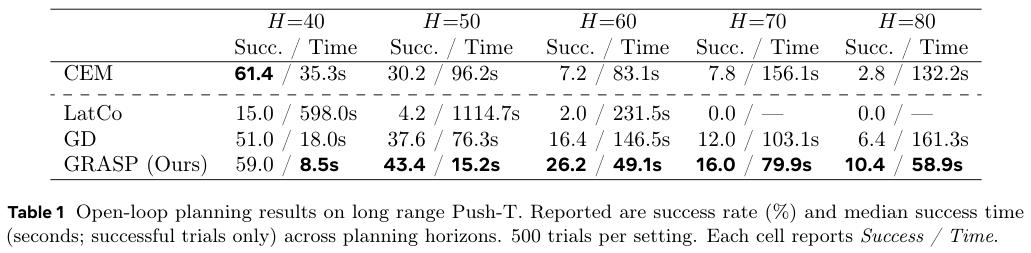
当H拉到80,GRASP的成功率10.4,高于CEM的2.8与GD的6.4,同时中位时间58.9s低于CEM的132.2s与GD的161.3s。
它把并行带来的速度收益与随机探索带来的稳健性放在同一张账单上结算。
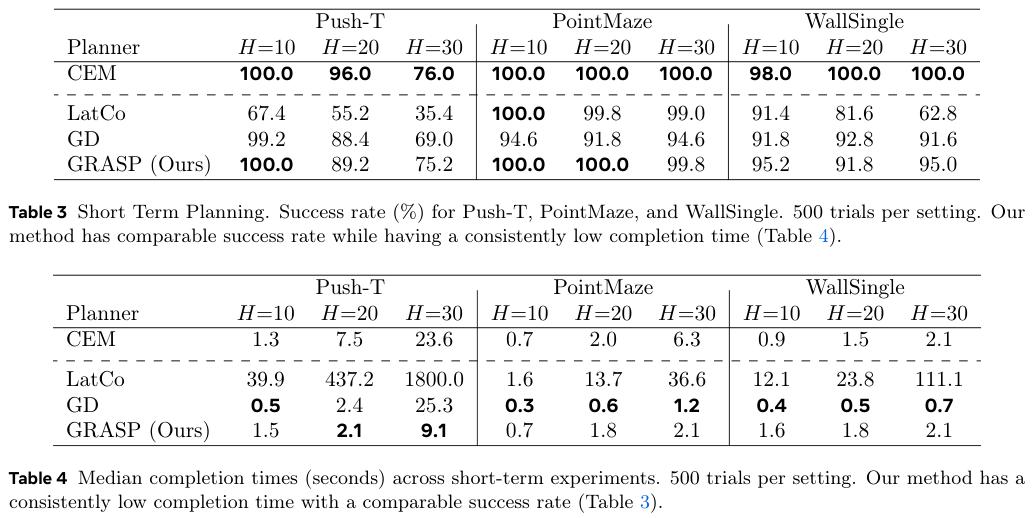
短时域里,GRASP在Push-T H=30的成功率75.2接近CEM的76.0,中位时间9.1s低于CEM的23.6s。
它把长时域的结构优势带进了短时域的速度竞争。
EB-JEPA把非生成式世界模型落到代码
EB-JEPA(能量式JEPA轻量库)想解决的是上手门槛。
它把JEPA方法中常见的组件拆成模块,让研究者能在单块GPU的规模下复现实验与做消融。
论文把链路写得很直白。
图像表征学习在CIFAR-10(CIFAR-10数据集)上跑通,视频多步预测在Moving MNIST(移动手写数字数据集)上展示长期滚动的稳定性,动作条件世界模型在Two Rooms(双房间环境)里做目标条件规划。
它把生成式路线里的像素重建负担放下,把计算花在表示空间的可预测性上。表示更像地图,像素更像地砖,建城要先画地图。
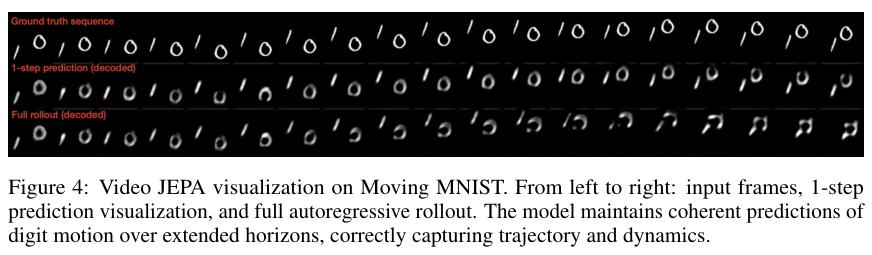
图中第一行是真实序列,后两行是解码后的预测结果与完整rollout。
它把多步预测的误差累积可视化成模糊与形变,训练时引入k步预测的动机也更直观。
EB-JEPA把正则化当作核心结构,而不是锦上添花。
SIGReg(切片信息高斯正则)与VICReg(方差协方差正则)在这里像两组护栏,防止表示坍缩。
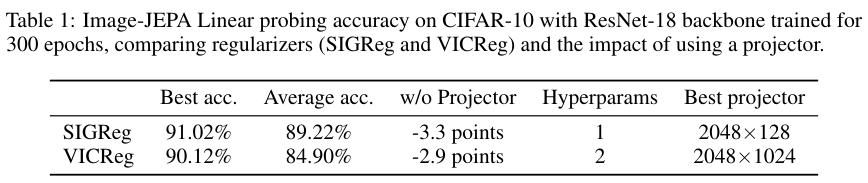
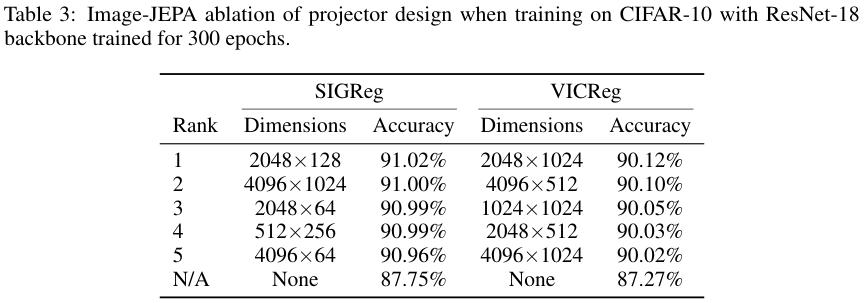
表格的w/o Projector一列把投影头的重要性写得很直白。它不是装饰,它直接给线性探针带来约3个点的增益。
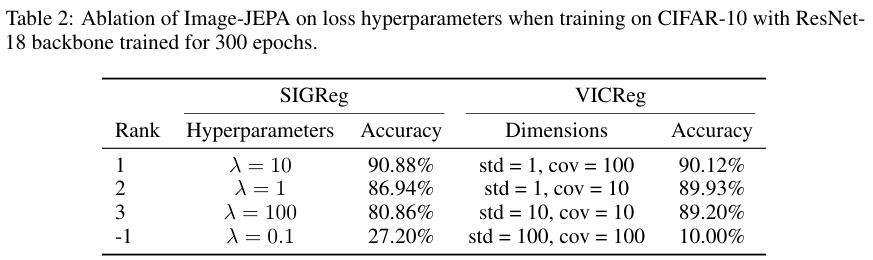
SIGReg只需要一个λ就能跑完这一轮对比,VICReg需要同时调std与cov。它不分高下,但在工程上体现了调参成本的差异。
走到动作条件世界模型,规划层的对比把非生成式路线的价值落到数字上。
MPPI(信息路径积分)与CEM(交叉熵方法)在同一个成本设计下做比较,模型组件消融把坍缩风险暴露得很直接。
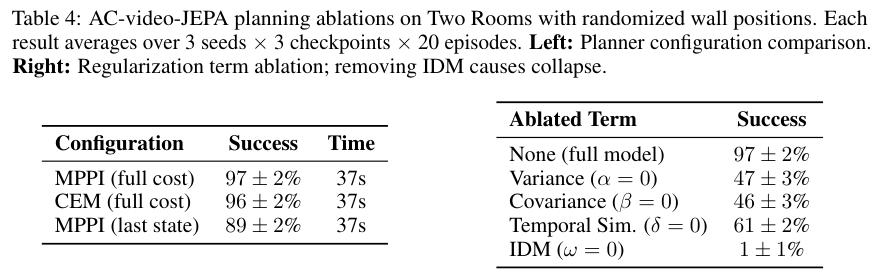
IDM(逆动力学模型)被拿掉后,成功率落到1 ± 1%。它像一张动作与状态变化之间的对照表,缺了它,表示容易被伪相关带跑偏。
Rectified LpJEPA把表示的分布目标从稠密高斯挪到可控稀疏的RGG,让表示更像可用的内部符号系统。
GRASP把规划从长链条的反向传播里拎出来,改用虚拟状态与软约束做并行优化,让长时域不再被串行rollout拖住。
EB-JEPA把方法论写进可运行的代码,把能量式JEPA(Energy-Based JEPA,能量式联合嵌入预测架构)变成可复用的组件集合。
它也顺手给了一条研究节奏,先在小规模里把结构做对,再去更复杂的世界里扩张。
非生成式世界模型把算力从像素重建转向表示预测,正则化把表示从坍缩边缘拉回可用结构,规划算法把控制问题从不稳定梯度里换到更平滑的优化地形。
下一步的难点更像工程与理论的交界处。表示要更稀疏也要更可控,规划要更长也要更稳,库要更轻也要更通用。
参考资料:
https://arxiv.org/pdf/2602.01456
https://arxiv.org/pdf/2602.00475
https://arxiv.org/pdf/2602.03604