多模态大语言模型应用场景实践
技术的发展终将服务于现实世界的需求。多模态大语言模型以其跨越多种信息媒介的独特能力正以前所未有的深度和广度渗透到社会生产和个人生活的方方面面。本文将聚焦于多模态技术的“落地实践”,系统性地梳理其在四大核心应用领域的现状、关键技术挑战及未来发展趋势。通过具体的模型案例和实践分析展示多模态技术如何从抽象的算法演变为解决实际问题、创造巨大价值的强大工具。这四大领域分别是:高级视觉理解、多模态内容创作、实时交互式助手以及具身智能与机器人。
一、高级视觉理解:超越“看图说话”
高级视觉理解是多模态大语言模型最基础、也是最核心的应用领域。它要求模型不仅能“看到”图像或视频中的物体更能“理解”它们之间的关系、背后的逻辑以及所处的复杂情境。随着模型能力的增强其应用早已超越了简单的“看图说话”正朝着更专业、更需要深度推理的方向发展。
1、复杂场景与常识推理
现代多模态大语言模型特别是像GPT-4V和Gemini这样的大型闭源模型已经展现出惊人的常识推理能力。它们能够理解图片中的幽默、讽刺和隐含的因果关系。例如向模型展示一张“宇航员在月球上骑马”的图片并提问“这张图有什么不寻常之处?”模型能够准确地指出“马不可能出现在月球上因为月球没有支持马生存所需的大气和生态系统”。这种能力使其在教育、信息检索和内容审核等领域具有巨大潜力。
2、专业领域的视觉分析
将多模态技术应用于专业领域是提升生产效率的关键。当前在多个垂直领域多模态视觉分析已经取得了显著进展。
医疗影像分析:一些研究工作尝试利用多模态模型来分析X光片、CT扫描等医疗影像。通过将影像与对应的诊断报告进行联合训练模型可以学习到识别病灶、辅助医生进行诊断的能力。这有望缓解医疗资源紧张、提升诊断效率。
金融图表分析:金融领域充斥着大量的K线图、财报图表。传统的分析方法依赖于人工解读效率低下且容易出错。以ChartMoE为代表的模型通过在海量的图表数据上进行训练能够精准地回答关于图表的复杂问题如“哪个季度的增长率最高?”或“预测下一阶段的趋势”。这为量化交易、投资分析等场景提供了强大的自动化工具。
自动驾驶感知:在自动驾驶领域多模态模型能够融合来自摄像头、激光雷达(LiDAR)、毫米波雷达等多种传感器的数据形成对周围环境更全面、更鲁棒的理解。这有助于模型在恶劣天气(如雨、雪、雾)或光照不足等单一传感器容易失效的场景下做出更安全的决策。
3、视频内容理解与摘要
随着短视频和流媒体的爆发如何高效地从海量视频中提取信息成为了一个巨大的挑战。多模态大语言模型在视频理解方面展现出巨大潜力。
事件检测与定位:模型能够识别视频中的关键事件(如“进球瞬间”、“颁奖典礼”)并精确定位其在视频中的起止时间。Video-MME等基准专门用于评估这种能力。
视频摘要与问答:对于长视频(如电影、会议记录)模型可以自动生成简洁的内容摘要或根据用户提问快速找到并回答视频中的相关内容(如“CEO在会议的哪个部分讨论了下一季度的财报?”)。这极大地提升了视频信息的检索和利用效率。
高级视觉理解应用领域与关键技术
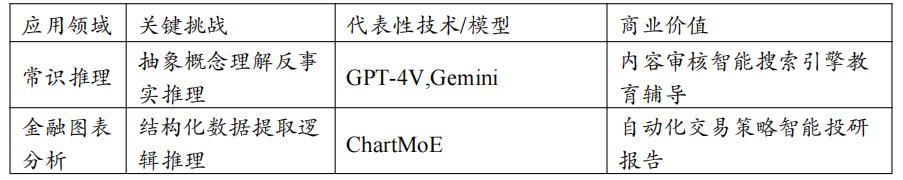
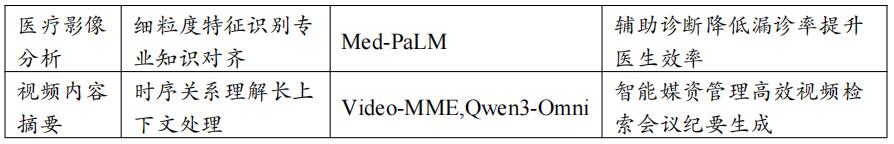
高级视觉理解是多模态技术创造价值的起点。随着模型在专业知识对齐和深度推理能力的进一步提升我们有理由相信它将在更多垂直领域扮演“超级专家”的角色成为各行各业不可或缺的生产力工具。
二、多模态内容创作:人机协同的新范式
视觉理解是让AI“读懂”世界多模态内容创作(Multimodal Content Creation)则是让AI“描绘”世界。2025年随着生成范式(特别是流模型)的革命性突破多模态大语言模型在内容创作领域的角色正从一个简单的“工具”演变为一个深度参与创作流程的“合作伙伴”。这不仅极大地提升了内容生产的效率更催生了全新的创意表达方式。
1、高质量、高效率的图像与视频生成
生成质量和生成速度是衡量内容创作工具好坏的核心标准。2025年的模型在这两方面都取得了巨大飞跃。
图像生成:以JanusFlow为代表的模型通过其创新的“AR + Flow”混合范式实现了在极快的速度下(通常只需1-8个采样步骤)生成与顶级扩散模型(如Midjourney)质量相媲美的图像。这意味着用户几乎可以“实时”地通过文本描述来创造和修改图像极大地提升了设计师、插画师的工作效率。
视频生成:视频生成是更具挑战性的领域。早期的模型(如Sora)虽然效果惊艳但其闭源和高昂的计算成本限制了其应用。2025年以Wan,NExT-OMNI等为代表的开源模型利用统一的流模型框架实现了更高质量、更长时长的文生视频、图生视频。虽然与顶级商业模型仍有差距但其快速的迭代和开源的特性正在推动视频创作的普及化。
2、交错多模态内容的涌现:Mogao的创新
传统的内容创作是“单点式”的即生成一张图或一段视频。而2025年的一个标志性进展是交错多模态内容(Interleaved Multimodal Content)的生成。Mogao在这方面做出了开创性贡献。
Mogao能够生成一个包含文本、图像等多种模态交错出现的长序列。这意味着AI可以:
创作图文并茂的文章:模型可以直接生成一篇完整的、包含标题、段落和配图的博客文章或新闻报道。
生成多模态幻灯片:根据一个主题自动生成包含标题页、目录页、带图表的正文页和总结页的完整演示文稿的“草稿”。
这种能力使得AI不再仅仅是一个被动执行指令的工具而更像一个能够主动规划、组织和表达复杂思想的“创作者”。这为个性化教育材料的生成、自动化新闻撰写、智能营销内容创作等领域打开了全新的想象空间。
3、交互式编辑与精细化控制
专业的内容创作不仅需要生成更需要精确的“修改”。现代多模态大语言模型正在提供越来越精细的交互式编辑能力。
像素级编辑:以VITRON为代表的模型由于其统一的像素级表示能够实现非常精确的图像编辑。用户可以通过简单的文本指令如“把这只猫的颜色变成蓝色”或“移除背景里的路人”来实现类似Photoshop的复杂操作。
风格迁移与属性控制:用户可以提供一张参考图片让模型学习其独特的艺术风格并应用到新生成的内容上。同时也可以通过文本指令精确控制生成人物的姿势、表情、服装等属性。
多模态内容创作应用与技术演进
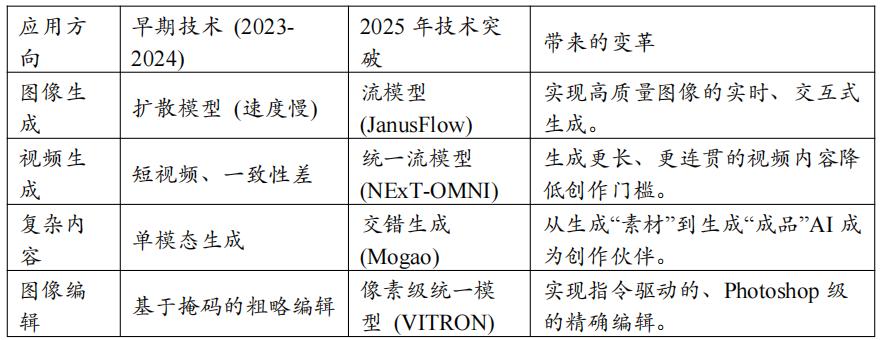
多模态内容创作的革命其核心是降低专业创作的门槛同时提升专业人士的创作效率。随着技术的进一步发展AI与人类创作者的界限将变得越来越模糊。未来的内容创作将是一种人机深度协同、相互启发的新范式这将极大地解放人类的创造力催生出前所未有的艺术形式和内容生态。
三、实时交互式助手:迈向“全能”个人助理
将多模态大语言模型打造成一个能够像人一样自然、流畅地与我们交流的“全能”个人助理是该领域最激动人心的愿景之一。2025年随着模型在实时性、多模态理解和情感表达方面取得的重大突破这一愿景正加速成为现实。其核心应用场景包括智能客服、个人AI助理以及为特殊人群提供辅助。
1、实时视觉-语音交互的突破
传统的多模态交互存在显著的延迟。例如用户说完一句话模型需要先通过ASR(自动语音识别)转成文本再进行LLM处理最后通过TTS(文本到语音)合成声音整个链条耗时数秒体验非常不自然。2025年以VITA-1.5和闭源的GPT-4o为代表的模型在实时交互方面取得了革命性突破。
这些模型的成功关键在于其端到端的统一架构和高效的流式处理能力:
统一建模:它们不再依赖于分离的ASR、LLM和TTS模块而是在一个统一的模型内部直接处理音频波形和视觉信息避免了模块间切换带来的延迟。
流式处理:模型能够以“流”的方式处理输入和输出。用户可以随时打断模型模型也能在思考的同时就开始生成回应从而将响应延迟降低到人类可以接受的数百毫秒级别。
实践案例:VITA-1.5的实时交互
在VITA-1.5的演示中用户可以一边用手机摄像头拍摄周围的环境一边用自然的语音向模型提问:“我眼前这是什么花?”。模型几乎可以瞬间回答:“这是向日葵它的花盘会随着太阳转动。”用户可以立刻追问:“那它旁边那个红色的建筑呢?”模型也能无缝衔接继续进行对话。这种流畅的体验与此前基于“请求-等待-响应”模式的交互形成了鲜明对比。
2、情感交互与个性化
真正的智能助手不仅要“听懂”更要“听出”言外之意。2025年的EMOVA模型在情感交互方面做出了开创性工作。通过其创新的语义-声学解耦的语音分词器EMOVA能够将语音信息分解为“内容”(说了什么)和“声学”(怎么说的)两个部分。这使得模型可以:
理解情感:从用户说话的语调、语速中判断其情绪状态(如高兴、悲伤、焦虑)。
表达情感:在生成语音回应时能够带上符合当前对话氛围的情感。例如在用户表达悲伤时用更轻柔、更富同理心的语气进行安慰。
这种情感交互能力对于智能客服、虚拟伴侣、心理咨询等应用场景至关重要。它使得人机交互不再是冰冷的“信息交换”而更接近温暖的“情感沟通”。
3、面向特殊人群的辅助应用
实时交互式助手在为视障、听障等特殊人群提供信息无障碍服务方面具有巨大的社会价值。
视觉辅助:对于视障用户多模态助手可以成为他们的“眼睛”。用户可以通过佩戴带有摄像头的智能眼镜将看到的画面实时传输给模型。模型则通过语音为用户描述周围的环境、识别物体、朗读路牌和菜单、甚至提醒前方的障碍物。
听觉辅助:对于听障用户模型可以将周围的声音(如门铃、火警、他人的呼唤)实时地转化为文字或震动提醒。在对话中模型也可以将对方的语音实时转化为字幕显示在手机或AR眼镜上。
实时交互式助手的成熟预示着一个“AI-in-the-loop”时代的到来。AI将不再仅仅存在于手机或电脑中而是以一种无处不在、时刻在线的形式深度融入我们的日常生活成为我们感知世界、与世界交互能力的自然延伸。如何确保这些助手的可靠性、安全性以及对用户隐私的保护将是其大规模普及前必须解决的核心问题。
四、具身智能与机器人:从虚拟走向物理
具身智能是多模态技术发展的终极前沿之一。它旨在让AI拥有“身体”能够通过感知物理世界并与之交互来学习和执行任务。这要求模型不仅能处理文本、图像等虚拟信息更能理解和生成在物理世界中执行的“动作”(Action)序列。2025年随着多模态大语言模型与机器人技术的加速融合具身智能正从实验室研究快步走向现实应用其核心是构建能够连接语言指令与物理动作的“世界模型”。
1、世界模型:构建物理世界的内部模拟
“世界模型”(World Model)是具身智能的核心概念。它指的是AI在内部构建的一个关于物理世界如何运作的动态、可预测的模型。通过这个内部模拟AI可以在“脑海中”预演不同动作可能带来的后果从而做出更优的决策而无需在真实世界中进行大量昂贵的试错。
世界模型能主动地预测未来,生成一个可交互、符合物理规律的“虚拟沙盒”。这为具身智能体提供了一个近乎无限的、安全的、低成本的训练环境,从而根本上解决了数据稀缺和真实世界训练风险高的核心痛点。
世界模型的核心思想是让智能体在内部构建一个关于外部世界的动态模型。智能体可以利用这个内部模型进行“心理推演”或“前瞻性规划”,在不与真实世界交互的情况下,预测不同动作序列可能导致的结果,从而选择最优策略。2025年,多个里程碑式的世界模型相继发布,将这一概念推向了新的高度。
2025年代表性世界模型对比:
Google Genie 3标志着世界模型进入了实时交互的时代。它能够从文本、图像甚至草图中生成720p高清、可实时探索的虚拟世界。其最令人印象深刻的能力在于长时域一致性,即使用户在虚拟世界中漫游数分钟,场景中的物体和环境依然能保持物理上的一致性,不会出现明显的漂移或错乱。此外,Genie 3引入的“可提示的世界事件”允许用户通过文本指令动态改变世界状态(如改变天气),为智能体训练提供了更丰富的交互维度。
腾讯混元HY-World 1.5是完全开源的实时交互世界模型。它以24 FPS的流畅帧率运行,并着重解决了“长期几何一致性”这一核心难题,确保了场景在长时间交互下的稳定性。HY-World 1.5的开源策略意义重大,它提供了一套从数据处理到模型训练再到推理优化的完整框架,极大地降低了社区研究和开发世界模型的门槛,推动了该技术的民主化。
中科院与CreateAI联合发布的NeoVerse则在4D世界建模上取得了突破。它创新性地实现了仅通过采集的普通单目视频,在30秒内快速构建一个包含时间维度的4D世界表示。这项技术摆脱了对昂贵的多视角采集设备或激光雷达数据的依赖,使得大规模、低成本地构建4D数字孪生成为可能,在自动驾驶、城市管理和机器人导航等领域具有巨大的应用潜力。
由AI先驱李飞飞创立的World Labs推出的Marble是世界模型商业化的首次重要尝试。它定位为一个面向艺术家、设计师和开发者的3D世界创建工具,用户可以通过多模态输入(文本、图像等)快速生成高保真的3D世界,并进行迭代编辑和分享。Marble的出现,标志着世界模型技术正从实验室研究走向创造经济的实际生产力工具。
这些世界模型的出现,为具身智能的发展铺平了道路。智能体可以在这些高度逼真且符合物理规律的虚拟世界中进行数百万次的试错和学习,其获得的经验和技能可以更有效地迁移到真实世界中,从而大大加速通用人工智能(AGI)的实现进程。
2、语言指令到物理动作的转化
具身智能的一个核心挑战是如何将人类用自然语言下达的模糊指令(如“把桌子收拾干净”)转化为机器人可以理解和执行的一系列精确的物理动作(如“识别所有盘子和杯子”、“规划抓取路径”、“将它们放入水槽”)。
多模态大语言模型在其中扮演了“翻译官”和“任务规划师”的角色:
场景理解:模型首先通过摄像头“看懂”当前的物理环境识别出桌子、盘子、杯子等关键物体及其空间关系。
任务分解:LLM骨干网络利用其强大的常识和逻辑推理能力将“收拾干净”这个高级指令分解为一系列具体的子任务。
动作生成:对于每个子任务模型会生成对应的机器人控制代码或动作原语(Action Primitives)。
3、模拟器与真实世界的鸿沟(Sim-to-Real Gap)
由于在真实世界中收集机器人训练数据的成本极高且风险巨大绝大多数具身智能模型的训练都在高逼真度的物理模拟器(如NVIDIA Isaac Sim)中完成。然而模拟环境与真实世界之间始终存在差异(如光照、摩擦力、物体材质等)这导致在模拟器中表现完美的模型在真实机器人上部署时往往会失败。如何弥合这一“模拟到现实的鸿沟”(Sim-to-Real Gap)是具身智能落地的关键挑战。
当前的解决方案主要包括:
域随机化(Domain Randomization):在模拟器中故意将环境的各种参数(如光照、纹理、物理参数)进行随机化从而让模型学习到对环境变化更鲁棒的策略。
少量真实世界微调:在模拟器中完成大规模预训练后再在真实机器人上进行少量的、针对性的微调以适应真实世界的特性。
具身智能是多模态技术最具想象力、也最具挑战性的应用方向。它代表着AI从数字世界向物理世界的终极跨越。2025年我们看到了多模态大语言模型与机器人技术的深度融合为解决这一终极挑战带来了新的曙光。虽然距离电影中那样的通用人形机器人还有很长的路要走但技术发展的车轮已经开始加速。未来具备物理实体的AI将深刻地改变我们的生产方式、生活方式乃至整个社会结构。
本报告共计分为“序言、多模态大语言模型发展历程、核心技术架构与训练方法的进化、数据来源与评估基准、应用场景与实践、当前挑战与未来展望”六大部分内容。本文为“应用场景与实践”内容节选。
完整版报告,请扫描下方二维码下载。
END