多模态大语言模型的当前挑战与未来展望
在经历了2025年的爆发式增长后多模态大语言模型技术在取得辉煌成就的同时也逐渐暴露出其在技术、应用和伦理层面面临的一系列深层次挑战。对这些挑战的清醒认识是确保该领域能够持续、健康发展的必要前提。
本文首先将系统性地剖析当前多模态技术在计算资源、数据、模型能力和安全伦理四个维度所面临的核心挑战。在此基础上结合前沿的探索性研究对多模态技术的未来演进方向进行展望重点探讨其在构建更通用世界模型、迈向自主智能以及与其他AI技术融合方面的巨大潜力。
一、当前挑战:通往通用智能之路的障碍
尽管多模态大语言模型已经展现出惊人的能力但距离实现真正通用、可靠、安全的人工智能仍然面临着诸多严峻的挑战。
1、计算与资源的“诅咒”
模型规模的持续膨胀带来了对计算资源无止境的需求这已成为限制技术发展和普及的最大障碍之一。
高昂的训练成本:训练一个如Qwen3-Omni级别的先进模型需要数千甚至上万个顶级GPU进行数周乃至数月的计算。这使得只有少数科技巨头和国家级实验室能够参与到这场“军备竞赛”中极大地限制了学术界和中小型企业的创新空间。
严峻的推理挑战:即使模型训练完成其巨大的尺寸也给部署和推理带来了巨大压力。要在个人电脑甚至移动设备上运行这些模型需要进行复杂的模型压缩和量化而这往往会以牺牲性能为代价。如何开发出更高效的模型架构和推理引擎是决定多模态技术能否真正“飞入寻常百姓家”的关键。
算泥社区定位为“AI 大模型开发服务+算法+算力”三位一体的 AI 开发者社区,提供国产异构算力服务,使其有可能在这一趋势中扮演重要角色。通过整合英伟达、寒武纪等多种 AI 芯片,并利用异构计算技术,社区为开发者提供了一种稳定、高效的算力资源选择。这在开发者训练或微调模型、应对高昂推理成本等现实挑战中,提供了一个规避“卡脖子”风险的潜在解决方案。未来,这类平台与国产硬件厂商的深度合作,以及对异构调度能力的持续优化,将是其发展的关键观察点。
2、数据的“瓶颈”与“偏见”
数据是AI的燃料而当前多模态模型正面临着数据上的双重困境。
高质量视频与交错数据的稀缺:虽然我们拥有海量的网络图文数据但高质量、多样化的视频数据特别是包含精确时间戳和动作标注的视频仍然极度稀缺。此外用于训练多模态生成的图文音混合长序列数据几乎完全依赖于成本高昂的人工构建或合成。这种数据瓶颈是限制模型在动态理解和复杂内容创作方面能力提升的主要原因。
数据偏见与公平性:网络数据不可避免地反映了现实世界中存在的社会、文化和历史偏见。在这些数据上训练出的模型可能会无意中学习并放大这些偏见例如在生成图像时表现出刻板印象或在理解不同口音的语音时存在能力差异。如何检测、量化并缓解这些数据偏见是一个亟待解决的技术和伦理难题。
3、模型能力的“幻觉”与“脆弱”
尽管模型在许多基准上取得了超人的表现但其能力边界仍然存在明显的“软肋”。
幻觉问题(Hallucination):这是所有大模型都存在的通病。在多模态场景下幻觉表现为模型“看到”或“听到”了不存在的东西或者对图像内容进行与事实完全不符的描述。虽然MME等基准的设计在一定程度上可以抑制幻觉但如何从根本上让模型“知之为知之不知为不知”仍然是一个开放性问题。
对微小扰动的脆弱性:研究表明许多多模态模型对输入中微小的、人眼难以察觉的扰动(即“对抗性攻击”)非常敏感。例如在图像中加入一些精心设计的噪声就可能让模型将其完全识别成另一种物体。这种脆弱性使得在自动驾驶、医疗诊断等高风险安全攸关领域的应用充满了隐患。
物理世界常识的缺乏:尽管模型学习了海量的知识但它们对物理世界的基本规律(如物体恒存性、因果关系、力的作用)的理解仍然非常肤浅。这在具身智能领域表现得尤为突出机器人常常会犯一些在人类看来匪夷所思的“低级错误”。
4、安全与伦理的“红线”
随着模型能力的日益强大其被滥用的风险也与日俱增对社会安全和伦理规范构成了前所未有的挑战。
深度伪造(Deepfake)与信息操纵:高质量的图像、视频、音频生成技术可能被用于制造虚假新闻、进行身份欺诈、或传播恶意政治宣传对社会信任和公共安全构成严重威胁。
隐私泄露:实时交互式助手需要持续地访问用户的摄像头和麦克风这带来了巨大的隐私泄露风险。如何确保这些敏感数据在设备端得到妥善处理防止被滥用或泄露是赢得用户信任的前提。
责任界定:当一个由AI驱动的自动驾驶汽车发生事故或一个AI辅助诊断系统出现误诊时责任应该如何界定?是算法的设计者、训练数据的提供者还是最终用户?缺乏清晰的法律和伦理框架将阻碍这些技术的进一步应用。
多模态大语言模型当前面临的核心挑战
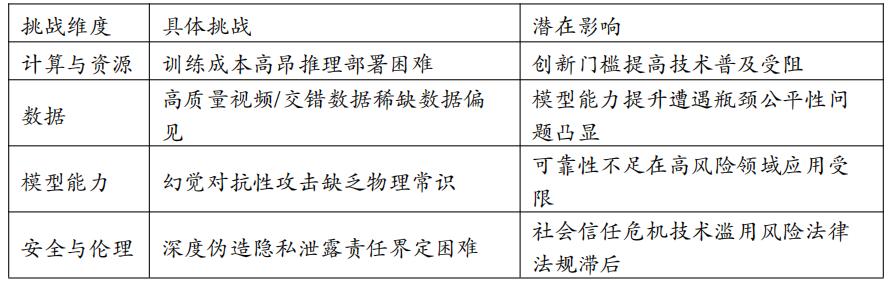
对这些挑战的克服不可能一蹴而就。它需要算法、硬件、数据、法律和伦理等多个层面的协同努力。只有正视这些障碍并以负责任、审慎的态度去解决它们多模态技术才能真正行稳致远最大限度地释放其造福社会的潜力。
二、未来展望:迈向更通用、更自主的智能
尽管挑战重重但多模态大语言模型展现出的巨大潜力依然让我们对人工智能的未来充满期待。站在2025年的时间节点上我们可以预见未来的技术演进将主要围绕着构建更通用的“世界模型”、追求更高级的“自主智能”以及与其他AI技术进行更深度的“融合创新”这三大主线展开。
1、世界模型:从“感知”到“理解”物理世界
构建能够模拟和预测物理世界动态的“世界模型”是具身智能的终极目标也是多模态技术未来最重要的发展方向之一。未来的世界模型将呈现以下趋势:
更丰富的模态融合:当前的世界模型主要融合视觉、语言和动作。未来的模型将进一步整合触觉、力觉、声音等更丰富的传感器信息以构建对物理世界更全面、更细致的内部表征。
从模拟器到真实世界的飞跃:解决“Sim-to-Real”的鸿沟将是未来数年的研究重点。通过开发更高逼真度的模拟器、更有效的域适应技术以及更高效的真实世界数据收集策略(如让机器人在安全的环境中自主探索和学习)模型将逐步摆脱对模拟器的依赖。
涌现的物理常识:随着模型在更大规模、更多样化的物理交互数据上进行训练我们有望看到模型“涌现”出对物理规律更深层次的、符合直觉的理解。这将使其能够在全新的、未曾见过的场景中做出更合理、更安全的决策。
2、自主智能:从“执行者”到“规划者”
当前的多模态模型在很大程度上仍是一个被动的“执行者”需要人类给出明确的指令。未来的发展方向是赋予模型更高层次的自主性(Autonomy)使其能够成为一个主动的“规划者”和“决策者”。
主动学习与探索:未来的模型将具备主动探索未知环境、识别自身知识盲点并提出有价值问题的能力。例如一个家庭服务机器人在遇到一个不认识的物体时可以主动向用户提问:“这是什么?我应该如何处理它?”。这种主动学习的能力将使其能够持续地、终身地获取新知识。
长期任务规划:模型将能够理解和规划需要数小时、数天甚至更长时间才能完成的复杂任务。例如用户可以给出“帮我策划一个为期一周的巴黎旅行”这样的高级指令模型能够自主地完成信息检索、行程规划、酒店预订、撰写攻略等一系列子任务。
AI Agent的兴起:多模态大语言模型将成为驱动各种AI Agent(智能代理)的核心大脑。这些Agent将在数字世界(如自动完成在线购物、管理日程)和物理世界(如自动驾驶、机器人)中代表人类自主地执行任务成为无处不在的“数字员工”和“物理劳工”。
3、融合创新:与其他AI技术的协同进化
多模态大语言模型并非孤立发展的技术其未来的巨大潜力在于与其他AI技术的深度融合。
与强化学习的融合:强化学习(Reinforcement Learning,RL)提供了让模型通过试错来学习最优策略的强大框架。将LLM的通用知识和推理能力作为强化学习智能体的“先验知识”可以极大地提升其学习效率和泛化能力这在游戏AI和机器人控制领域已经展现出巨大潜力。
与知识图谱的融合:知识图谱(Knowledge Graphs)能够以结构化的方式存储和表示世界知识。将多模态模型与知识图谱相结合一方面可以利用知识图谱为模型提供更准确、更可解释的知识来源缓解“幻觉”问题;另一方面也可以利用模型从非结构化的多模态数据中自动抽取和更新知识构建更全面、更及时的知识图谱。
与脑机接口的融合:这是一个更具科幻色彩但潜力巨大的远景。通过脑机接口(Brain-Computer Interface,BCI)人类的思想可以直接与多模态大语言模型进行交互。这不仅可能为残障人士提供前所未有的交流和控制能力更有可能从根本上重塑人机交互的定义实现真正意义上的“人机共生”。
三、结语
2025年我们正站在一个由多模态大语言模型开启的、波澜壮阔的新时代的入口。技术的发展正以前所未有的速度将曾经只存在于科幻作品中的想象变为现实。从“感知”到“理解”从“执行”到“规划”从“工具”到“伙伴”多模态技术正引领人工智能迈向一个更通用、更自主、更深度融入人类社会的新纪元。
这条道路上机遇与挑战并存。技术的突破需要仰望星空的想象力更需要脚踏实地的严谨和对伦理红线的敬畏。我们有理由相信在全世界研究者、开发者和决策者的共同努力下多模态人工智能技术必将行稳致远成为推动人类文明向前发展的、一股强大而向善的力量。本报告的撰写正是希望为这一伟大的历史进程提供一份系统性的思考和一份审慎的展望。
本报告共计分为“序言、多模态大语言模型发展历程、核心技术架构与训练方法的进化、数据来源与评估基准、应用场景与实践、当前挑战与未来展望”六大部分内容。本文为“当前挑战与未来展望”内容节选。
完整版报告,请扫描下方二维码或点击【阅读原文】下载。
END