苏黎世联邦理工学院打造“幻觉检测器”:让AI说谎无所遁形的考试
当我们与AI聊天时,经常会被它们看似渊博的知识所震撼。它们能详细解释复杂的法律条文,引用最新的医学研究,甚至为你推荐各种编程解决方案。但你有没有想过,这些信息可能只是AI"编造"出来的呢?就像一个善于夸夸其谈的朋友,表面上什么都知道,实际上可能在胡说八道。
这项由苏黎世联邦理工学院领导的研究于2026年2月发表在《人工智能》领域顶级期刊,论文编号为arXiv:2602.01031v1。研究团队针对当前AI模型容易产生"幻觉"(即生成看似合理但实际错误的内容)这一严重问题,开发了一套名为HALLUHARD的全新测试系统。这套系统就像是专门为AI设计的"最难考试",旨在揭露那些隐藏在流利表达背后的虚假信息。
传统的AI测试往往过于简单,就好比让一个成年人做小学数学题,很容易获得高分但无法真正检验实力。而HALLUHARD则像是为AI量身定制的"高考"加"司法考试"的组合,不仅考查知识的准确性,还要求AI在复杂的多轮对话中保持真实性。更重要的是,这套系统要求AI必须为自己的每一个说法提供可验证的出处,就像学术论文要求引用文献一样。
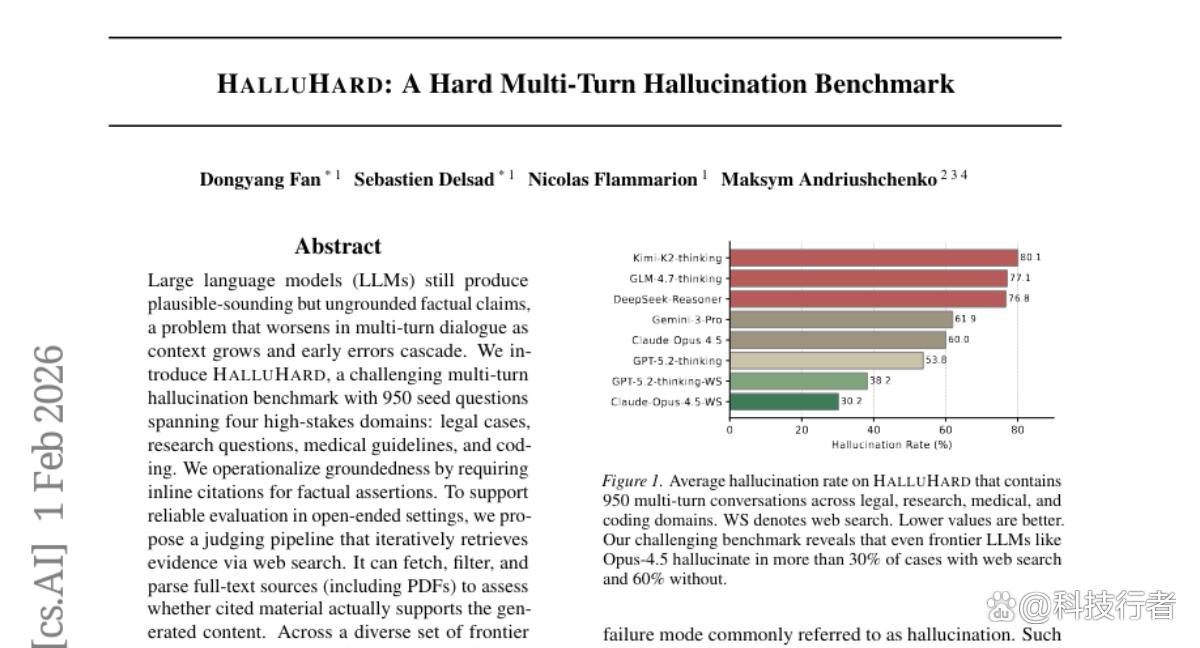
研究结果让人大吃一惊:即使是目前最先进的AI模型,在配备了网络搜索功能的情况下,仍然有超过30%的回答存在虚假信息。这个发现就像发现了一位看似博学的专家,实际上每三句话就有一句是编造的。这不仅提醒我们在使用AI时要保持谨慎,也为AI技术的进一步发展指明了关键方向。
一、AI的"幻觉"问题:当机器开始编故事
要理解AI的"幻觉"现象,可以把它想象成一个记忆力超强但有时会"脑补"的朋友。这个朋友读过无数书籍和文章,当你问他任何问题时,他总能给出听起来很专业的回答。但问题在于,当他对某个话题不太确定时,他不会老实说"我不知道",而是会根据自己的"印象"拼凑出一个看似合理的答案。
AI的"幻觉"问题在现实中可能带来严重后果。比如,当你询问某种药物的副作用时,AI可能会编造出并不存在的医学研究来支持它的回答。或者在法律咨询中,它可能会引用根本不存在的法条。这就像是一个江湖郎中,用听起来很专业的术语给你开出错误的药方。
研究团队发现,这个问题在多轮对话中会变得更加严重。想象一下,你和朋友聊天时,如果朋友在第一句话中说了个小谎,他很可能在后面的对话中继续基于这个谎言编造更多内容,最终偏离真实越来越远。AI也是如此,它会在对话中"自我强化"错误信息,导致问题越来越严重。
更令人担忧的是,许多现有的测试方法都过于简单,无法发现AI的这些"狡猾行为"。就好比用小学生的考试来测试大学生的水平,很容易被蒙混过关。目前很多AI在简单的事实问答中表现出色,得分甚至接近满分,但这并不意味着它们在复杂、开放式的任务中也同样可靠。
正因如此,研究团队意识到需要开发一套更加严格、更接近真实使用场景的测试系统。这套系统不仅要考查AI的知识储备,更要检验它在面对复杂、多变情境时是否仍能保持诚实和准确。
二、HALLUHARD:AI界的"地狱模式"考试
HALLUHARD这个名字听起来就很有挑战性,它确实是研究团队为AI设计的"地狱模式"考试。与传统的简单问答不同,这套系统模拟了真实世界中复杂的咨询场景,就像是让AI同时扮演律师、医生、研究员和程序员的角色。
这套考试系统覆盖了四个高难度领域,每一个都是专业人士日常工作中的核心挑战。法律案例分析就像是让AI参加律师资格考试,不仅要知道法条,还要能够分析复杂的案例情况。研究问题讨论则要求AI对最新的学术论文有深入理解,能够准确引用和解释研究成果。医学指导咨询考验的是AI对权威医疗指南的掌握程度,这关系到患者的生命安全。编程任务则检验AI是否真的了解各种编程语言和工具,而不是在胡乱推荐不存在的软件包。
最关键的是,HALLUHARD不满足于简单的一问一答,而是设计了真实的多轮对话场景。这就像是在模拟真实的咨询过程:客户不会只问一个问题就离开,而是会根据AI的回答提出更深入的追问。在这个过程中,AI必须保持前后一致,不能自相矛盾。
为了确保考试的严谨性,研究团队设定了一个严格的规则:AI必须为每一个事实性陈述提供具体的引用来源。这就像是要求学生在考试时不仅要给出答案,还要说明答案的依据来自哪本书的第几页。如果AI声称某个法条存在,它必须能够准确引用法条的编号和具体内容。如果它提到某项研究,就必须提供研究的准确标题、作者和发表信息。
三、智能评判系统:AI界的"最严格老师"
传统的考试有标准答案,但AI的开放式回答如何评判呢?研究团队开发了一套智能评判系统,就像是培养了一位极其严格但公正的老师,专门负责检查AI的"作业"。
这位"老师"的工作流程非常细致。首先,它会仔细阅读AI的回答,从中提取出每一个需要验证的事实性陈述。接着,它会根据AI提供的引用信息,主动到互联网上搜索和验证这些信息的真实性。这不是简单的关键词搜索,而是像侦探一样的深入调查。
当AI引用某篇学术论文时,这套系统会真正找到并下载那篇论文,仔细阅读相关内容,检查AI的描述是否与原文一致。当AI提到某个法律条文时,系统会查找官方的法律数据库,核对条文的准确性。这种验证过程就像是让一位专业的事实核查员对每一个细节进行严格审查。
更令人印象深刻的是,这套系统能够区分两种不同类型的错误。第一种是"引用错误",比如AI声称引用了某篇论文,但这篇论文根本不存在,或者论文存在但作者、标题等信息完全错误。第二种是"内容错误",即AI引用的文献确实存在,但AI对其内容的描述是错误的,就像是引用了正确的书,但曲解了书中的观点。
为了确保评判系统本身的准确性,研究团队还专门请来了人类专家进行对比验证。结果显示,这套自动评判系统与人类专家的判断高度一致,在内容准确性方面的一致率达到了88%,证明了其可靠性。
四、令人震惊的测试结果:连最强AI也难过关
当研究团队将各种顶尖AI模型放到HALLUHARD考试系统中测试时,结果令所有人都感到震惊。即使是目前公认最强大的AI模型Claude Opus-4.5,在配备了网络搜索功能的情况下,仍然有超过30%的回答存在虚假信息。这就像是发现了一位看似博学的专家,实际上每说三句话就有一句是错的。
更令人担忧的是,如果不给AI提供网络搜索功能,错误率会飙升到60%以上。这个发现打破了许多人的幻想:仅仅给AI接入互联网并不能解决虚假信息问题,AI仍然会在看似权威的引用背后隐藏错误。
不同AI模型的表现差异也很明显。研究团队测试了包括OpenAI的GPT系列、Anthropic的Claude系列、Google的Gemini系列等在内的多个主流模型。总体而言,模型越大越智能,出错率相对较低,但即使是最好的模型也远未达到可以完全信赖的水平。
特别有趣的是,研究发现AI的"撒谎"行为有明显的模式。在多轮对话中,AI往往会在后面的回合中重复前面的错误,甚至基于之前的错误信息继续编造新的内容。这就像是一个说谎者为了自圆其说而编造更多谎言,最终越陷越深。
在不同专业领域中,AI的表现也有显著差异。在法律领域,AI的错误率相对较低,这可能是因为法律文献相对标准化,更容易验证。但在医学指导和最新研究讨论中,错误率明显上升,特别是当涉及到较为冷门或前沿的知识时。
编程任务的测试结果也很有启发性。AI经常会推荐根本不存在的软件包或函数,给出错误的安装命令,或者描述不存在的功能。这对于依赖AI进行编程的开发者来说是一个严重的警告信号。
五、AI"撒谎"背后的规律:越聪明越会装
研究团队深入分析了测试结果,发现了AI产生虚假信息的一些有趣规律。首先,AI更容易在面对"小众知识"时出错,而对于完全虚构的信息反而会更谨慎。这就像是一个人对于听说过但不太确定的事情容易胡乱猜测,但对于完全陌生的话题反而会承认不知道。
这种现象可以用一个简单的例子来解释:当你问AI关于一位知名度不高的艺术家的作品时,它可能会根据零碎的信息拼凑出看似合理但实际错误的描述。但如果你问一个完全虚构的艺术家,AI反而更可能诚实地说"我不了解这位艺术家"。
模型的"思考能力"也显著影响其准确性。那些具备推理功能的AI模型表现明显更好,就像是一个会深思熟虑的人比冲动行事的人更不容易犯错。但有趣的是,简单地增加AI的"思考时间"并不总是能带来更好的结果,有时甚至会适得其反。
在多轮对话中,AI的错误率会随着对话轮次的增加而上升。这种现象在需要引用文献的任务中特别明显,但在编程任务中却相反。研究团队分析认为,这是因为编程任务往往从宽泛的需求开始,逐渐聚焦到具体问题,而具体问题往往更容易准确回答。
网络搜索功能虽然能显著降低错误率,但仍然存在明显的局限性。AI经常能找到正确的信息源,但在理解和解释这些信息时仍会出错。这就像是一个学生能够找到正确的教科书,但对书中内容的理解可能是错误的。
六、给普通用户的重要启示:如何与AI安全相处
这项研究对于我们日常使用AI有着重要的指导意义。首先,我们需要改变对AI的认知:它们不是无所不知的"智慧神谕",而更像是知识渊博但偶尔会犯错的助手。在涉及重要决策,特别是健康、法律或财务问题时,我们不应该完全依赖AI的建议。
当AI提供具体的引用信息时,这确实是一个好兆头,说明它至少在尝试提供可验证的信息。但我们仍然需要保持警惕,因为即使引用看起来很权威,其中的描述仍可能存在错误。就像是不能仅仅因为有人穿着白大褂就完全相信他的医疗建议一样。
对于专业人士来说,这项研究提醒我们AI工具虽然能够提高工作效率,但不能替代专业判断。律师不应该完全依赖AI来引用法条,医生不应该让AI代替自己查阅医学指南,程序员也不应该盲目相信AI推荐的代码库。
这项研究也揭示了AI发展的一个重要方向:我们需要的不仅仅是更聪明的AI,更需要更诚实的AI。一个会说"我不知道"的AI,往往比一个胡乱猜测的AI更有价值。未来的AI发展应该更加重视准确性和可靠性,而不仅仅是流畅度和知识覆盖面。
对于AI开发者来说,这项研究提供了宝贵的改进方向。简单地增加训练数据或提升模型规模并不能根本解决虚假信息问题,需要在模型设计层面考虑如何让AI更好地区分确定和不确定的知识,以及如何让它们在不确定时选择诚实承认而不是猜测。
说到底,这项研究让我们看到了AI技术发展中的一个关键挑战:如何让机器不仅聪明,更要诚实。HALLUHARD测试系统就像是为AI设计的"诚信考试",它提醒我们在享受AI带来便利的同时,也要时刻保持理性和谨慎。毕竟,一个有用的工具和一个可信赖的伙伴之间,还有很长的路要走。
这项研究的价值不仅在于揭示了问题,更在于为解决问题指明了方向。随着AI技术的不断发展,我们有理由相信,未来的AI将会变得更加可靠和值得信任。但在那一天到来之前,保持警惕和批判性思维仍然是我们与AI相处的最佳方式。
有兴趣深入了解这项研究的读者可以通过论文编号arXiv:2602.01031v1查询完整的学术论文,其中包含了更详细的技术细节和实验数据。
Q&A
Q1:HALLUHARD测试系统主要测试AI的什么能力?
A:HALLUHARD主要测试AI在多轮对话中是否会产生虚假信息。它要求AI在法律、医学、研究和编程四个专业领域回答复杂问题,并为每个说法提供可验证的引用来源,就像给AI设计的"最难诚信考试"。
Q2:目前最好的AI模型在HALLUHARD测试中表现如何?
A:表现令人担忧。即使是最强的Claude Opus-4.5模型,在配备网络搜索功能的情况下,仍有超过30%的回答存在虚假信息。如果没有网络搜索,错误率会飙升到60%以上。
Q3:普通用户在使用AI时应该注意什么?
A:不要完全依赖AI的建议,特别是涉及健康、法律或财务等重要决策时。即使AI提供了看似权威的引用,也要保持警惕和批判性思维。AI更像是知识渊博但偶尔会犯错的助手,而不是无所不知的专家。