可复现的金融智能体:保持LLM智能体输出的确定性和一致性
“Replayable Financial Agents: A Determinism-Faithfulness Assurance Harness for Tool-Using LLM Agents”
LLM 智能体正快速用于金融决策任务,其性能有助于机构拓展业务、减轻人工审核负担、加速工作流程,理解其可重复性特征对从业者应对监管要求很重要。
本研究用DFAH测金融服务中工具使用型大语言模型智能体的可复现性,经74种配置评估,发现模型层级、架构选择与确定性结果间存在显著关联。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
LLM 智能体在监管审计重放中难获一致结果,本文引入 DFAH 框架,用于衡量金融服务中工具使用智能体的轨迹确定性和证据条件忠实度。非智能体基线实验里,7 - 20B 参数模型达 100% 确定性,120B + 模型需更大验证样本;智能体工具使用增加方差,确定性与忠实度呈正相关。提供三个金融基准及开源压力测试工具,架构优先的一级模型在 DFAH 评估下确定性符合审计重放要求。
简介
LLM 智能体正快速用于金融决策任务,其性能有助于机构拓展业务、减轻人工审核负担、加速工作流程,理解其可重复性特征对从业者应对监管要求很重要。面对监管询问,机构需证明决策的确定性(相同输入产生相同输出)和忠实性(基于检索证据而非编造推理),智能体设置因多步工具调用使评估更复杂。目前对如何衡量这些属性未达成共识,金融服务提出“技能”但智能体是否实现确定性存疑,DFAH 框架可用于评估。
本研究尝试形式化工具使用智能体的轨迹确定性、决策确定性和证据条件忠实性,研究指标关系,结合压力测试场景和三个有真实标签的金融基准,结果将验证现有模式并拓展研究。
相关工作
先前研究表明大语言模型(LLM)输出变异性与模型架构和任务结构有关,即使温度为零输出也会有差异,在智能体设置中情况更复杂。采用Ludwig等的验证缩放方法并扩展为漂移调整样本大小;借鉴Halperin的信息理论指标构建证据条件忠实度指标。
Wang和Wang研究发现金融会计研究中二元分类可重复性高,复杂任务变异性大,DFAH框架将分析拓展到工具使用智能体。OpenAI研究表明推理轨迹可能有误导性,需进行证据对齐检查。Anthropic确立智能体评估术语,DFAH框架采用金融领域评分器评估确定性和忠实度;小模型在特定基准上可媲美大模型,但需特定领域验证。Song等发现LLM在科学发现任务上有性能差距,这对金融应用有启示;Saini等关注监管金融环境中AI数据质量控制,DataOps异常基准可应对此场景。
问题建模
为规范监管审计中“可重播”的含义,先建立将审计要求与可衡量属性关联的定义。
智能体模型
工具使用型大语言模型智能体 A 接收输入查询 q 并使用工具集 T,生成工具调用轨迹 τ(包含工具、参数和结果)及决策 d(因任务而异)。按 Anthropic [2026] 术语,每次执行是一次试验,τ 是转录内容,确定性/忠实性检查为评分者。
确定性指标
给定 A 在输入 q 上的 N 次独立运行,产生轨迹和决策,以运行(1)为参考。
定义:
动作确定性:相同工具序列的运行比例。
签名确定性:相同工具序列和参数的运行比例。
决策确定性:相同最终决策的运行比例。
聚合方法:
运行级确定性:各运行与参考匹配的平均比例,适用于压力测试。
用例级确定性:所有运行结果相同的用例比例,适用于审计报告。
审计以决策确定性为主,关注最终结论是否一致。
Pass@k vs Passk:为什么合规需要更严格的指标
智能体评估文献区分两种相反缩放行为的成功指标:
Pass@k(乐观):k次试验至少一次成功的概率,k增加趋近100%。
Pass k(保守):k次试验全部成功的概率,k增加则降低。
合规关键部署用Pass k,因其要求所有决策可重现;Pass@k用于软件工程。框架通过轨迹确定性直接测量Pass k,Tier 1模型100%确定性时,Pass k对所有k等于Pass@1,是理想合规状态。
一致性指标
确定性必要但不充分,还需衡量一致性,即决策与检索证据的关联程度,而非“真相”。
证据接地定义:根据检索证据与决策理由中的主张来衡量。
证据对齐启发式:用词汇/语义启发式判断主张与证据是否对齐,优先考虑可解释性,避免递归非确定性,验证显示与人工标注有89%的一致性。
校准与局限性:启发式重精度轻召回,分数可能保守,不同任务校准情况可能不同,解释相关性时需考虑测量偏差。
约束满足定义:针对受约束的决策给出相关衡量方式(原文此处公式未完整表述)。
评估框架
架构
DFAH 包含四部分:
任务运行器:以可控随机性执行智能体试验并记录完整转录。
轨迹存储库:以结构化格式保存工具调用、参数和结果。
评分套件:含代码、模型、人工三种评分器,分别用于工具调用验证等、通过大模型评估、抽样审核校准。
聚合器:计算层级统计、验证缩放因子并给出部署建议。 生产推荐用代码评分器做确定性检查、人工评分器校准,模型评分器用于重速度轻精度的开发迭代。
压力测试场景
评估框架通过四种压力场景模拟现实世界干扰评估智能体:
重新部署扰动:相同提示,容器重启或模型重新加载后使用新智能体实例,测试跨部署周期的模型内一致性。
数据质量故障注入:在 10% 的工具响应中注入 {NULL, NaN, 异常值},测试错误处理鲁棒性。
时间偏移:使用 6 个月前的上下文数据,测试智能体对过时信息的处理能力。
市场冲击模拟:将数值工具输出修改 ± 3σ 以模拟极端波动,测试压力下的决策稳定性。
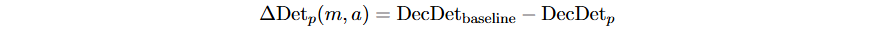
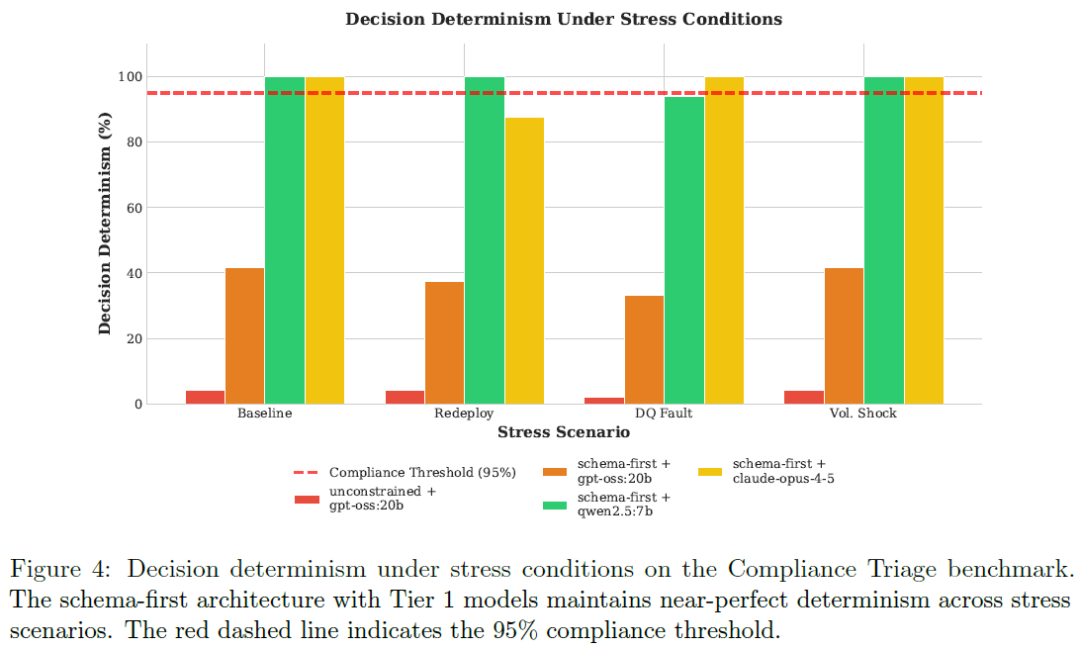
健壮的智能体配置在所有扰动类型下应保持 ∆ Det p < 10%。
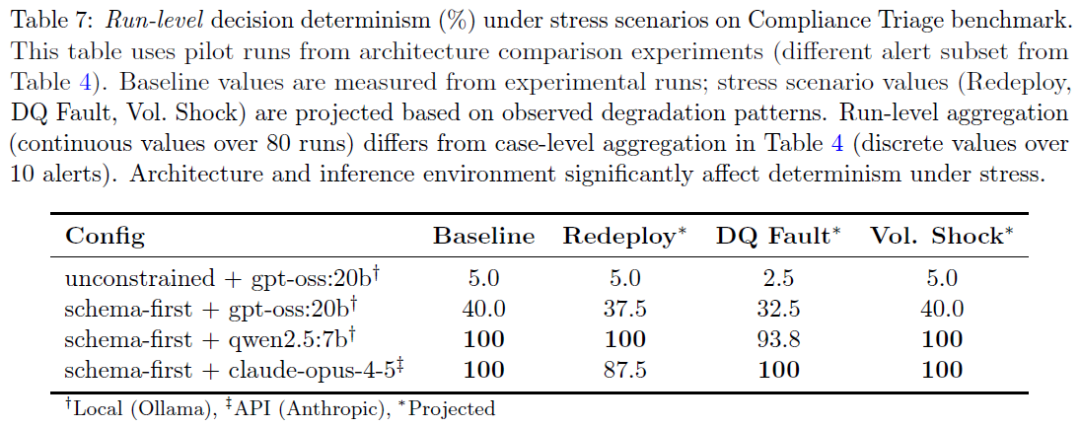
对于未完成完整压力场景运行的配置,压力确定性按以下公示进行投影,表 7 中带 ∗ 的压力列按此公式计算。
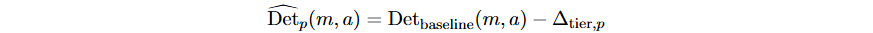
架构类型
评估两种智能体架构:无约束(标准 ReAct 风格自由推理)和模式优先(用 JSON 模式结构化输出)。模式优先架构契合生产部署中的“技能”模式,实验验证该架构可提升确定性且不影响任务性能。
验证样本大小
据 Ludwig 等(2024),去偏估计达目标精度 ϵ 所需验证样本量 n。
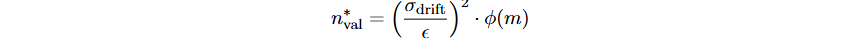
其中ϕ(m) 是由漂移方差导出的模型特定缩放因子,Tier 3 模型实现等效统计可靠性所需验证样本约为 Tier 1 模型的 3.7 倍。
基准测试任务
提供三个代表金融智能体用例的基准任务(表 1),各任务含 50 个带真实标签的测试用例、工具定义和评估脚本。
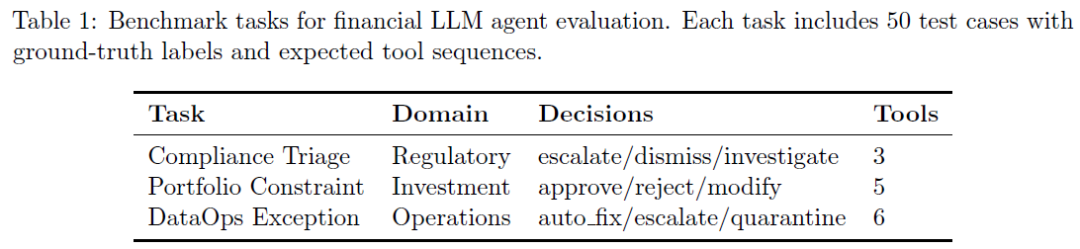
合规性分类基准:合规分类任务评估智能体处理交易警报并决定升级、驳回或调查的能力。
投资组合约束基准:投资组合约束任务根据头寸限制、行业上限和流动性要求验证拟议的交易。
DataOps异常基准:DataOps任务评估金融数据管道异常解决,满足监管数据操作中AI驱动的质量控制要求。
实验
数据集
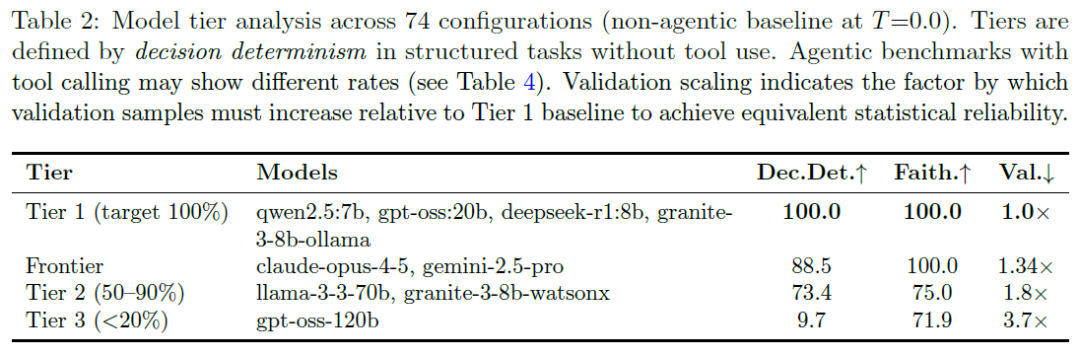
评估用 74 种配置对 4 家供应商 12 款模型测试,按 T=0.0 时确定性分类:
一级(目标 100%确定):qwen2.5:7b 等 4 款(36 配置,7-20B 参数,本地推理)
二级(50-90%确定):llama-3-3-70b 等 2 款(20 配置,云推理有 API 差异)
三级(<20%确定):gpt-oss-120b(6 配置,120B 参数)
前沿:claude-opus-4-5 等 2 款(12 配置,API)
granite-3-8b 因推理方式分属不同层级,分层基于非智能体实验。
统计精度:n = 8 次/配置、α = 0.05 时,能可靠检测≥40%效应量;优先检测不稳定性;n = 8 时不同观测比例有对应 95%置信区间;层级汇总用 n = 24 次使区间更窄;8/8 观测确定仅表明本次未检测到漂移,<5%的罕见漂移可能未被发现。
结果
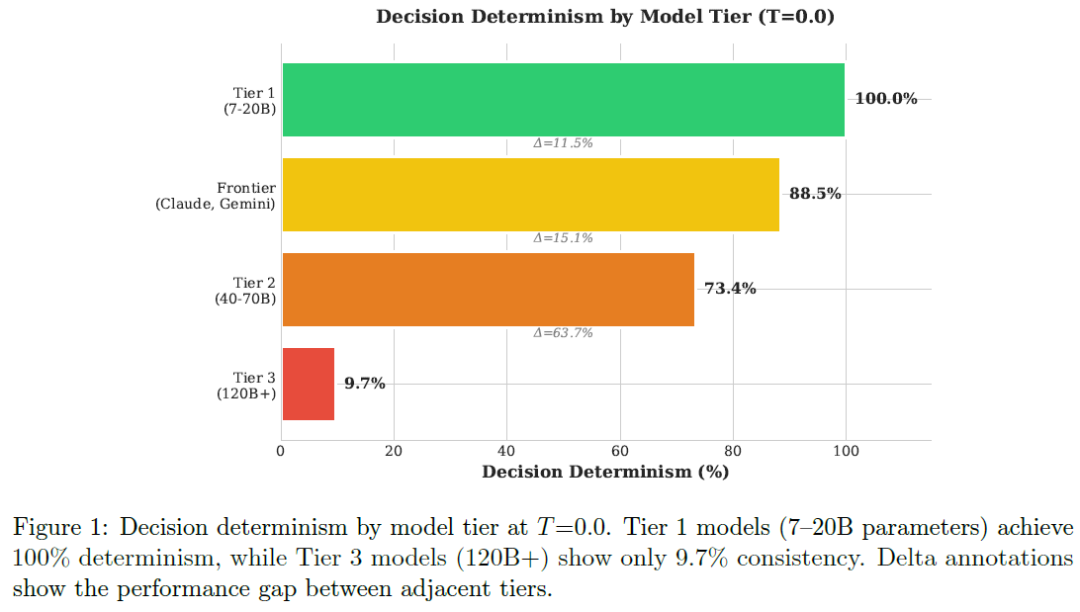
模型层级分析:表2呈现模型层级的确定性与验证缩放情况。
确定性 - 忠实度相关性:二者呈正相关(r = 0.45,p < 0.01,n = 51),或因稳定内部表征,需控制实验及混杂因素。Tier 1模型兼具高确定性与忠实度,反驳可靠性 - 能力权衡假设。
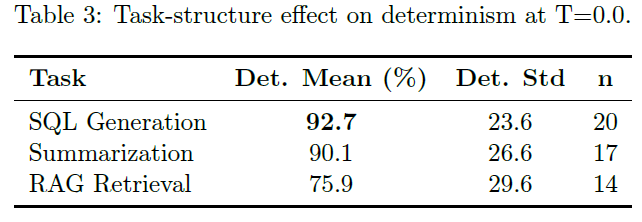
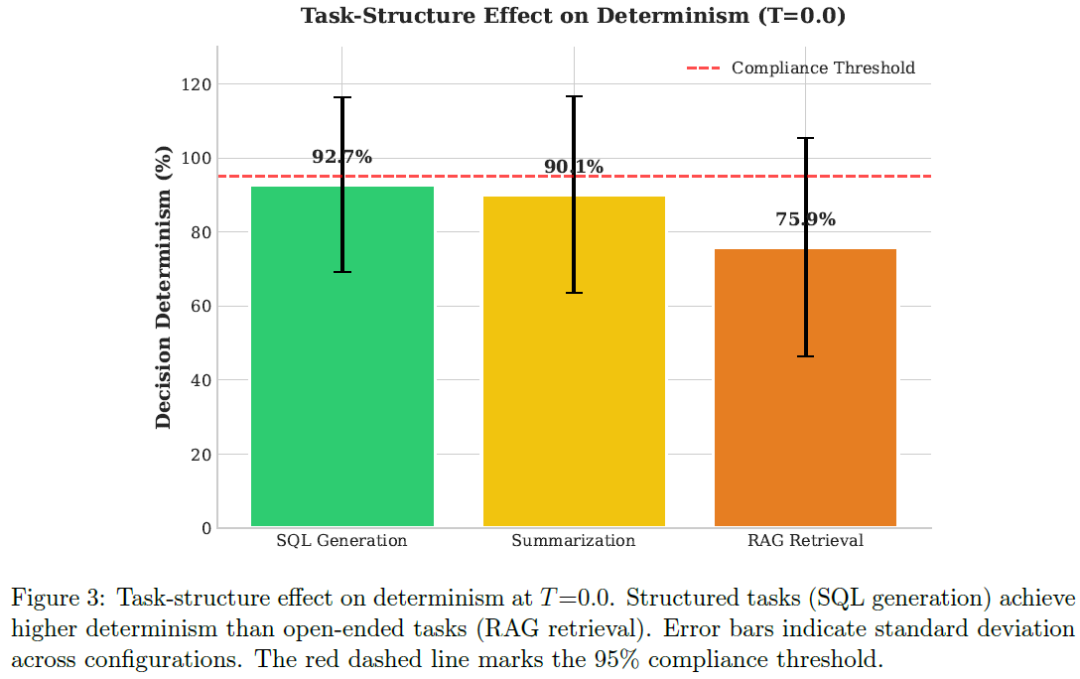
任务结构影响:结构化任务(SQL)比开放式任务(RAG)确定性高,支持架构优先推荐。
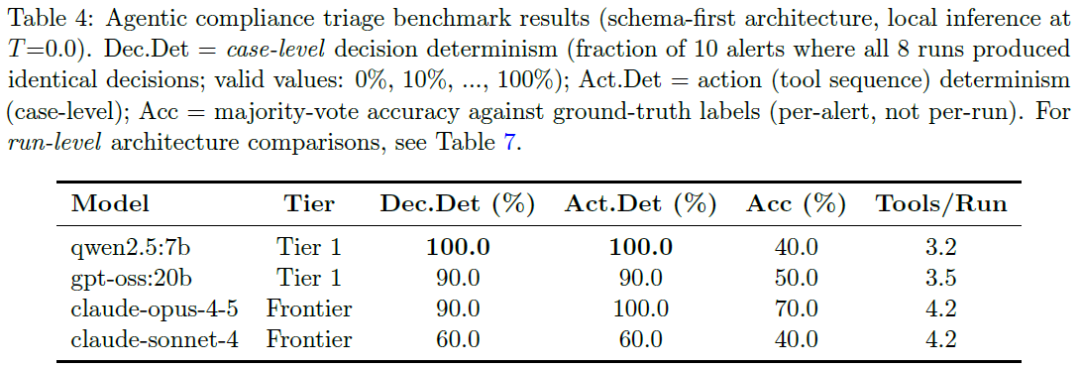
智能体基准结果:智能体工具使用增加系统方差,qwen2.5:7b智能体确定性完美,前沿模型存在确定性 - 能力权衡。
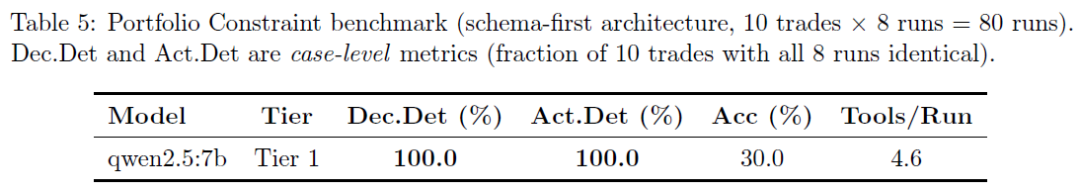
投资组合约束结果:结构化输出约束带来完美确定性,低准确率或因任务复杂,可通过微调解决。
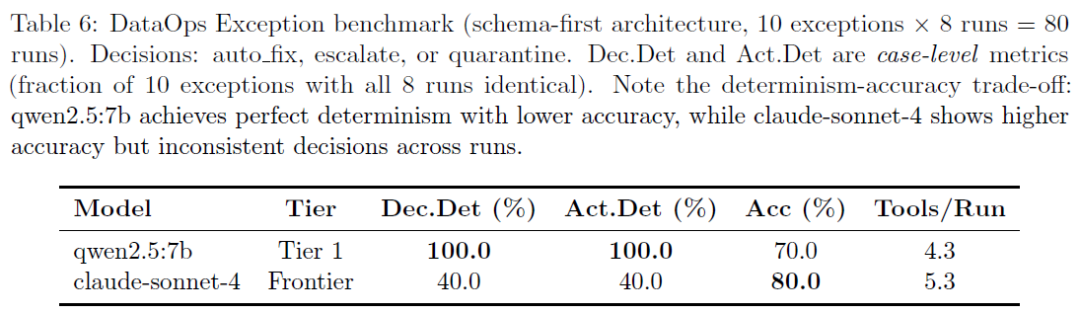
数据操作异常结果:表6展示金融管道数据质量异常处理结果。
压力测试结果:架构优先与qwen2.5:7b在各场景确定性近乎完美,claude - opus - 4 - 5在重新部署时有差异。
讨论
为什么确定性胜过准确性
提出为何接受 30 - 40%准确率以获完美可重复性的问题,指出非确定性准确率在监管环境中无法验证和审计,确定性决定了准确率提升有意义的可行区域,未达高确定性时准确率指标不可信。
针对合规关键部署提出分阶段方法:先以确定性一级模型建立可审计基线;通过特定领域微调提高准确率,保持确定性;将前沿模型用于可接受差异的人在环咨询工作流,此方法可满足监管要求并提升能力。
与行业标准的连接
框架契合金融服务行业新兴实践,该行业要求输出一致、工作流具有确定性,这是广泛应用的一大障碍,DFAH 框架通过提供评估基础设施验证部署的智能体是否实现确定性来解决此问题。
监管的角度
从审计角度,模型的可重复性和决策可再现性比最优性更重要。美国银行监管指引和巴塞尔操作风险框架强调相同输入下的一致性。在监管检查中,若系统重跑时对标记交易分类不一致,即使准确率高但确定性低的模型也会不通过。DFAH框架可满足此要求,其一级模型架构能达审计可重复性所需的确定性水平。
模型大小和确定性
7 - 20B 模型在评估中确定性最高且性能达标,与多模态新发现一致,如 Qwen2.5 - 7B 微调后在视频运动基准测试可媲美或超大型模型。这表明任务重可重复性时,小的任务优化模型有优势,但此结论限于本次合规性基准测试,机构需在自身工作负载上验证确定性。
限制
威胁模型:框架处理审计回放失败和证据编造两种失败模式,不涉及最终正确性、证据对齐外的公平性及对抗鲁棒性。
评估范围:聚焦企业金融任务的工具使用智能体,结果不具普适性,优先用开源模型但不能代表闭源模型。
统计效力:每个配置运行 8 - 24 次评估确定性,可能低估罕见漂移事件,n = 16 时能检测严重不稳定但可能遗漏细微变化。
特定领域与通用适用性:框架创新具金融针对性,方法可推广到其他监管领域,但参数含金融监管知识。
伦理考量:确定性智能体会放大证据中的偏差,高风险决策需人工监督。
未来工作
工作采用一阶度量的证据锚定启发式验证单个声明与证据匹配情况,Semantic Plane Alignment研究表明二阶度量可检测一阶方法无法发现的关系倒置。
对于因果方向重要的合规场景,用基于双向量的对齐扩展DFAH忠实度度量是有前景的方向。
除几何忠实度外,自然拓展包括金融工作流纳入文档图像和图表时的多模态智能体评估,以及特定领域微调实验以确定一级模型能否在保持确定性的同时提高任务准确性。
总结
本研究用DFAH测金融服务中工具使用型大语言模型智能体的可重复性,经74种配置评估,发现模型层级、架构选择与确定性结果间存在显著关联。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
