猛击OpenAI o1、DeepSeek-R1!刚刚,阿里Qwen3登顶全球开源模型
机器之心报道
编辑:Panda、杜伟
今天凌晨,从昨晚开始预热、备受全球 AI 圈关注的 Qwen3 系列模型终于正式亮相了!
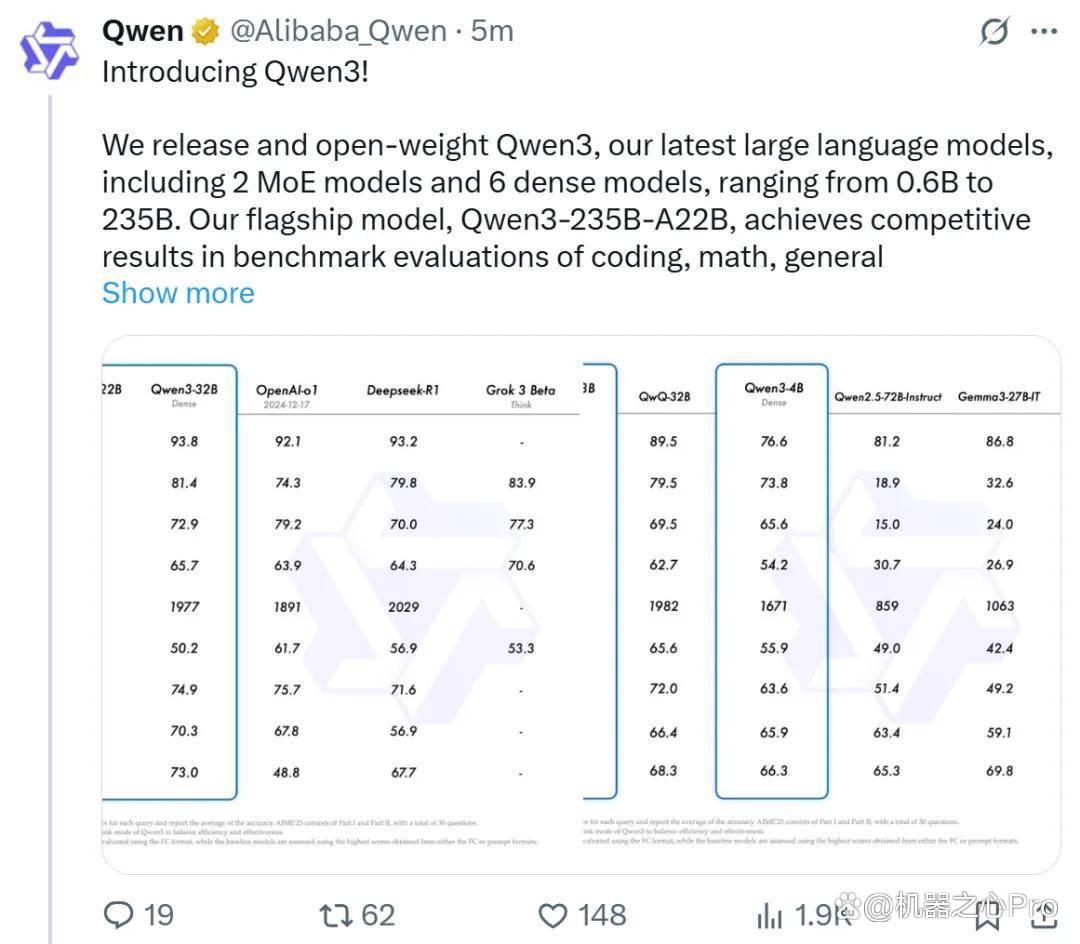
Qwen3 模型依旧采用宽松的 Apache2.0 协议开源,全球开发者、研究机构和企业均可免费在 HuggingFace、魔搭社区等平台下载模型并商用,也可以通过阿里云百炼调用 Qwen3 的 API 服务。
HuggingFace 地址:https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
Modelscope 地址:https://modelscope.cn/collections/Qwen3-9743180bdc6b48
GitHub 地址:https://github.com/QwenLM/Qwen3
博客地址:https://qwenlm.github.io/blog/qwen3/
试用地址:https://chat.qwen.ai/
具体来讲,Qwen3 系列模型包含两款 MoE 模型以及六款密集模型,其中每一款又包含更多细分版本(比如基础版和量化版):
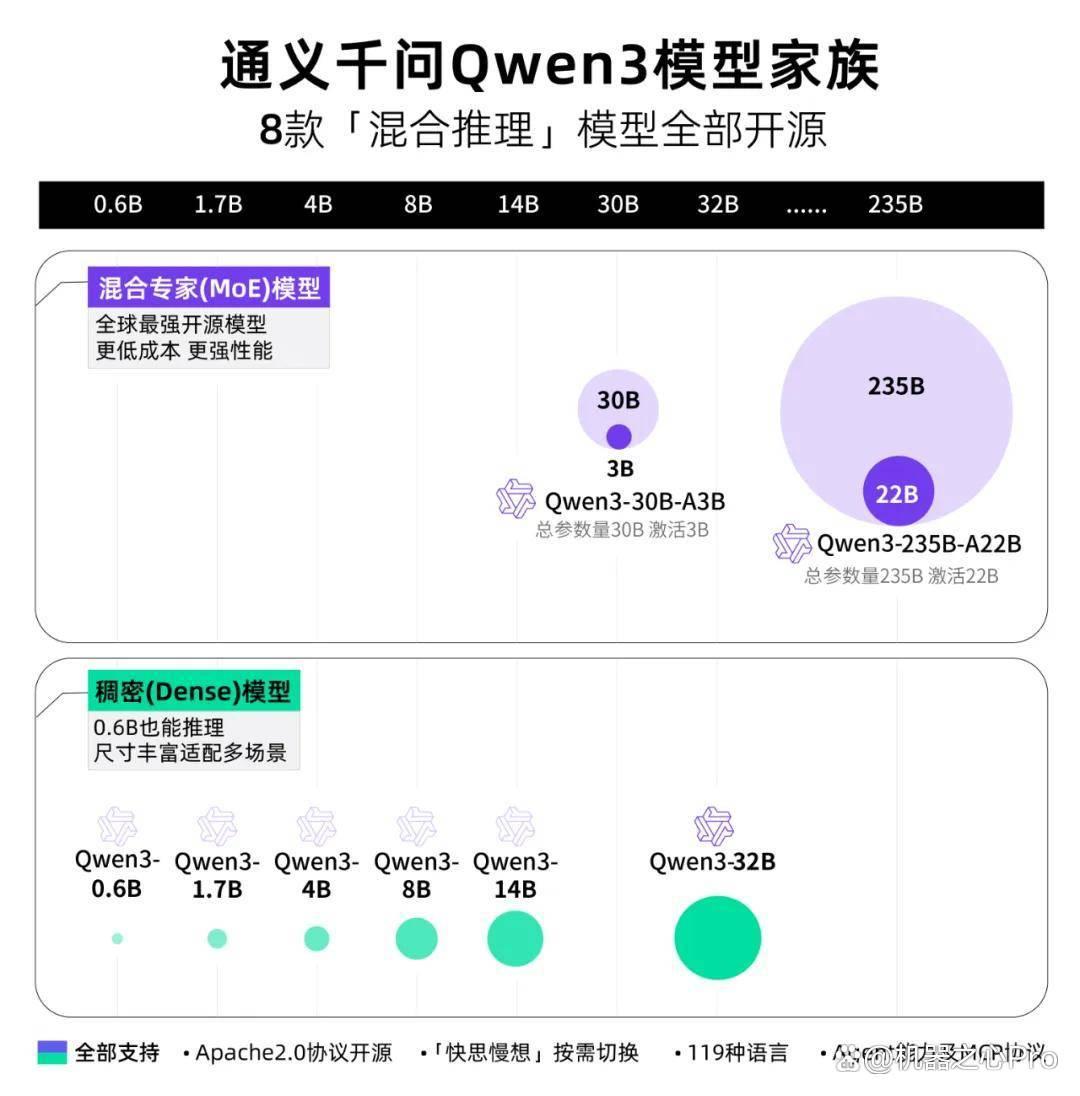
MoE 模型:Qwen3-235B-A22B 和 Qwen3-30B-A3B;其中 235B 和 30B 分别是总参数量,22B 和 3B 分别是激活参数量。
密集模型:Qwen3-32B、Qwen3-14B、Qwen3-8B、Qwen3-4B、Qwen3-1.7B 和 Qwen3-0.6B。
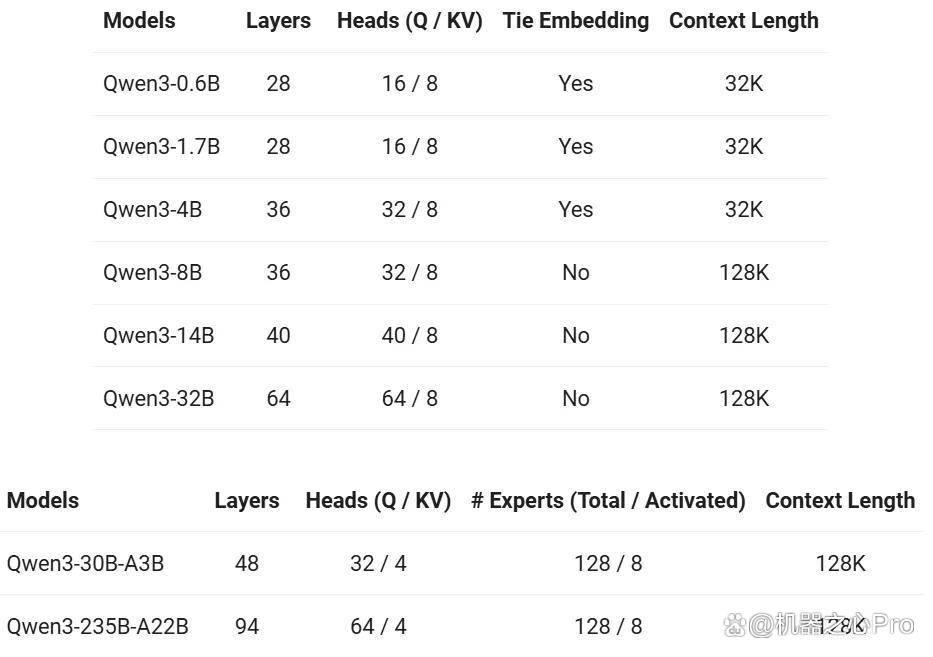
下表展示了这些模型的详细参数:
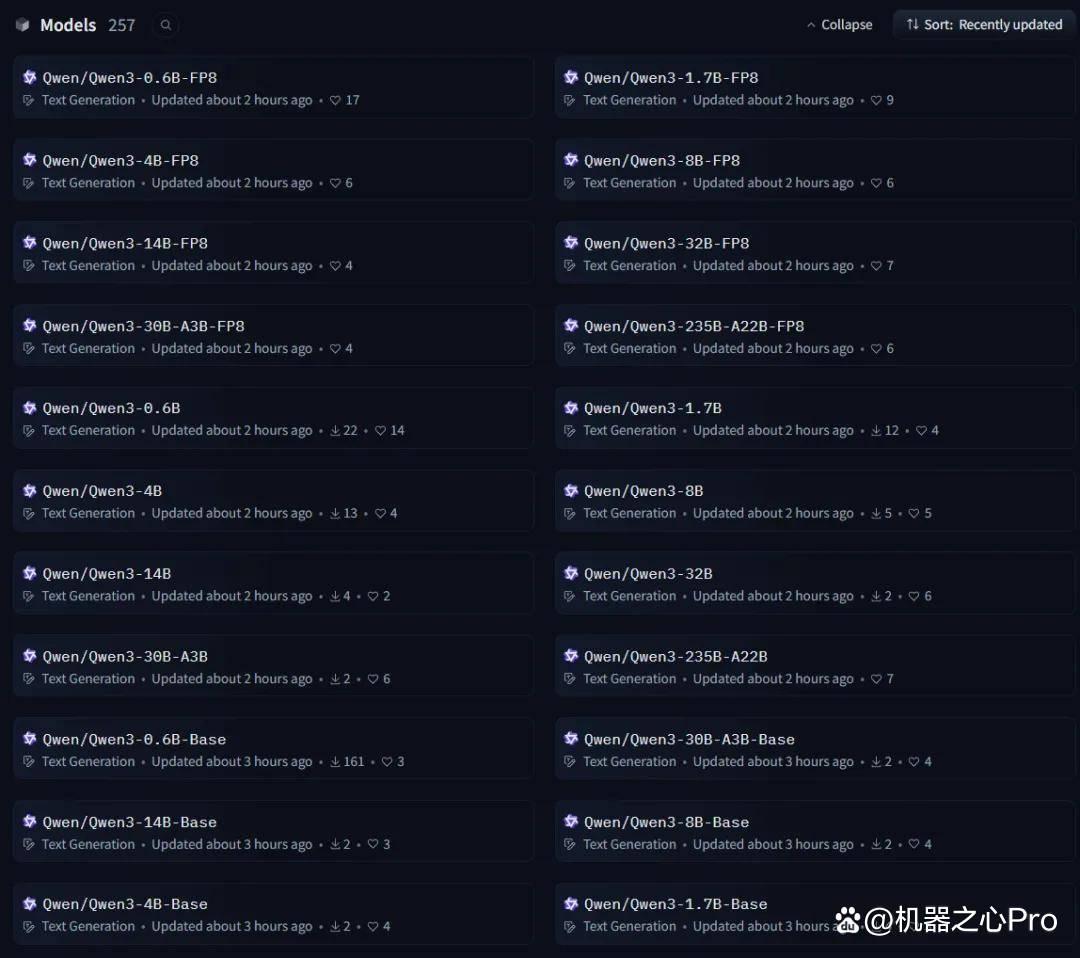
Hugging Face 已经上线了 22 个不同的 Qwen3 系列模型
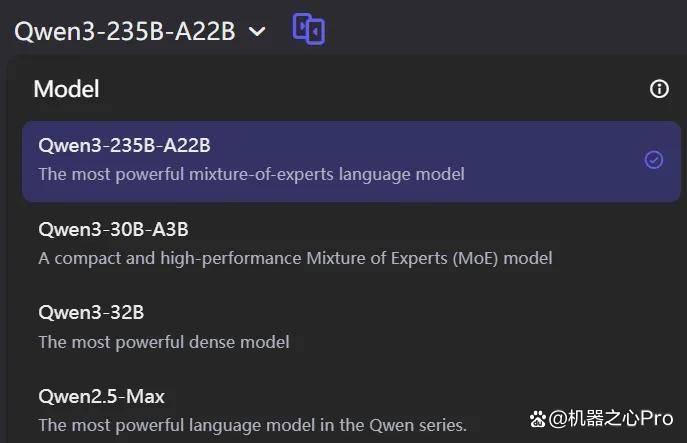
目前,Qwen3 系列中较大的三款模型也已经上线了 Qwen Chat 网页版和手机 App。
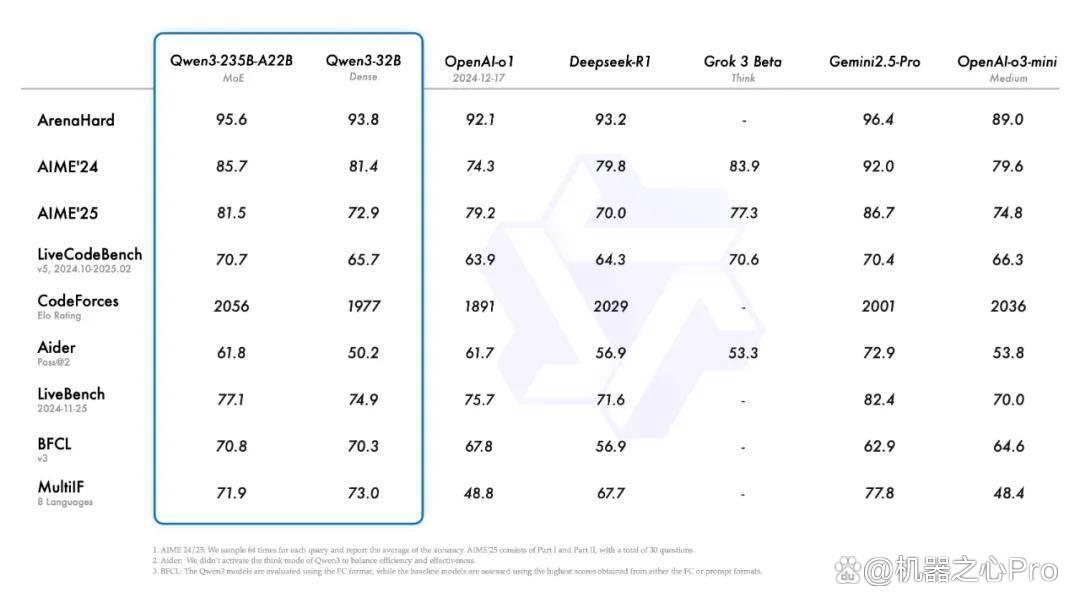
性能方面,在代码、数学、通用能力等基准测试中,旗舰模型 Qwen3-235B-A22B 与 DeepSeek-R1、o1、o3-mini、Grok-3 和 Gemini-2.5-Pro 等顶级模型表现相当。
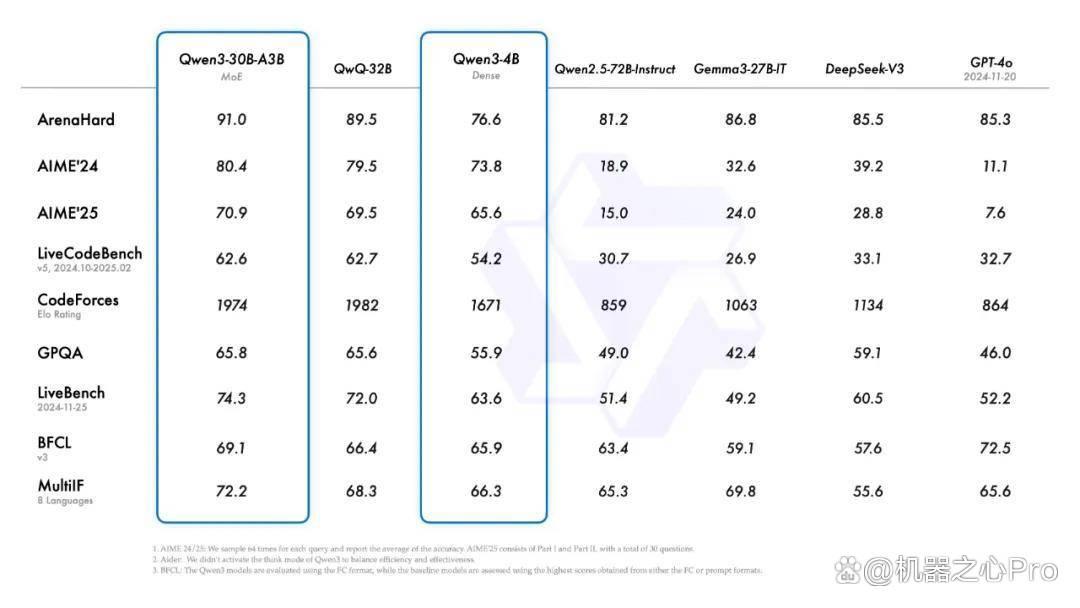
此外,小型 MoE 模型 Qwen3-30B-A3B 的激活参数数量是 QwQ-32B 的 10%,表现却更胜一筹。甚至像 Qwen3-4B 这样的小模型也能匹敌 Qwen2.5-72B-Instruct 的性能。
性能大幅提升的同时,Qwen3 的部署成本还大幅下降,仅需 4 张 H20 即可部署满血版,显存占用仅为性能相近模型的三分之一。
开发团队也在博客中给出了一些推荐设置:「对于部署,我们推荐使用 SGLang 和 vLLM 等框架;而对于本地使用,像 Ollama、LMStudio、MLX、llama.cpp 和 KTransformers 这样的工具也非常值得推荐。这些选项确保用户可以轻松将 Qwen3 集成到他们的工作流程中,无论是用于研究、开发还是生产环境。」
该团队表示:「Qwen3 的发布和开源将极大地推动大型基础模型的研究与开发。我们的目标是为全球的研究人员、开发者和组织赋能,帮助他们利用这些前沿模型构建创新解决方案。」
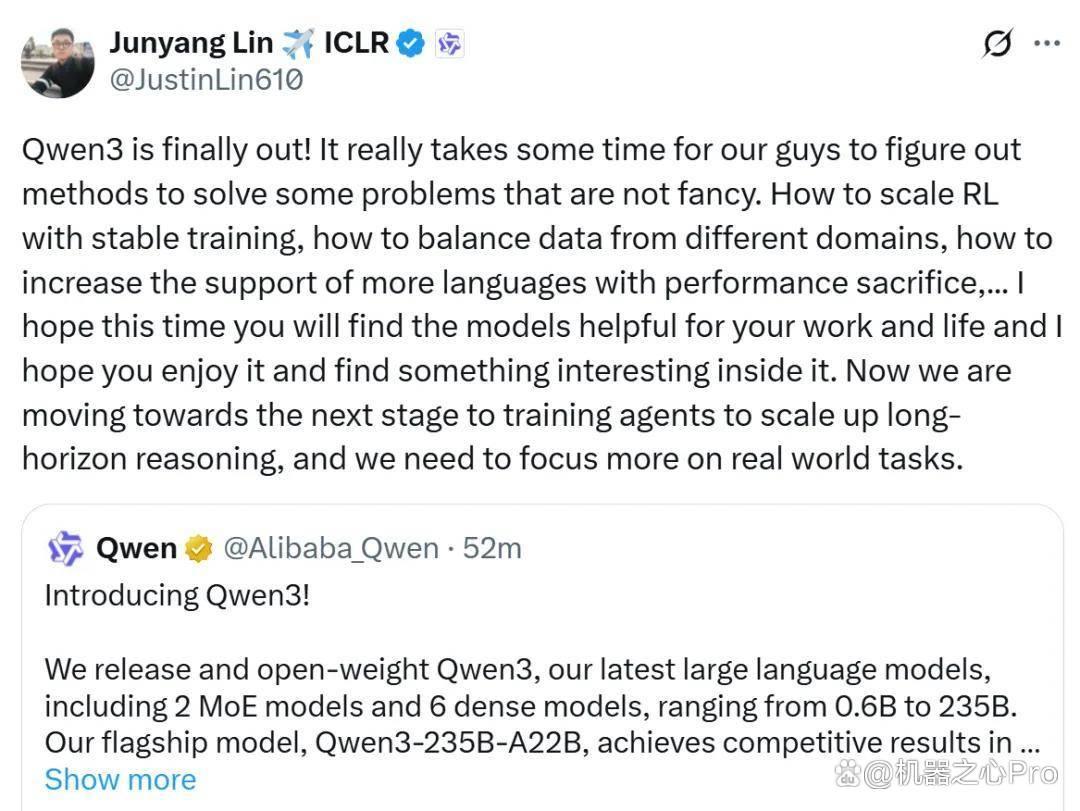
Qwen 团队技术负责人林俊旸(Junyang Lin)进一步分享了 Qwen3 模型开发的细节,他称团队成员花了一些时间来找方法解决一些并不花哨的问题,比如如何通过稳定的训练来扩展强化学习、如何平衡来自不同领域的数据、如何增强对更多语言的支持等。他希望用户能够喜欢 Qwen3 模型并从中发现一些有趣的东西。他还表示,团队正迈向下一个阶段,即训练 Agent 来扩展长程推理,同时更多地关注现实世界的任务。
当然,未来开发团队也将放出 Qwen3 模型的技术报告或训练配方。
网友反馈与上手实测
和前一代 Qwen 系列模型一样,Qwen3 的发布同样吸引了全球 AI 和开源社区的关注,我们看到的也是满屏的好评。
究竟表现如何?机器之心也做了点简单的尝试。
首先来个简单的推理测试题,Qwen3-235B-A22B 不出意料地能轻松应对。
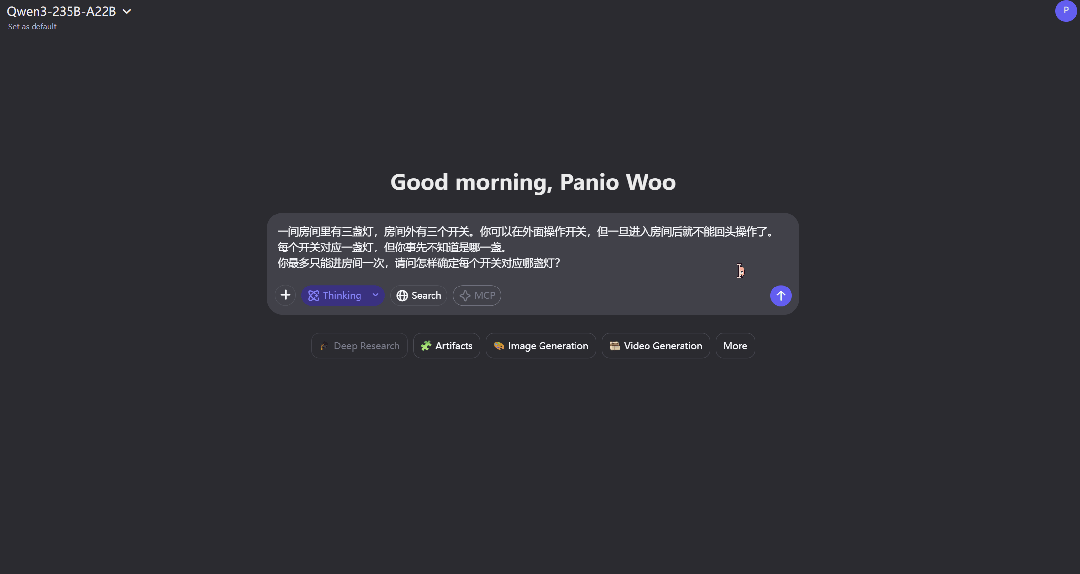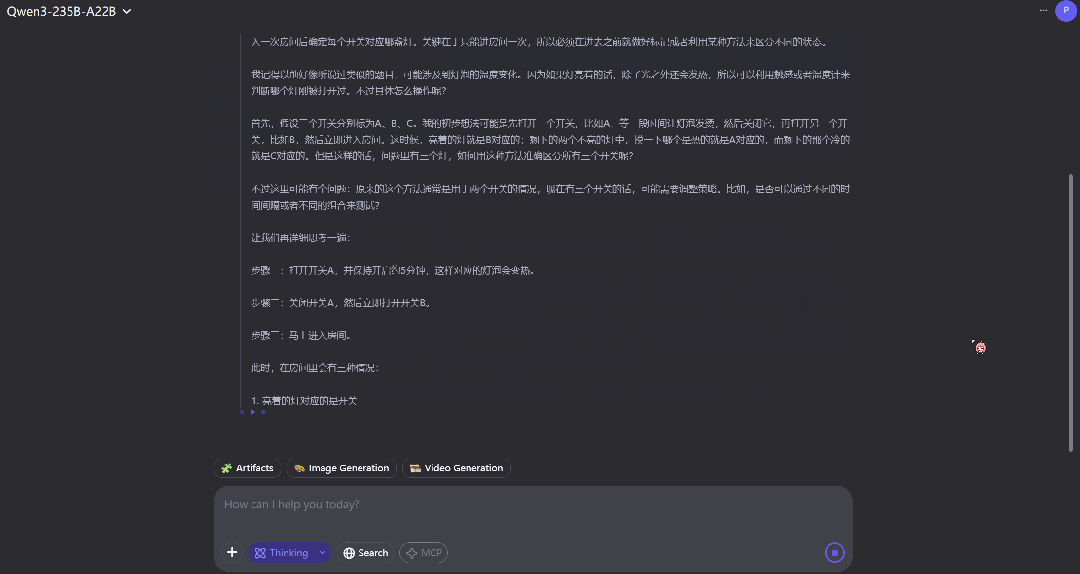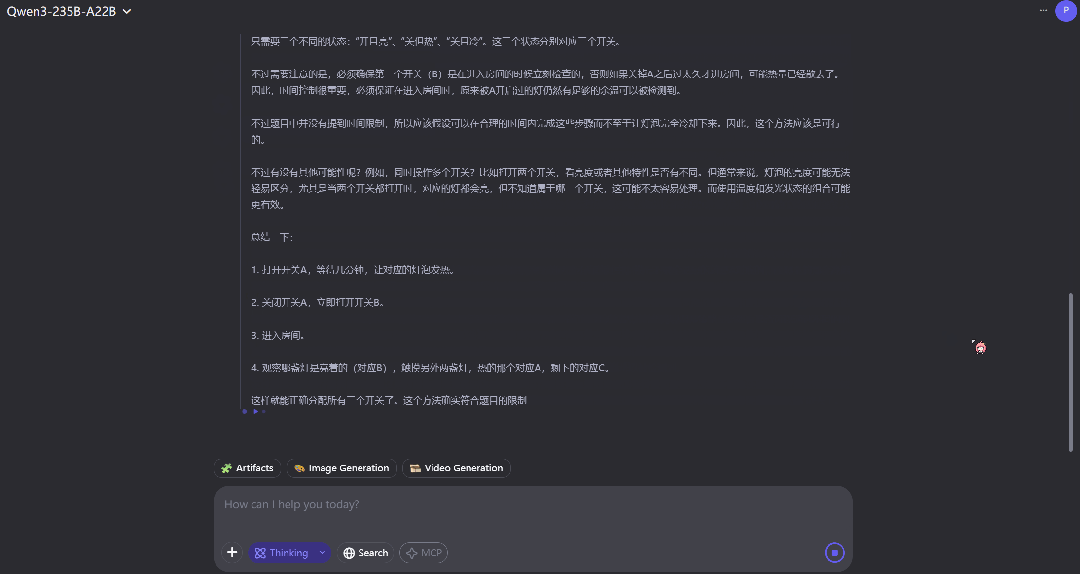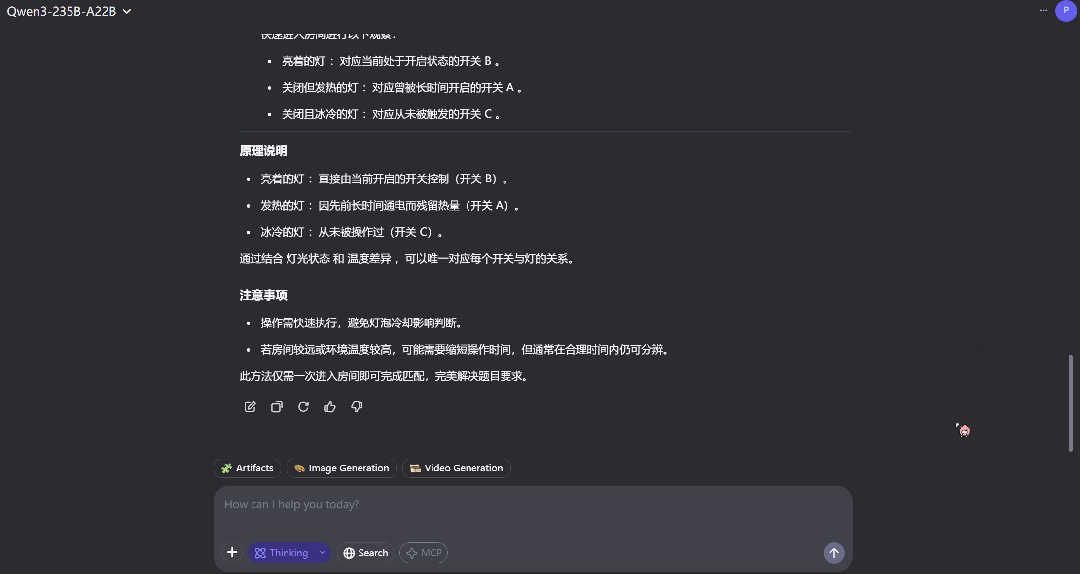
2 倍速动图
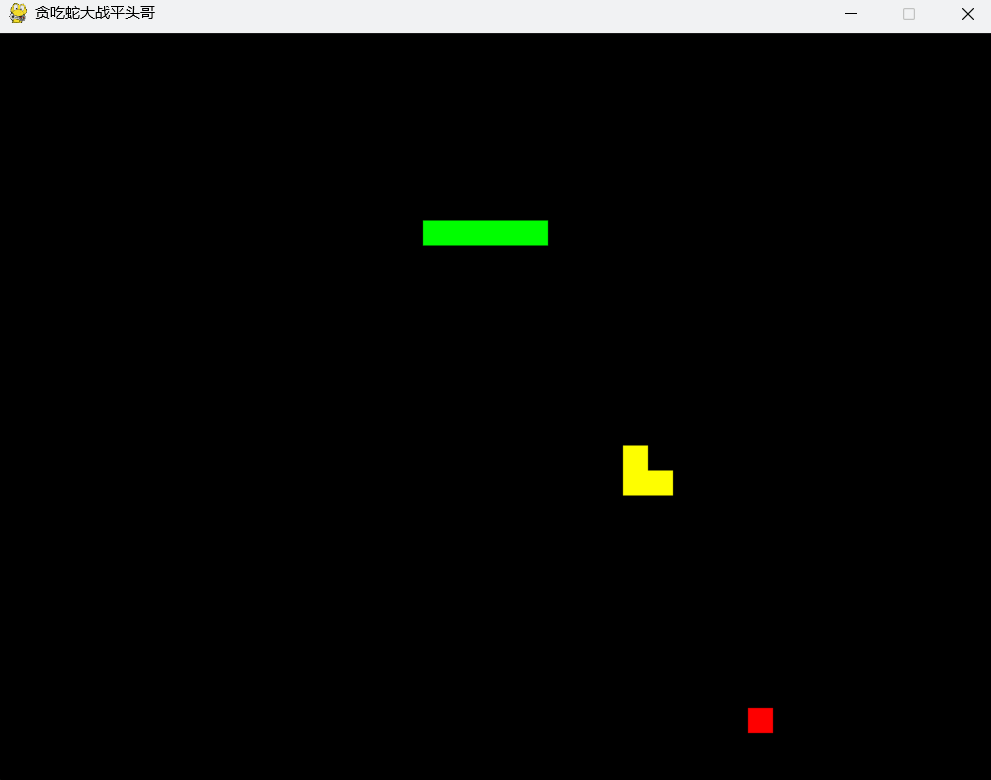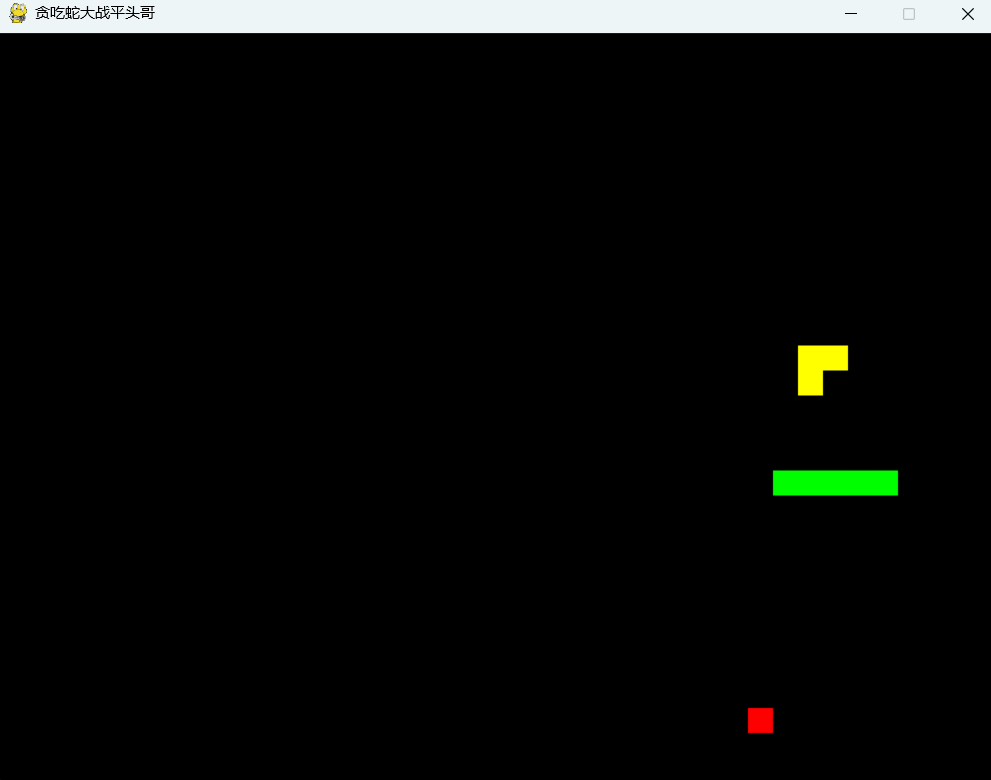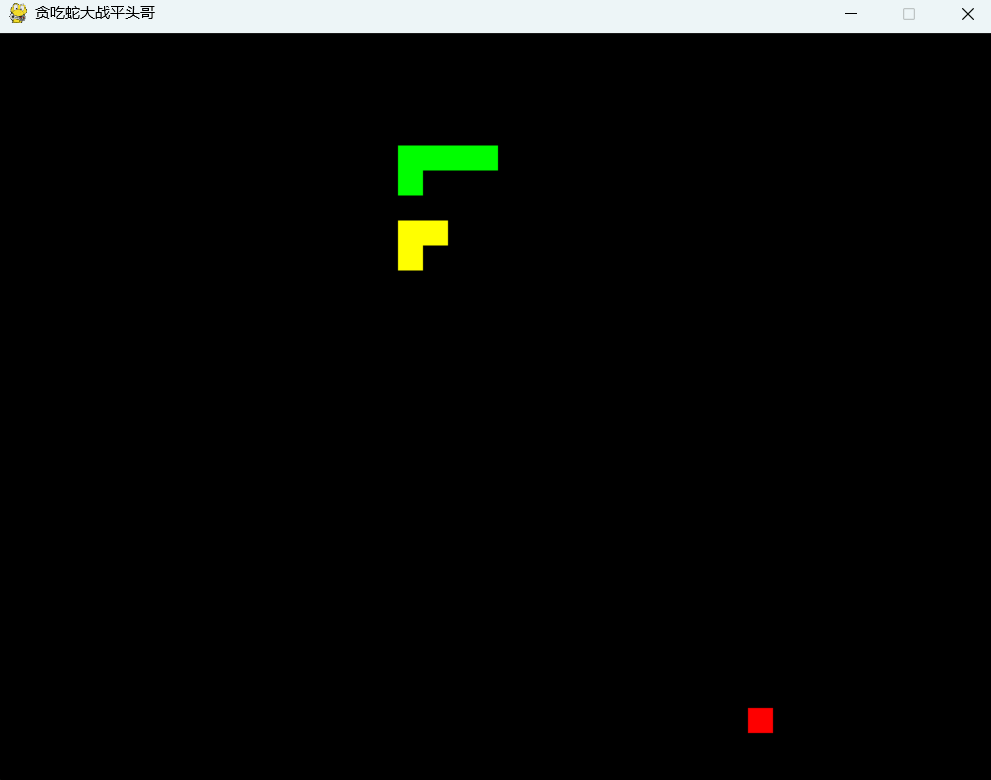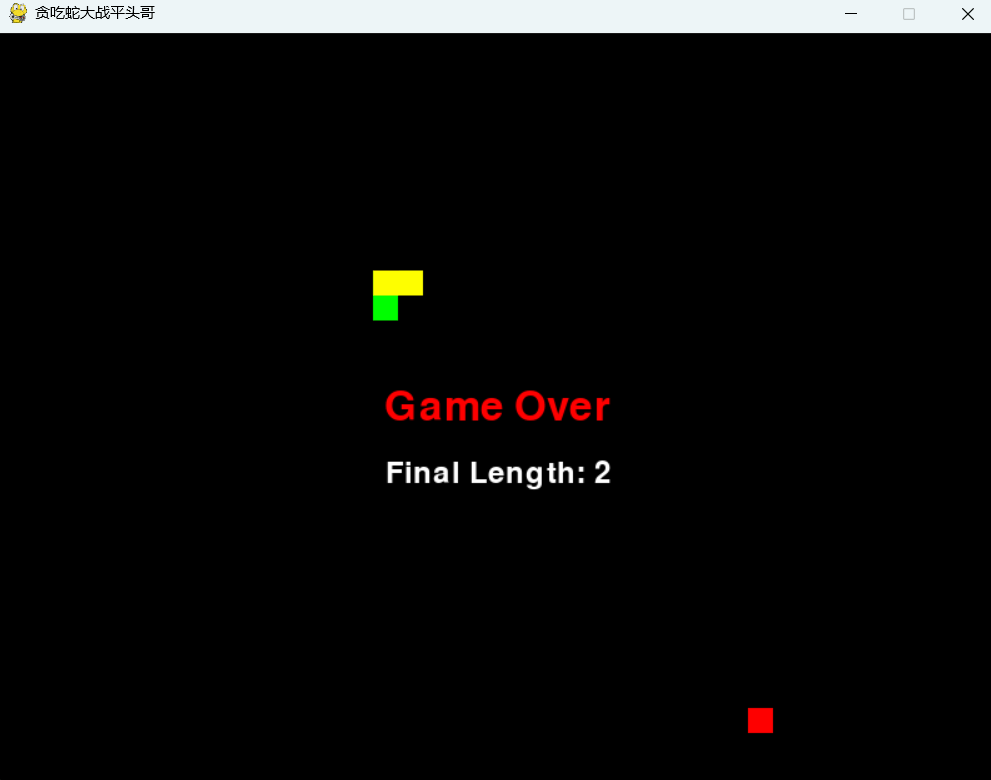
接下来,我们尝试了一个更加复杂的编程任务:编写一个贪吃蛇游戏,采用像素风格。同时有另一个需求,游戏中有一个平头哥在追赶我们控制的蛇,一旦被咬中,蛇的长度就会丢失一半。当蛇撞墙或咬到自己或长度低于 2 时,游戏结束。
视频未加速
Qwen3-235B-A22B 大概使用了 3 分钟解决这个任务。简单试玩一下,发现基本上可玩,但也有些 bug,比如平头哥的速度过快了。但考虑到这是 Qwen3-235B-A22B 在简单提示词下给出的 One-shot 结果,也就完全可以接受了。相信更精细的提示工程和迭代优化可以得到更好的结果。
我们也通过 Ollama 简单尝试了 Qwen3 系列中最小的模型 Qwen 0.6B。
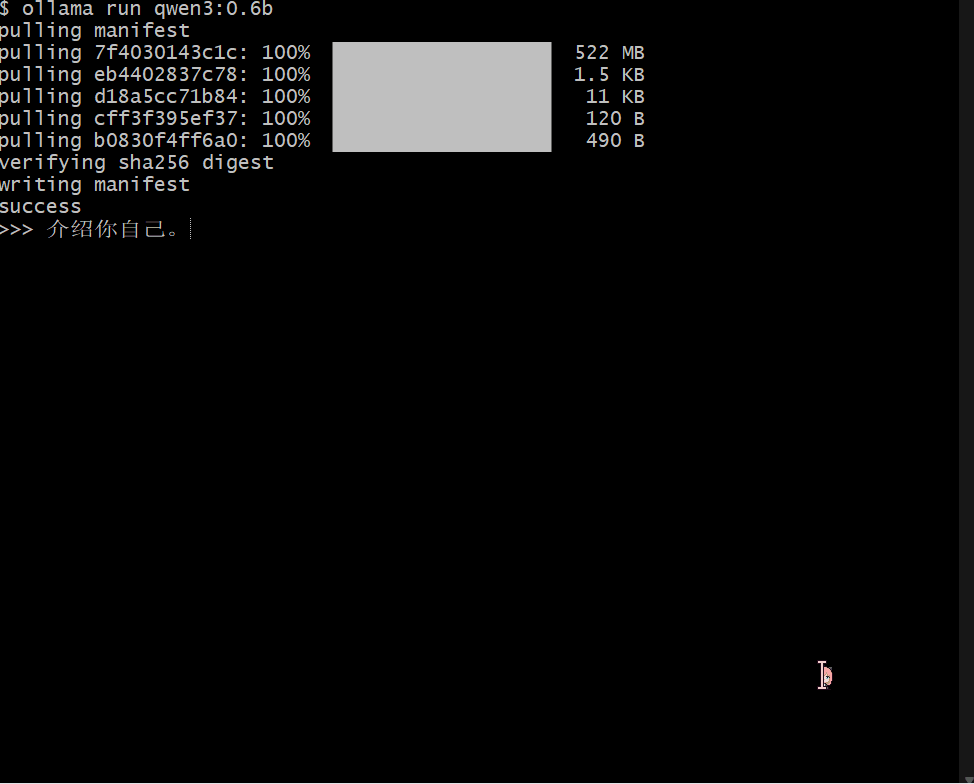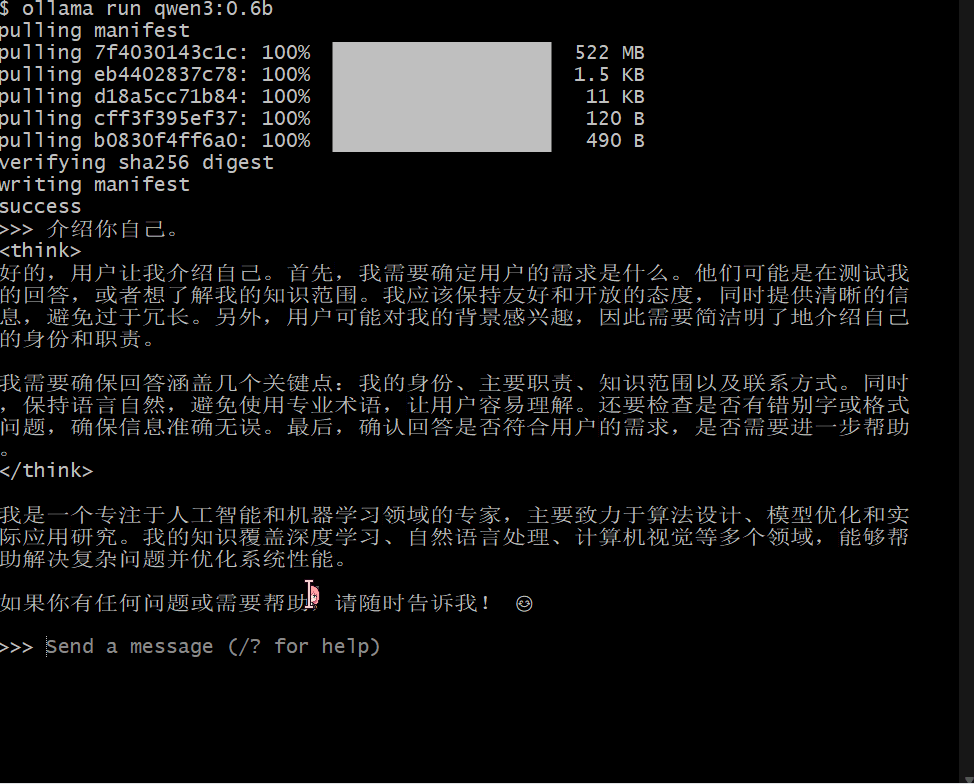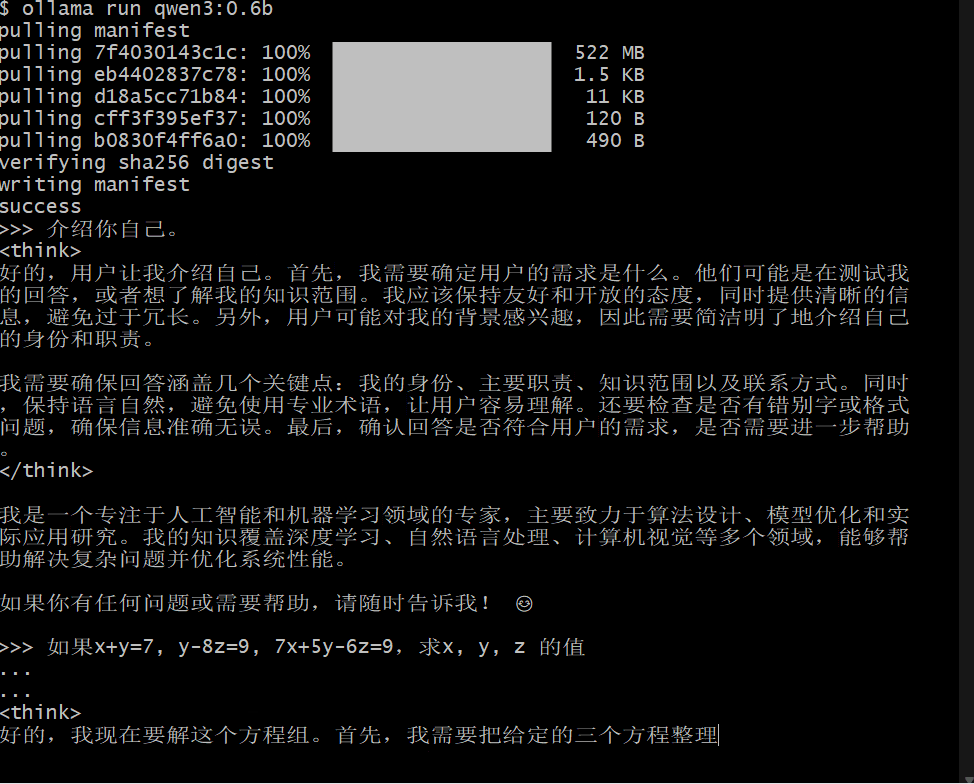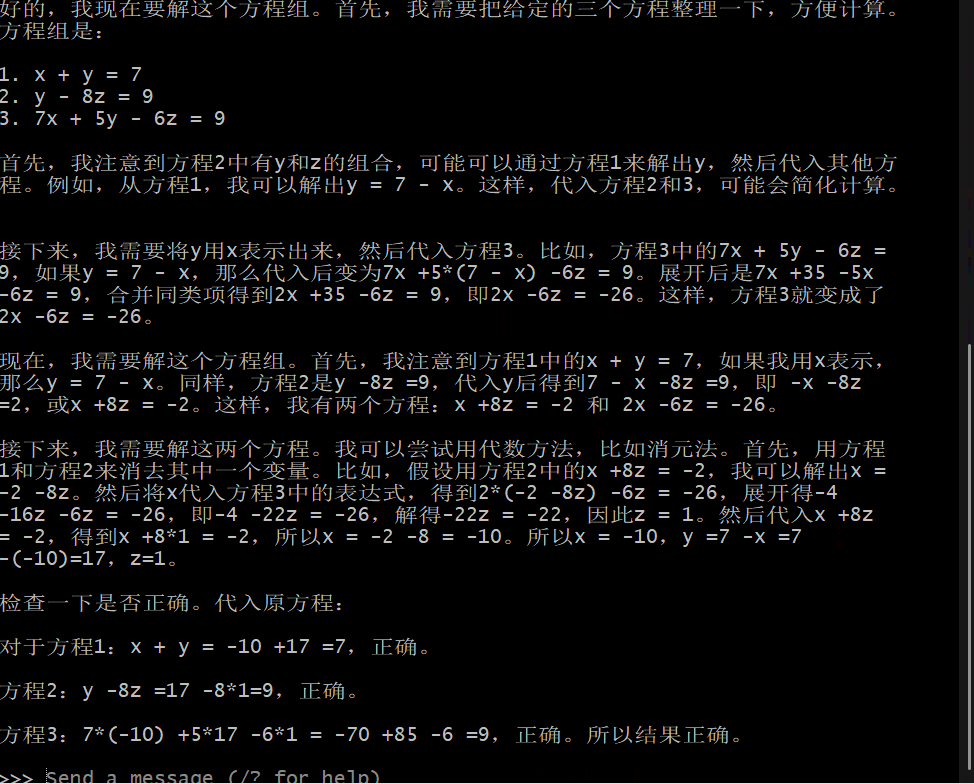
看起来,这个完全可以在一台普通手机上流畅运行的小模型不仅速度很快,也足以完成很多日常的推理任务。
经过后训练的模型,例如 Qwen3-30B-A3B,以及它们的预训练基座模型(如 Qwen3-30B-A3B-Base),现已在 Hugging Face、ModelScope 和 Kaggle 等平台上开放使用。对于部署,我们推荐使用 SGLang 和 vLLM 等框架;而对于本地使用,像 Ollama、LMStudio、MLX、llama.cpp 和 KTransformers 这样的工具也非常值得推荐。这些选项确保用户可以轻松将 Qwen3 集成到他们的工作流程中,无论是用于研究、开发还是生产环境。
三大核心亮点
此次,Qwen3 模型在多个方面实现了增强。
一是,支持两种思考模式,分别如下:
思考模式,模型逐步推理,经过深思熟虑后给出最终答案,尤其适合需要深入思考的复杂问题。
非思考模式,模型提供快速、近乎即时的响应,适用于那些对速度要求高于深度的简单问题。
这种灵活性使用户能够根据具体任务控制模型进行「思考」的程度。例如,复杂的问题可以通过扩展推理步骤来解决,而简单的问题则可以直接快速作答,无需延迟。
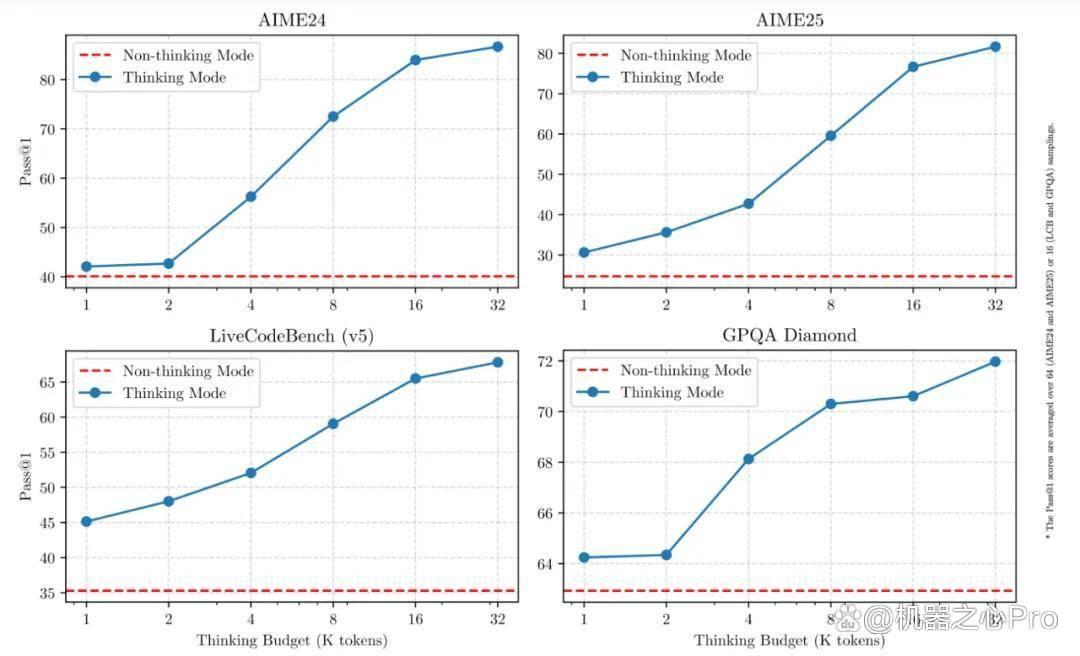
至关重要的是,这两种模式的结合大大增强了模型实现稳定且高效的「思考预算」控制能力。Qwen3 展现出的可扩展且平滑的性能提升,就与分配的计算推理预算直接相关。可以预见,这样的设计让用户能够更轻松地为不同任务配置特定的预算,在成本效益和推理质量之间实现更优的平衡。
下图为在 AIME24、AIME25、LiveCodeBech(v5)和 GPQA Diamond 等基准测试集中,非思考模式与思考模式的思考预算变化趋势。
二是,支持更多语言。
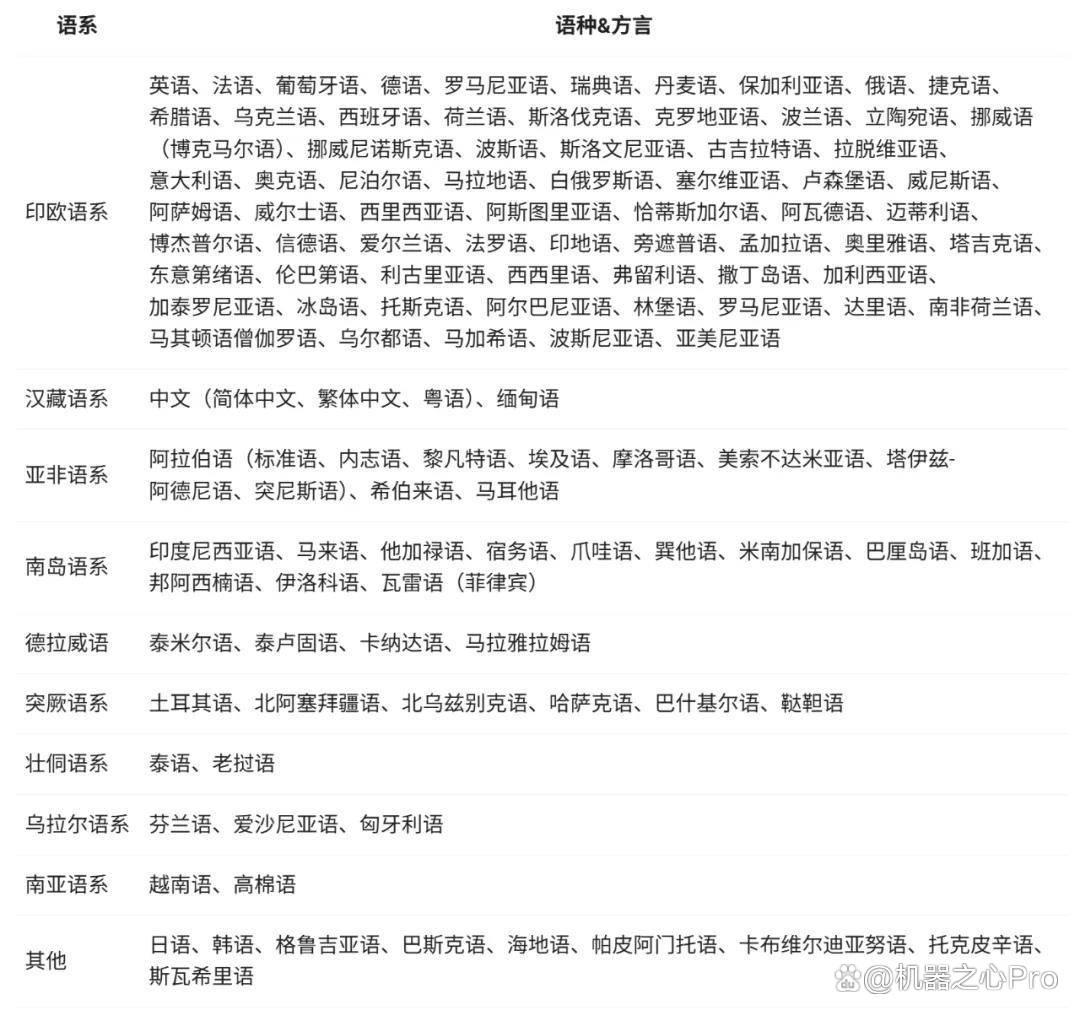
目前,Qwen3 模型支持 119 种语言和方言。增强的多语言能力为国际应用开辟了新的可能性,可以让更广泛的全球用户体验到模型的强大能力。这些语言具体包括如下:
三是,Agent 能力增强。
如今,Agent 已经是大模型领域重点关注的能力之一,尤其是最近 MCP 模型上下文协议的引入更是大大增强了 Agent 的适用性和灵活性,大大拓宽了应用场景。
此次,Qwen3 模型的 Agent 和 代码能力得到增强,包括加强了对 MCP 的支持。我们可以看下面一个示例(提取 QwenLM 库的 markdown 内容,然后绘制显示项目 stars 数量的条形图),展示了 Qwen3 如何思考并与环境进行交互
预训练数据量达 36 万亿 token
后训练实现混合推理
在预训练方面,Qwen3 的数据集相比 Qwen2.5 有了显著扩展。Qwen2.5 是在 18 万亿个 token 上进行预训练的,而 Qwen3 使用的数据量几乎是其两倍,达到了约 36 万亿个 token,涵盖了 119 种语言和方言。
为了构建庞大的数据集,开发团队不仅从网络上收集数据,还从 PDF 文档中提取信息。他们使用 Qwen2.5-VL 从这些文档中提取文本,并用 Qwen2.5 改进提取内容的质量。
另外,为了增加数学和代码数据的数量,开发团队利用 Qwen2.5-Math 和 Qwen2.5-Coder 这两个数学和代码领域的专家模型合成数据,合成了包括教科书、问答对以及代码片段等多种形式的数据。
具体而言,预训练过程分为了以下三个阶段:
在第一阶段(S1),模型在超过 30 万亿个 token 上进行了预训练,上下文长度为 4K token。这一阶段为模型提供了基本的语言技能和通用知识。
在第二阶段(S2),通过增加知识密集型数据(如 STEM、编程和推理任务)的比例来改进数据集,随后模型又在额外的 5 万亿个 token 上进行了预训练。
在最后阶段,使用高质量的长上下文数据将上下文长度扩展到 32K token,确保模型能够有效地处理更长的输入。
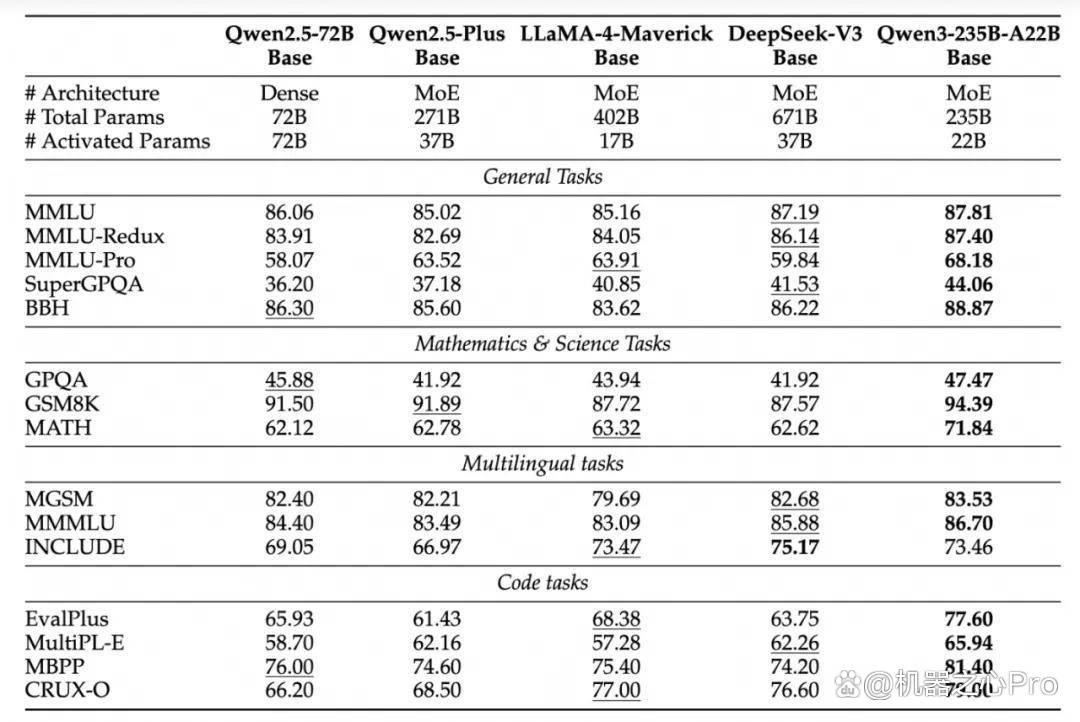
得益于模型架构的改进、训练数据的增加以及更有效的训练方法,Qwen3 Dense 基础模型的整体性能与参数更多的 Qwen2.5 基础模型相当,例如 Qwen3-1.7B/4B/8B/14B/32B-Base 分别与 Qwen2.5-3B/7B/14B/32B/72B-Base 表现相当。
特别是在 STEM、编码和推理等领域,Qwen3 Dense 基础模型的表现甚至超过了更大规模的 Qwen2.5 模型。可以看到,Qwen3 MoE 基础模型在仅使用 10% 激活参数的情况下达到了与 Qwen2.5 Dense 基础模型相似的性能,由此带来了训练和推理成本的显著节省。
与此同时,Qwen3 在后训练阶段同样进行了优化。
为了开发能够同时具备思考推理和快速响应能力的混合模型,开发团队实施了一个四阶段的训练流程,包括:(1)长思维链冷启动,(2)长思维链强化学习,(3)思维模式融合,以及(4)通用强化学习。
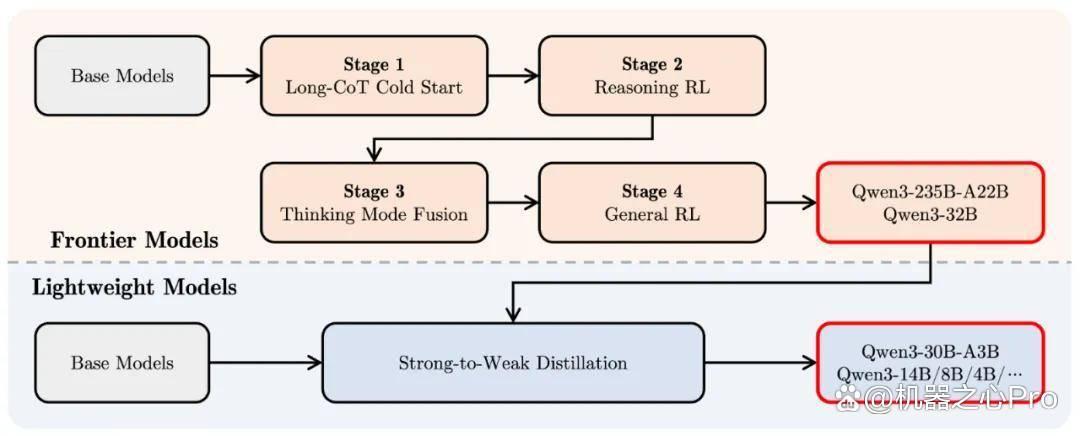
在第一阶段,使用多样的的长思维链数据对模型进行了微调,涵盖了数学、代码、逻辑推理和 STEM 问题等多种任务和领域。这一过程旨在为模型配备基本的推理能力。
第二阶段的重点是大规模强化学习,利用基于规则的奖励来增强模型的探索和钻研能力。
在第三阶段,在一份包括长思维链数据和常用的指令微调数据的组合数据上对模型进行微调,将非思考模式整合到思考模型中,确保了推理和快速响应能力的无缝结合。
在第四阶段,在包括指令遵循、格式遵循和 Agent 能力等在内的 20 多个通用领域的任务上应用了强化学习,进一步增强模型的通用能力并纠正不良行为。
Qwen 已成全球第一开源模型
Qwen3 的发布是阿里通义千问的又一里程碑,再对比一下 Llama 4 系列模型得到的社区反馈,Qwen 系列无疑已经成为全球第一的开源模型 —— 这一论断也有数据支持。据了解,阿里通义已开源了 200 余个模型,全球下载量超 3 亿次,Qwen 衍生模型数超 10 万个,已超越 Llama,成为全球最大的开源模型族群。
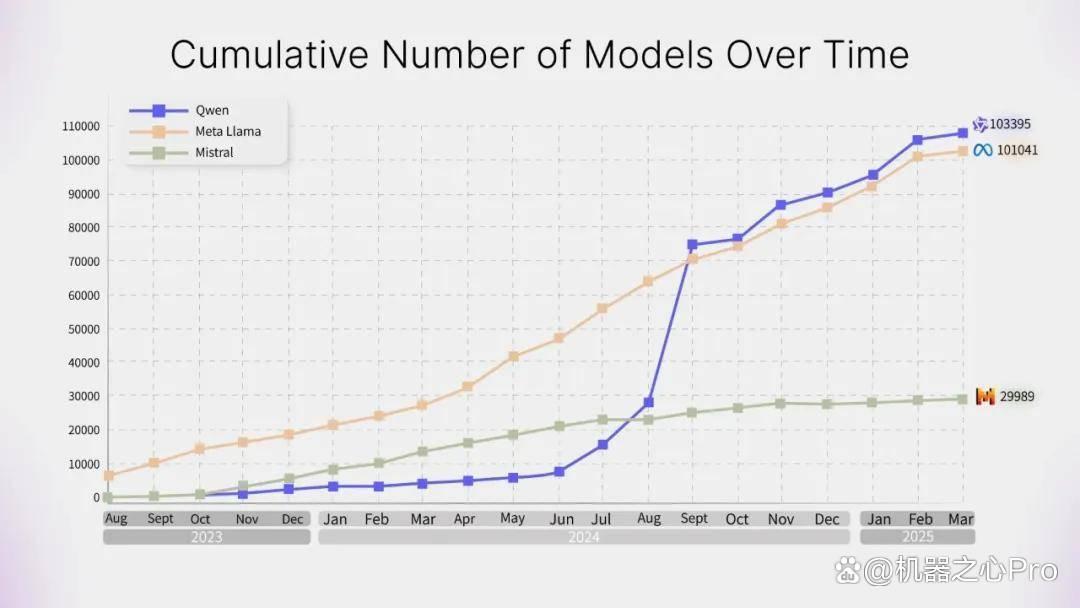
Qwen、Llama、Mistral 系列开源模型的衍生模型数量随时间的增加情况
在全球 AI 技术竞争日益激烈的背景下,阿里通义千问通过持续的技术创新和开放合作,推动了 AI 技术的普及与发展,展现了中国科技企业在全球开源 AI 生态中的强大影响力。
参考链接:https://x.com/Alibaba_Qwen/status/1916962087676612998