NRL:通过LLM实现智能聚类,资产配置新解法
一、传统策略的局限性
传统投资组合配置多为静态设定,难以适配市场动态变化。马科维茨均值-方差模型虽形式化了风险与收益的权衡关系,但对预期收益、协方差矩阵等输入参数高度敏感,实际应用中易受数据噪声与估计误差影响。为优化下行风险刻画,学界引入平均绝对偏差(MAD)、条件风险价值(CVaR)等度量方式,结合鲁棒优化应对不确定性与计算可行性问题,同时通过稀疏化、基数约束模型兼顾交易成本与组合简洁性等现实需求。
然而这类方法本质仍属静态配置,对市场周期演变的适应能力有限。实践中,基金经理为控制交易成本、平滑投资者情绪波动,常降低再平衡频率,导致组合偏离最优状态——低频再平衡虽缓解短期扰动,却丧失了对市场趋势的及时响应。
项目代码:https://anonymous.4open.science/r/no-regret-paper-62CA
二、No-Regret投资组合配置框架的设计理念
2.1 核心思想:无悔学习与动态响应
将资产配置建模为序列决策问题,最小化相对于历史最优静态组合的“后悔值”,是本框架设计的核心理念。该方法基于遗憾引导学习(Regret-Guided Learning)范式,算法应尽量减少因未从一开始就选择单一最优配置而产生的“遗憾”。这一机制使得智能体的总体绩效能够逼近最优固定投资组合的绩效水平,即使在环境动态变化或存在对抗性扰动的情况下,也能保持稳健的性能表现。
在数学形式上,设 表示所有合法投资组合(即资产权重向量)的集合,满足以下约束条件:
- • 每个资产的权重 ;
- • 权重之和为 1,即 。
令 表示在事后回顾中表现最优的固定投资组合。定义一个性能度量函数 ,用于评估在时间 时投资组合 的表现,其指标可包括收益率、夏普比率(Sharpe Ratio)等。
在时间跨度 上,遗憾(Regret)定义为:
其中 为智能体在时间 所选择的投资组合。
若存在一种策略,使得当时间 时,平均遗憾趋于零,则称该策略为无遗憾(No-Regret)策略:
此外,本框架采用“跟随领导者”(Follow-the-Leader, FTL)策略作为核心决策机制,即在每一周期内贪婪地选择在历史回溯中表现最优的资产配置方案。这一机制可视为FTL策略的一种变体,强调对历史绩效的直接响应,而非基于概率分布的演化。
2.2 关键环节
框架的关键步骤:
- • 情绪信号采集:从社交媒体、新闻平台和金融数据终端提取高频情绪指标;
- • LLM风险评估:使用预训练语言模型对文本内容进行语义解析与风险评分;
- • 动态权重调整:根据情绪与LLM评分联合输出,对投资组合进行实时微调;
- • 过滤机制联动:在情绪极端时自动启用保护性策略,防止追高杀跌。
为确保框架在真实投资环境中的可执行性与稳定性,设计中引入了多项关键约束与机制,以平衡性能、成本与风险。
首先,限制搜索空间,仅允许在基准组合基础上微调权重。这一设计避免了因过度优化导致的组合极端化与过拟合问题。所有调整均在预设的权重扰动范围内进行,例如允许单个资产权重在基准值上下浮动 ±10%,从而在保持多元化的同时实现动态响应。
其次,采用季度再平衡频率,与主流指数基金一致,兼顾成本效益与响应性。频繁调整会带来高额交易成本与税收负担,而季度频率在控制成本的同时,仍能有效捕捉中期趋势变化。此外,该频率与财务报告周期同步,便于结合基本面信息进行决策优化。
为应对资产上市时间非均匀性问题,框架引入了前向填充与退市黑名单机制:
- • 前向填充:对于新上市资产,在其历史数据不足的初期阶段,采用前序相似资产的均值权重进行初始化,避免因数据缺失导致配置偏差;
- • 退市黑名单:一旦某资产被标记为退市或流动性严重不足,立即从可选池中移除,并禁止未来再纳入配置,防止“僵尸资产”拖累整体表现。
三、核心模块
3.1 数据预处理模块
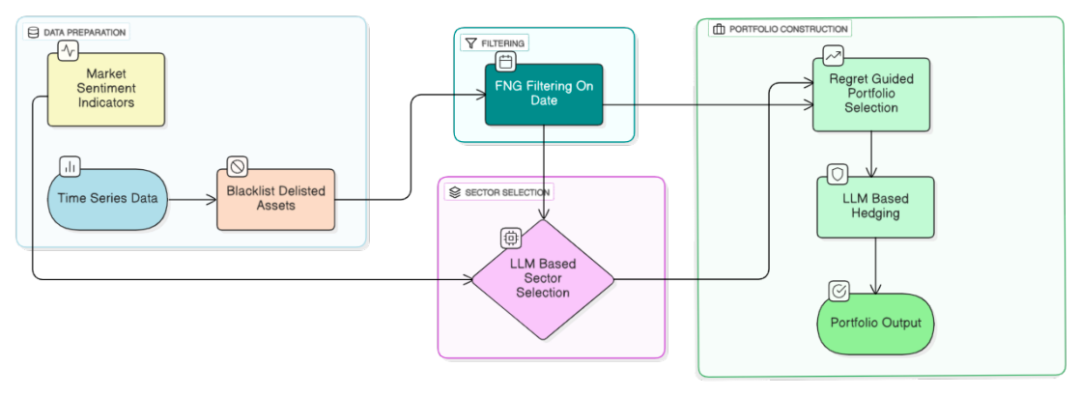
为确保后续模块输入数据的一致性与可靠性,数据预处理模块承担了关键的清洗与对齐任务。该模块首先剔除所有已退市的证券代码,防止无效资产干扰模型训练与决策过程。同时,针对不同资产上市时间非均匀性的问题,系统构建了完整的周期性处理流程:移除通用非交易日(如周末及法定节假日),并精确标记每种资产的进入与退出日期,从而建立统一的时间轴基准。
对于资产在上市前或退市后的交易日,采用-1占位符进行填充,以保留原始时间序列结构的同时明确标识出无效时间段。在此基础上,通过前向填充处理因间歇性非交易日导致的缺失数据,有效维持了价格序列的连续性。特别地,在再平衡阶段,若某资产在某日的价格为 ,则该资产将被自动排除在优化模型之外;若资产在持仓期间发生退市,系统将触发平仓操作,将其转换为现金,并将其加入黑名单,禁止未来再次纳入配置。
3.2 情绪过滤模块
情绪过滤模块作为风险控制的第一道防线,基于CNN“恐惧与贪婪指数”(Fear and Greed Index, F&G Index) 构建了二元决策机制,旨在在极端市场情绪下主动干预投资组合行为,降低尾部风险暴露。
该模块通过实时监测F&G指数的数值变化,判断当前市场是否处于极端状态。当指数突破预设的上界或下界限制,或在特定时间窗口内发生剧烈波动(即满足变动范围约束),系统将自动触发再平衡或全部清仓操作。具体而言,变动范围约束接受参数 ,用于定义在 天前与当前再平衡日之间情绪变化的允许范围。若任一过滤条件未被满足,则系统可选择性地将整个投资组合转换为现金,实现风险敞口的主动控制。
3.3 大语言模型(LLM)模块
大语言模型(LLM)模块负责解析市场情绪趋势,并生成行业级对冲建议,作为非主配置的上游过滤器,其核心目标是提升投资组合的分散化程度与长期稳定性。
该模块采用动态聚类策略,将过去12个月的F&G时间序列输入LLM,请求其推荐最具潜力的三个行业。为降低LLM输出的波动性与偶然性,系统执行重复提示五次,并取出现频率最高的三个行业作为最终推荐结果。这一机制有效抑制了语言模型因语义歧义或上下文偏差导致的不一致性,提升了推荐结果的稳健性。
在完成动态聚类后,系统引入“伪对冲机制”:即不提供具体时间戳或个股信息,仅向LLM发出指令,要求其为每个选定聚类推荐一个互补性行业板块。该机制聚焦于行业层面,避免了LLM对高频提及个股(如AAPL)的偏好倾向,从而规避了过度集中风险。通过引入低相关性的行业,该策略显著降低整体波动率,并提升夏普比率(Sharpe Ratio)。
3.4 后悔驱动的资产配置模块
后悔驱动的资产配置模块是本框架的核心决策引擎,采用“跟随领导者”策略,通过最小化累积后悔值来实现长期绩效优化。
该模块将投资组合优化建模为一个单智能体与动态金融环境交互的博弈过程。在每个时间步 ,智能体选择一组资产权重 ,满足以下约束条件:
目标是依据选定的绩效指标(如年化收益率、夏普比率、卡玛比率等)优化投资组合。算法遵循在线学习范式,仅使用截至当前时刻的历史信息,不访问未来数据,严格避免数据泄露。
为探索动作空间,系统采用结构化扰动方式:在每个再平衡时点,仅对单一资产的权重进行微调,其余权重按比例调整以维持归一化。初始基准配置设为全现金组合,后续则以当前持仓作为基准。
在完成候选配置生成后,系统执行模拟清算过程,假设当前组合被平仓并重新配置至最优方案,随后每日跟踪净值变化直至下一次再平衡。为增强现实性,系统引入灵活的交易成本模型,支持按份额或按比例计费,并在每次再平衡日从净值中扣除。
四、实证结果与性能表现分析
4.1 实证表现
在由现金、黄金、债券与股票构成的简化“COCKROACH”资产池中,该策略展现出稳健且优越的综合表现。累计收益率略高于SPY与黄金,增长轨迹更平稳,体现了其在低维度资产配置下仍能维持持续增长的能力。这一结果表明,即便在仅包含四个非相关性资产的极小规模组合中,模型依然具备强大的信息提取能力,能够有效捕捉市场核心趋势并规避剧烈波动。
此外,该策略成功复现SPY的分散化优势,同时显著降低波动性。尽管SPY本身作为被动指数基金,其收益来源于成分股的动态管理机制,但模型通过智能权重分配,实现了接近股票市场整体回报水平的同时,大幅削减了组合波动。这说明模型不仅理解了指数基金的底层逻辑,还能在更小的资产池中实现类似的风险分散效果。
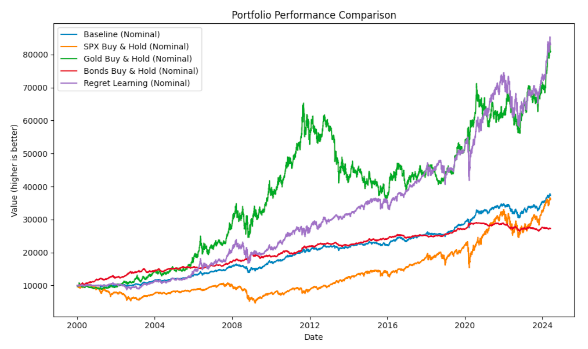
更重要的是,这一表现验证了模型在小规模资产池中仍具备信息提取与风险控制能力。在COCKROACH组合中,模型通过动态调整权重,实现了对市场状态的自适应响应:在上涨阶段增配高潜力资产,在下行阶段及时降低风险敞口。这种“低波动、高收益”的平衡能力,凸显其对市场动态的深刻建模能力,为小规模组合管理提供了可行路径。
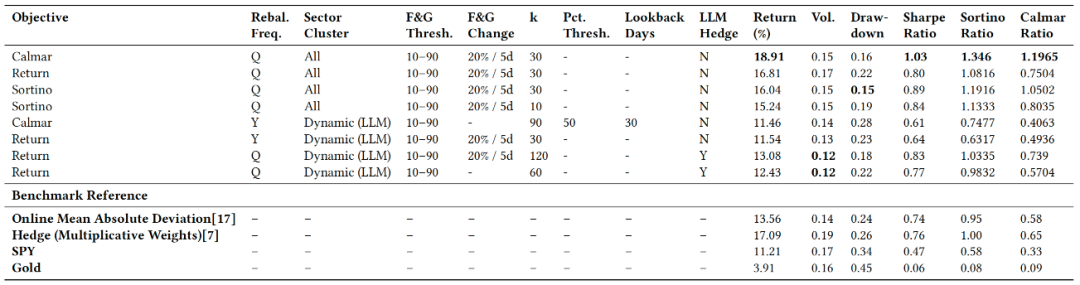
当策略扩展至包含51个行业ETF的复杂多元化组合时,其性能优势进一步放大。在2011年至2024年的25年回测期内,NRL驱动的投资组合累计收益率较SPY高出68.6%,并展现出显著优于基准的长期增长潜力。这一结果在图5中得到直观呈现,充分验证了策略在广泛资产池中的可扩展性与持续超额收益能力。
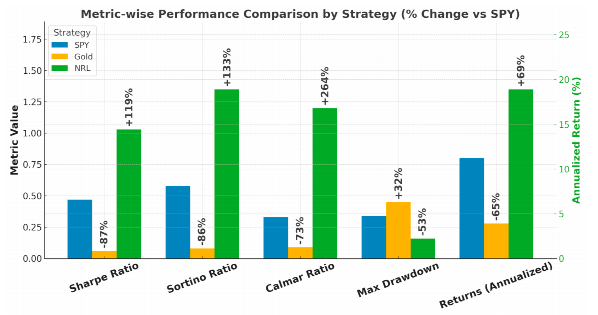
在风险调整后收益方面,该策略表现尤为突出:
- • 夏普比率提升119%,表明单位风险下创造了更高的超额回报;
- • 卡玛比率提升262%,反映出其在控制最大回撤方面具有卓越能力;
- • 最大回撤仅为16%,远低于SPY的34%,说明策略在市场剧烈下行期间具备强大的风险防御机制。
4.2 关键参数对性能的影响
再平衡频率
再平衡频率是影响策略表现的核心参数之一。在所有优于SPY基准的参数配置中,71%的优胜配置采用季度再平衡(即每三个月一次),表明该频率在响应市场变化与控制交易成本之间取得了最佳平衡。
- • 季度再平衡能够有效捕捉中短期市场趋势,避免因持仓偏离而错失机会;
- • 年度或半年度再平衡可能导致组合滞后于市场结构变化,难以及时调整;
- • 每周或每日再平衡则易引入交易噪声,增加成本并削弱策略稳定性。
因此,季度再平衡在效率与响应性之间取得了良好平衡,成为最优实践中的主流选择,也与主流指数基金的调仓周期一致,具备高度的实际可行性与成本效益。
回溯窗口长度
回溯窗口长度对信号生成与权重计算具有关键影响。在启用动态聚类的前提下,120天窗口优于10天窗口,夏普比率提升17%。这一结果表明,较长的回溯周期有助于平滑短期噪声,捕捉更稳定的趋势特征。
- • 在未启用聚类的情况下,索提诺比率(Sortino Ratio)在超过60天后呈近似线性上升趋势;
- • 而10天等短窗口则表现出不稳定的性能特征,波动较大,易受短期异常值干扰。
F&G情绪过滤
F&G情绪过滤机制通过引入市场情绪信号,显著增强了策略的风险控制能力。该机制包含两个关键子策略:
- • 绝对水平约束:当F&G情绪指数低于10或高于90时,禁止交易。该设定在市场极端情绪周期中有效抑制过度交易,避免追高杀跌。研究发现,若将交易范围进一步收紧至30–70区间,虽可降低回撤,但导致累计收益率与夏普比率显著下降,说明适度参与极端情绪周期可为策略带来额外收益优势。
- • 波动率过滤:设定5日内F&G指数变动≤20点为再平衡触发条件。该机制有效抑制情绪噪声,防止因短期情绪波动引发不必要的调仓。实验表明,该过滤显著提升了策略表现,在保持战术灵活性的同时增强稳定性。
聚类与对冲机制
- • 动态聚类提升了模型对市场状态的适应能力,使资产权重在不同市场环境下保持更优分布,增强组合的长期稳定性;
- • LLM驱动的对冲机制则显著提升了风险调整后收益:夏普比率平均提升31%,在季度再平衡条件下,提升幅度扩大至63%。
值得注意的是,尽管LLM在预测高收益行业方面能力有限,但其在识别互补性或风险对冲型行业方面表现出色。例如,在科技板块回调时,模型能自动识别防御性行业(如公用事业、医疗保健)并增加配置,从而有效对冲下行风险。
五、方法的贡献与创新点
基于无悔学习的贪婪型投资组合策略
本研究提出一种新型资产配置优化框架,其核心在于将无悔学习(no-regret learning)机制引入在线投资组合优化过程,通过动态再平衡主动最小化“事后后悔值”(hindsight regret)。该策略在长期运行中确保累积遗憾值趋于零,即其表现逼近所有可能静态策略中表现最优者,从而在渐近意义上实现近似最优的动态适应能力。与传统静态或周期性再平衡方法相比,该框架能够实时响应市场变化,避免因固定权重导致的滞后性与低效性。
大语言模型驱动的聚类与对冲机制
本研究将大语言模型深度整合至投资组合构建流程,建立市场情绪与资产配置之间的系统性连接。这一机制突破了传统情绪分析仅用于辅助判断的局限,实现了从情绪信号到资产聚类与对冲决策的结构化映射。
该方法具备对宏观与微观情绪变化的强响应能力。当市场情绪剧烈波动时,LLM能够快速解析新闻文本、政策公告与市场评论,提取关键主题并动态调整行业聚类结果,从而引导投资组合及时转向更具韧性的资产类别。进一步地,通过引入伪对冲机制,即在组合中配置低相关性行业,有效分散非系统性风险,显著提升整体组合的稳定性与风险调整后收益。