Z-Image标准版开源:更具可塑性的图像生成全能基座
Z-Image标准版是为追求极致微调与创作自由的开发者准备的强大画板,它找回了被速度牺牲掉的艺术多样性。
Z-Image在Z-Image-Turbo刷新榜单后正式登场:Flux 2开源即结束:阿里通义Z-Image用6B参数,实现超高性能和生图速度,荣登开源榜首。
Turbo版本曾在Artificial Analysis文本生图排行榜上夺得开源模型第一的成绩。
标准版则是一个非蒸馏的完整模型,处于有监督微调(SFT)阶段,保留了最原始、最丰富的权重分布。
对于希望进行二次开发、训练LoRA或ControlNet的社区开发者而言,这是一个比Turbo版本更具可塑性的全能基座。
它不仅解决了生成模型常见的同质化问题,还通过独特的架构设计实现了对提示词和负面提示词的精准响应,为精细化创作打开了大门。
微调与风格化的潜力
Z-Image-Turbo版本通过强化学习(RL)和蒸馏技术,极大压缩了推理步骤并强化了写实效果。
标准版则还原了引擎的本来面目。
它没有经过激进的蒸馏压缩,保留了完整的模型权重和内部特征。在面对下游任务时表现出极高的适应性。
当开发者需要训练特定风格的LoRA或接入ControlNet进行结构控制时,标准版提供了更稳健的梯度反馈,使得新概念的学习更加顺滑,避免了蒸馏模型在微调时容易出现的过拟合或特征丢失现象。
艺术风格的多样性在标准版中得到了释放。
Turbo版本为了追求极致的照片写实感,往往会收敛生成的概率分布,导致生成的图像主体、姿态、风格趋向统一。
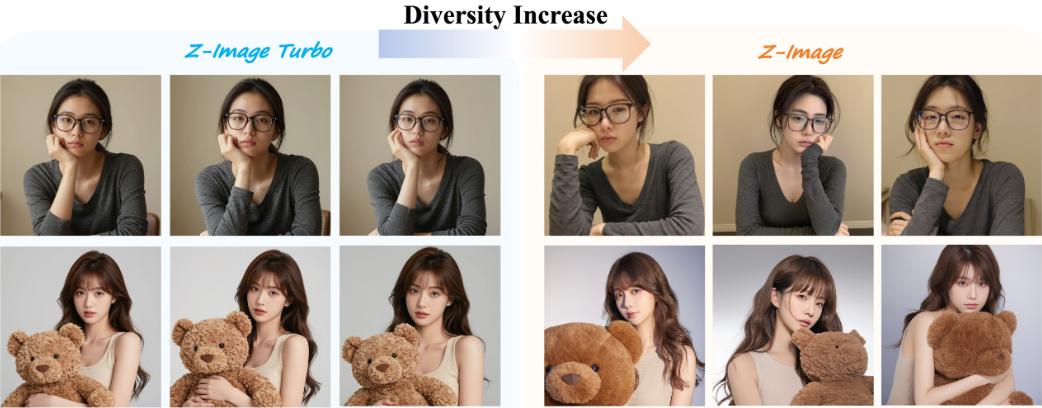
标准版则处于有监督微调阶段,它像是一个博学的艺术家,尚未形成固定的画风偏好。
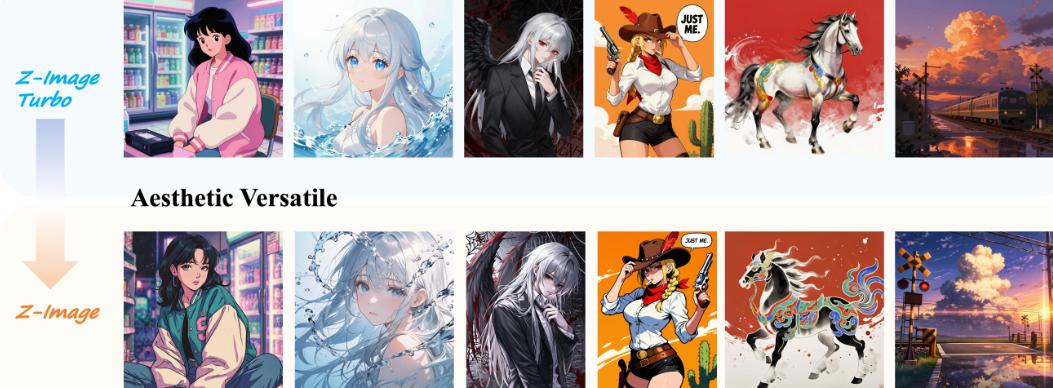
它能够理解并执行更多样化的美学指令,而不是强行将所有画面都渲染成现实世界的照片。
开发者在面对创意类项目时,会发现标准版是一个更听话、更有想象力的合作伙伴,它能准确捕捉到那些抽象的艺术需求。
标准版利用其内部丰富的多样性和未被剪枝的权重分布,为下游训练提供了坚实的基础。
在进行新概念注入时,模型能够保持原有的语义理解能力不崩塌,同时有效吸收新的特征。
这对于社区开发者来说至关重要,它降低了微调的门槛和失败率,让个人和小团队也能基于这一底座训练出高质量的垂直领域模型。
单流架构与训练策略
Z-Image采用了创新的可扩展单流扩散Transformer(S3-DiT)架构。
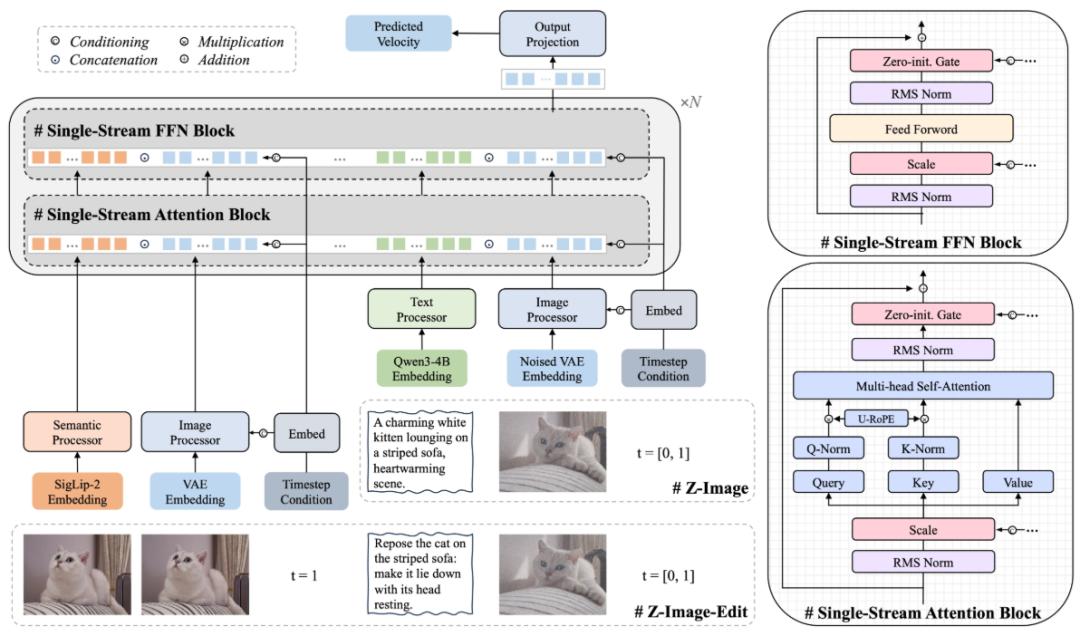
传统的主流文生图模型多采用双流架构,即文本和图像分别通过不同的编码器处理,再通过交叉注意力机制进行交互。
这种方式就像两个人分别通过对讲机沟通,信息传递存在损耗和延迟。
S3-DiT架构打破了这一隔阂,它将文本语义tokens(tokens)、视觉语义tokens和图像VAE tokens在序列层面直接拼接,形成一条统一的输入流。
文本和图像数据在同一个Transformer网络中并行处理,实现了真正的多模态深度融合。
这种设计在参数利用效率上具有显著优势,能够用更少的参数量实现甚至超越双流架构的多模态理解能力,大大降低了显存占用和计算成本。
训练流程的设计决定了模型的能力边界。
Z-Image系列的训练经历了预训练(Pre-Training)、有监督微调(SFT)和强化学习(RL)三个阶段。
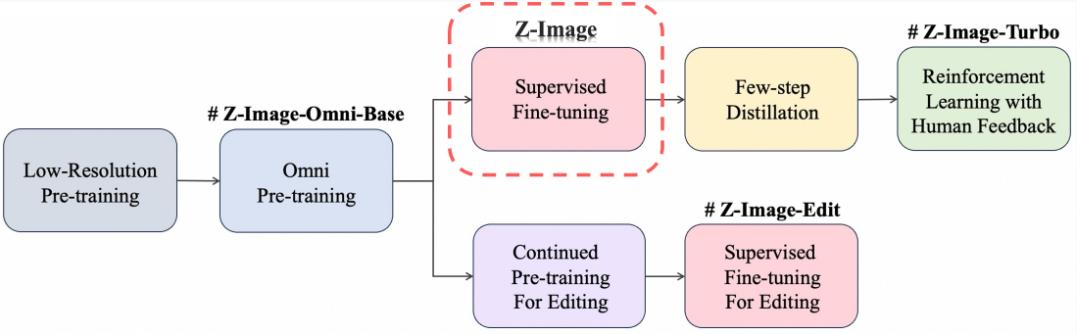
Z-Image标准版定位于SFT阶段,预训练赋予了模型广泛的世界知识,SFT教会了模型如何听懂指令,而RL通常用于进一步对齐人类偏好。
停留在SFT阶段的标准版,既具备了听懂复杂提示词的能力,又避免了RL阶段可能带来的偏科现象。它保持了最大程度的生成多样性,为后续的个性化调整留出了充足的空间。
CFG(Classifier-Free Guidance)支持的完整性是标准版的一大亮点。
在许多蒸馏或高速模型中,为了追求推理速度,往往会牺牲或绕过分类器引导,导致CFG Scale参数失效,用户难以通过调整该参数来控制提示词的权重。
标准版保留了完整的CFG支持,用户可以精确调节提示词对生成结果的影响力。
这种精确的控制力对于专业创作者来说是必不可少的工具,它允许创作者在忠实于提示词和发挥模型创造力之间自由寻找平衡点。
解决同质化并提供完善工具链
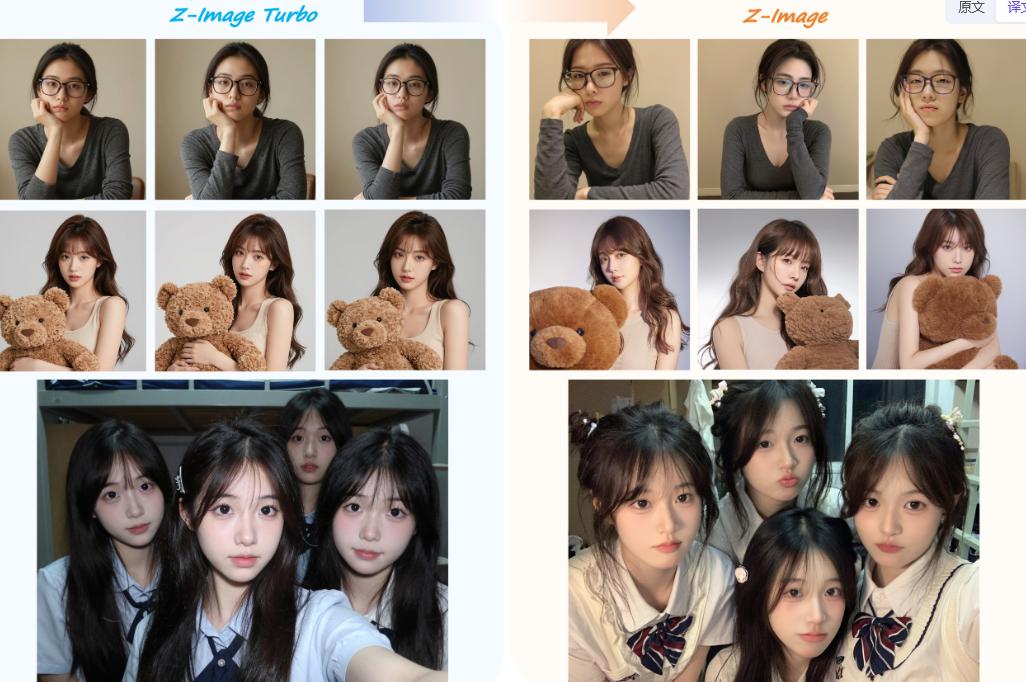
Z-Image标准版极大地改善了随机种子的响应机制,不同的随机种子能生成构图、光影乃至面部特征截然不同的图像。
这彻底解决了相同脸的问题,让每一次生成都成为独一无二的创作。
在处理多人场景时,模型能够根据提示词为不同个体赋予独特的特征,避免了画面中出现多个人物长着同一张脸的诡异克隆效应。
标准版对负面提示词(Negative Prompt)表现出极高的敏感度。
开发者可以通过输入特定的负面词汇,精准剥离画面中不需要的元素,如模糊、畸变或特定的风格特征。
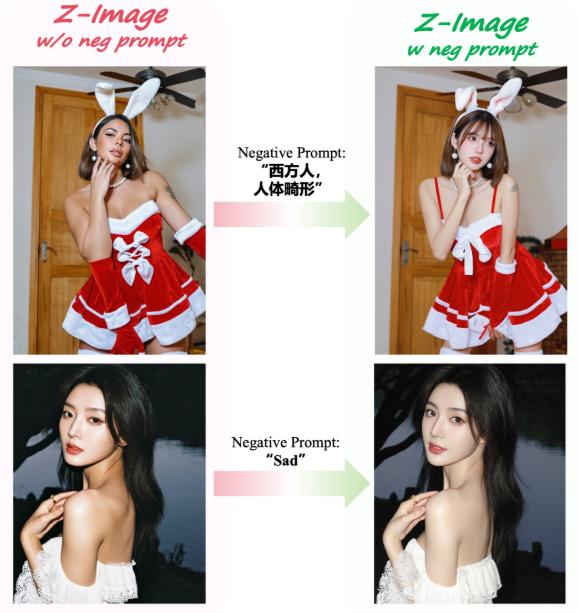
用户在面对复杂生成任务时,拥有了正向引导和负向剔除的双重控制手段,极大地提升了成图的可控性和成功率。
魔搭社区(ModelScope)的DiffSynth-Studio团队为其提供了完整的微调工具链,大大降低了上手门槛。
同步发布的Z-Image-i2L(Image-to-LoRA)模型更是一个创新的实用工具。
它允许用户仅通过几张风格统一的图像,就能快速提取并生成对应的风格LoRA。
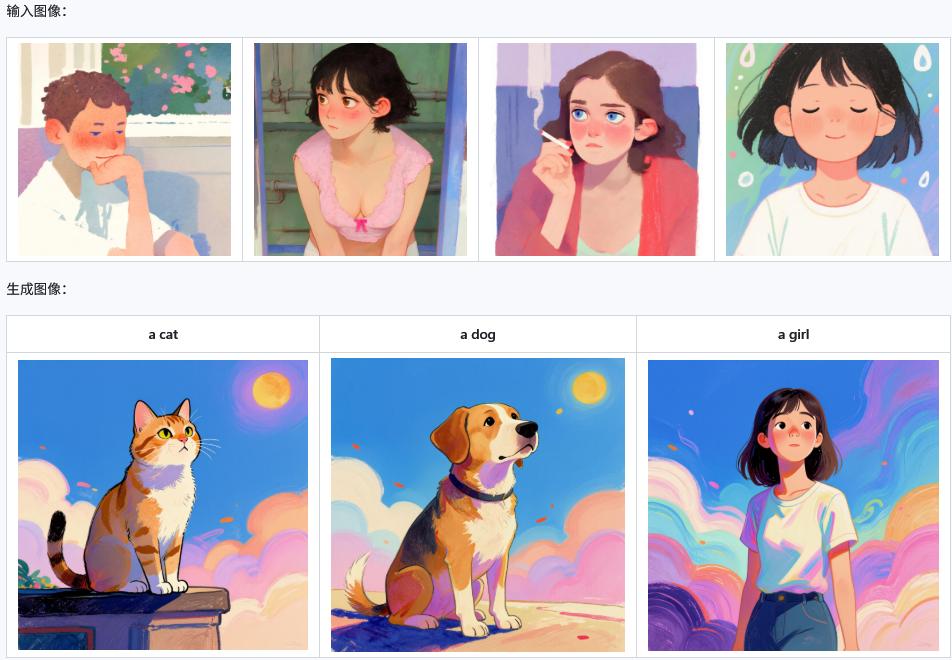
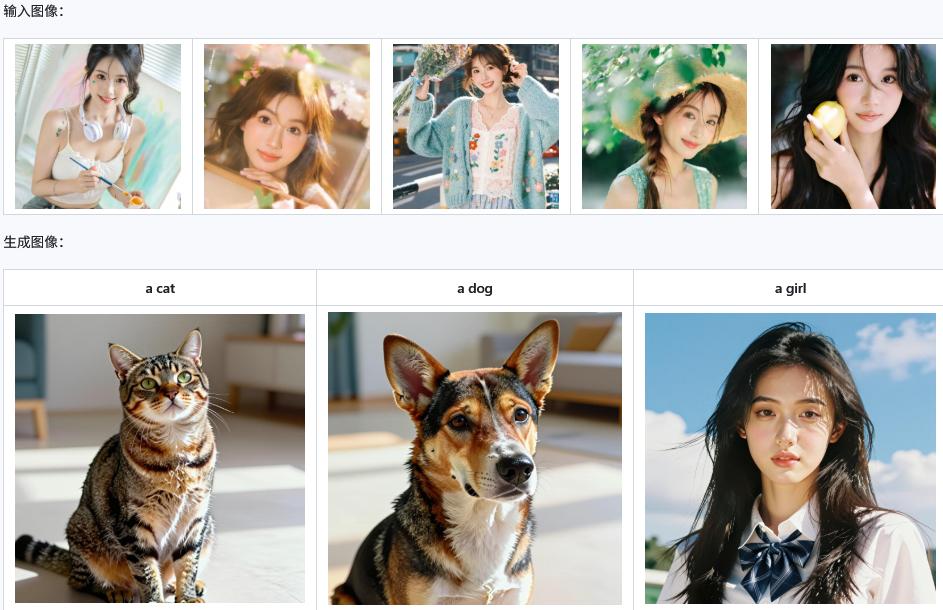
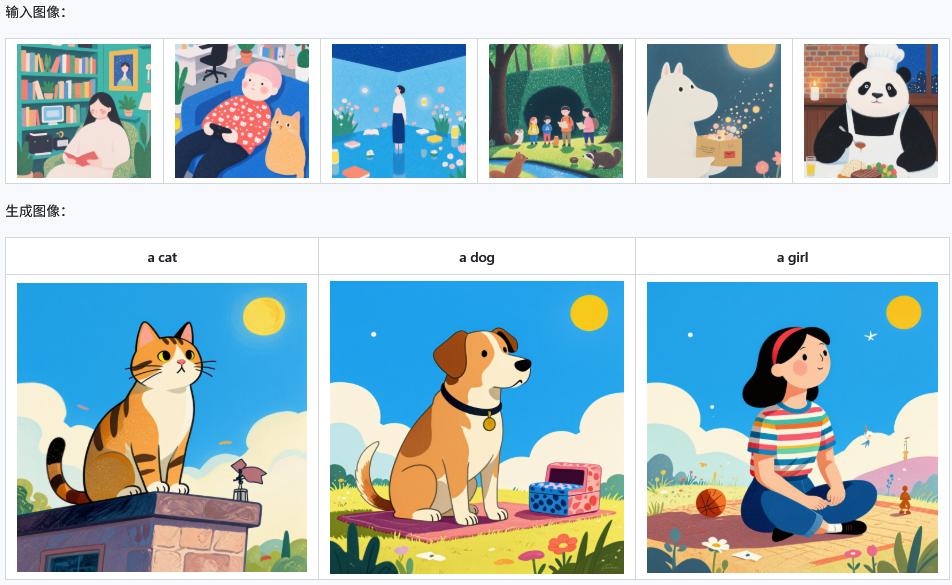
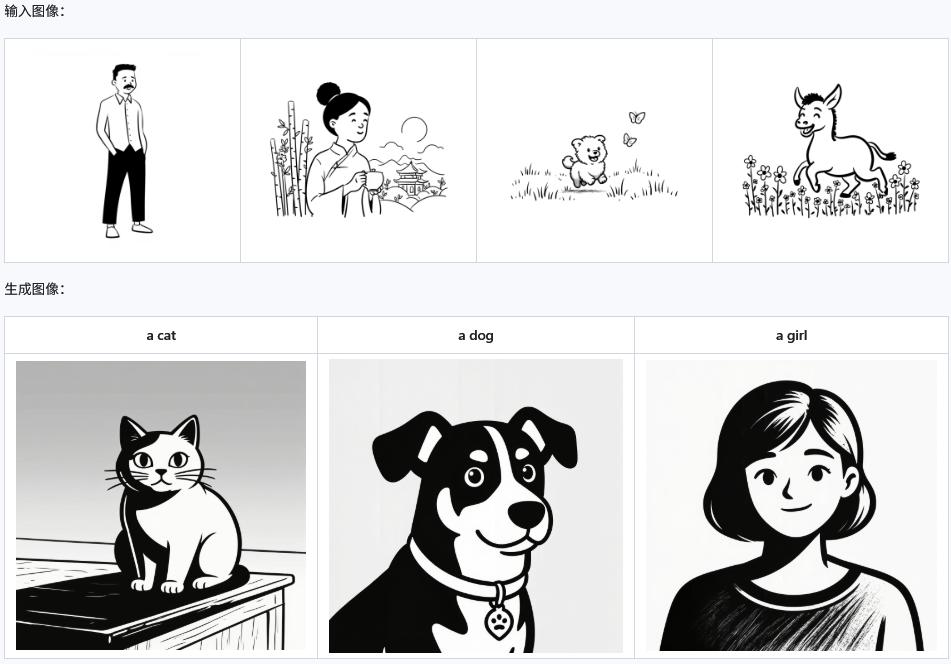
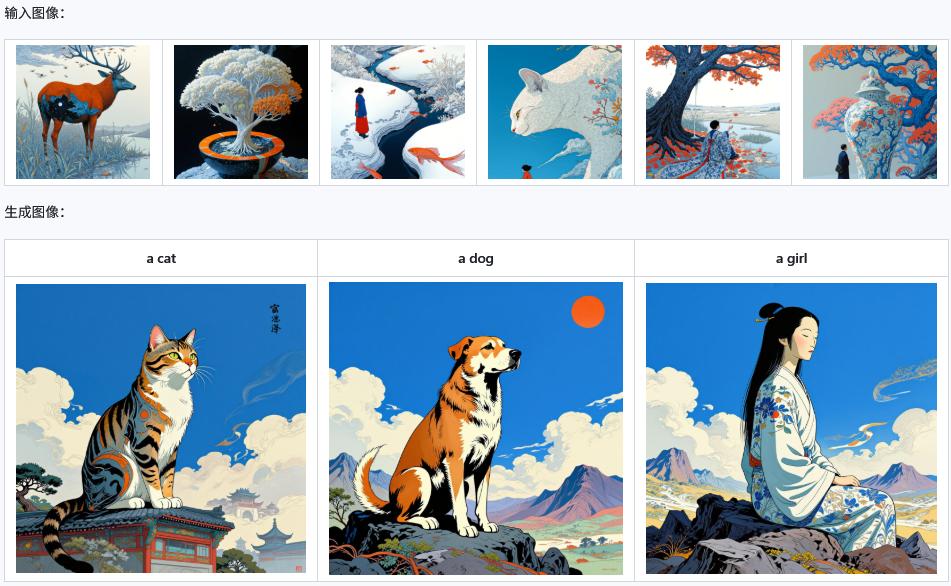
为了达到最佳效果,团队给出了详细的参数建议,特别强调了在生成LoRA时负面提示词的使用以及正负向提示词的非对称配置。
Z-Image-i2L 推荐参数设置:
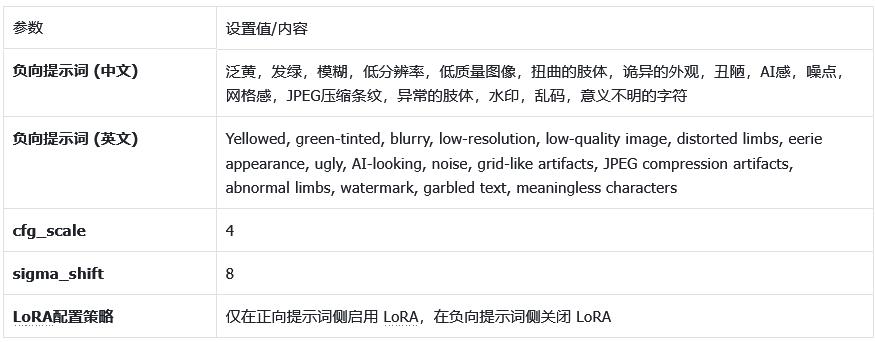
通过在正向启用而在负向关闭LoRA,可以最大程度地保留LoRA带来的风格特征,同时利用底座模型本身的抗干扰能力过滤掉低质量的伪影。
Z-Image标准版为开发者提供了一个高性能的模型,更提供了一套完整的创作解决方案。
参考资料:
https://tongyi-mai.github.io/Z-Image-blog/
https://www.modelscope.cn/models/Tongyi-MAI/Z-Image
https://huggingface.co/Tongyi-MAI/Z-Image
https://modelscope.cn/models/DiffSynth-Studio/Z-Image-i2L