UCL汪军教授提出Memento 2:让大模型智能体能够 “温故知新”
你有没有过这样的困惑:明明AI助手能解答各种问题,却总在重复犯同一个错误?比如上次教它怎么整理你的工作文档,下次换个类似格式,它又变回“小白”;更头疼的是,那些需要长期跟进的任务——比如帮你优化代码、分析实验数据,它永远没法积累经验,每次都要从头开始。
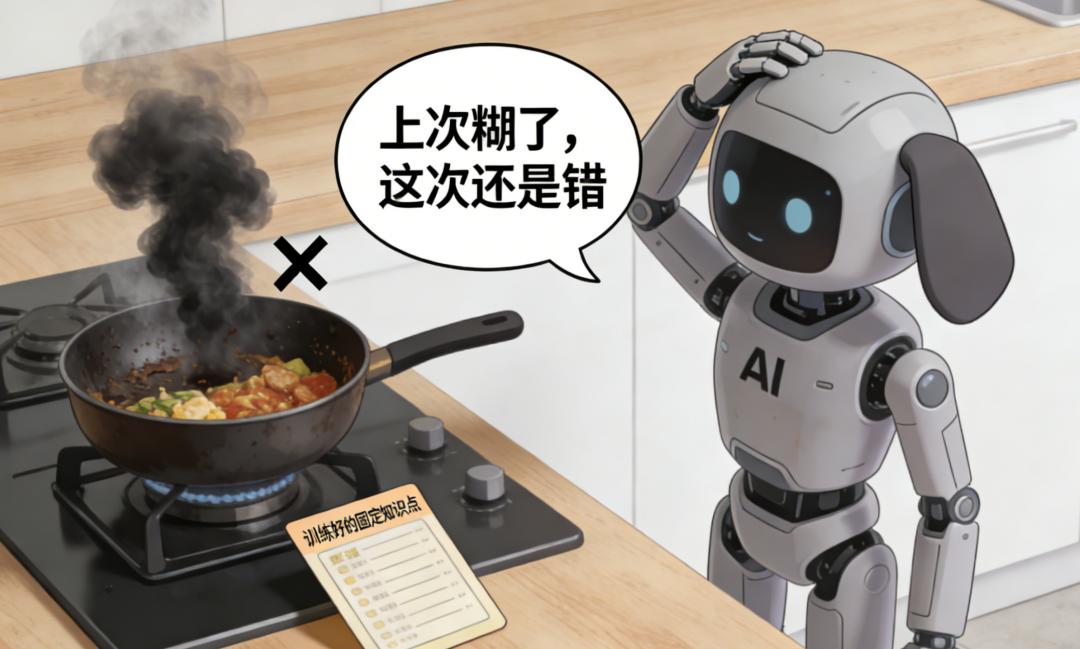
而我们人类不一样:第一次做饭糊了,下次会记得少放调料、缩短火候;第一次做报告踩了坑,下次会自动避开同样的逻辑漏洞。这种“从经验中学习、不用重新学一遍”的能力,为什么AI一直学不会?
最近我在研究一篇名为《Memento 2: Learning by Stateful Reflective Memory》的论文时,突然找到了答案。这篇来自UCL汪军团队的研究,没有走“增大模型参数”“用更多数据微调”的老路,而是给大模型装上了一套“可读写的记忆系统”,让它像人类一样“温故知新”——不用修改模型本身,只靠积累和反思过往经验,就能在各种任务中持续自我提升。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
本文我们就讲讲这个让AI告别“一次性学习”的核心逻辑。
一、先搞懂:AI的“学习困境”到底卡在哪?
在聊新技术之前,我们得先明白传统AI为什么“学了就忘”。这背后其实是两个核心痛点:
1. 传统AI的“学习模式”太僵硬
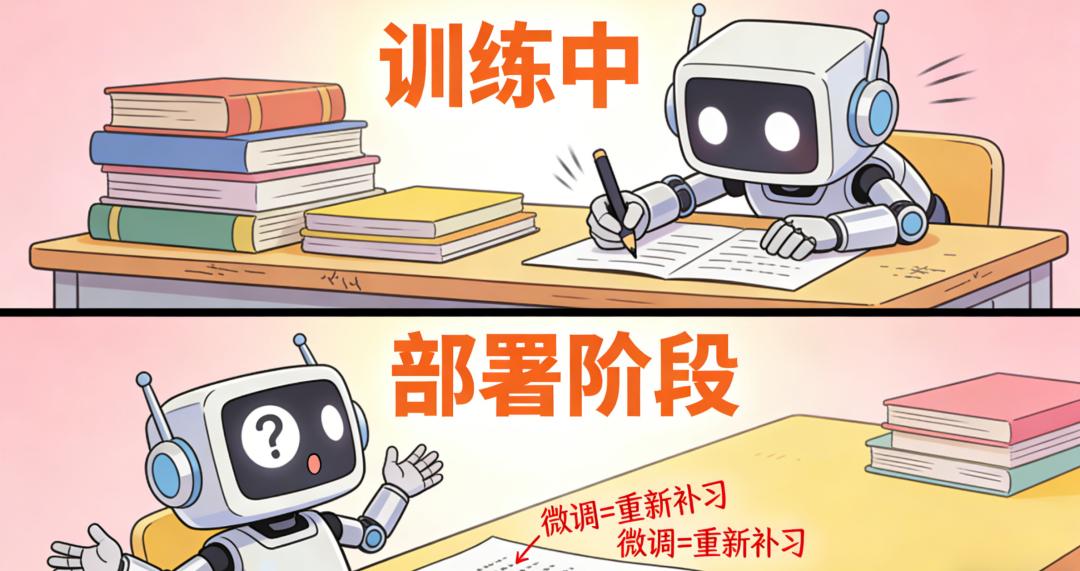
不管是我们熟悉的ChatGPT,还是各种行业大模型,本质上都是“训练时学完,部署后就固定”的模式。就像一个学生:考试前(训练阶段)死记硬背了很多知识点,考试时(部署后)只能靠脑子里的存货答题,遇到新题型(未见过的任务)要么不会,要么出错。
如果想让它适应新任务,比如从“翻译英文”变成“写测试脚本”,就必须进行“微调”——相当于让学生重新参加一轮补习班,不仅要花大量时间,还得准备专门的“补习资料”(标注数据),普通人根本玩不起。
2. AI没有“真正的记忆”,只有“死记硬背”
人类的记忆分两种:一种是“语义记忆”(比如知道“苹果是水果”),另一种是“情景记忆”(比如记得上次买苹果踩了坑,这次要选红的)。而传统大模型只有前者——它们能记住训练数据里的知识,却没法存储“自己的经历”,更没法从经历中反思。
比如你让AI帮你写一段代码,它写错了,你指出错误后,它能改对当下的版本,但下次遇到类似场景,它还会犯同样的错。因为它没有把“这次写错代码、如何修正”的经历存起来,更不会主动反思“为什么错、下次怎么避免”。
这就是为什么AI总是“看起来很聪明,却越用越让人着急”——它没有形成“经历-反思-改进”的闭环,本质上只是一个“高级知识库”,而不是一个能“持续成长”的智能体。
二、核心创新:给AI装一套“可读写的记忆系统”
这篇论文的突破,不在于发明了新的模型结构,而在于重构了AI的“学习逻辑”——把“靠参数微调学习”变成“靠记忆读写学习”。这个逻辑的核心,就是他们提出的“状态反思决策过程(SRDP)”。
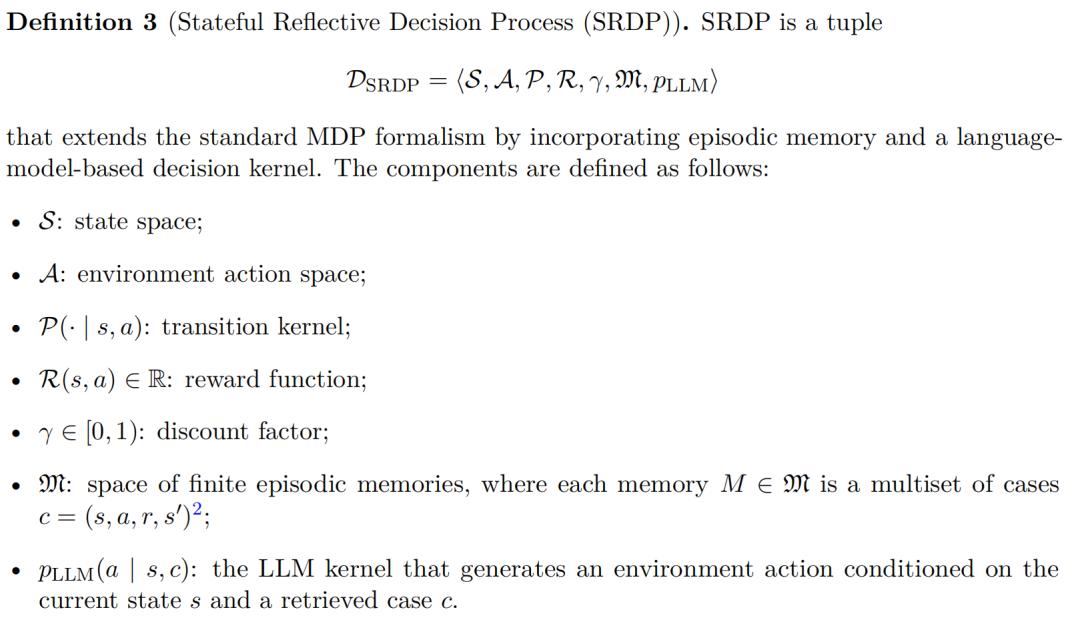
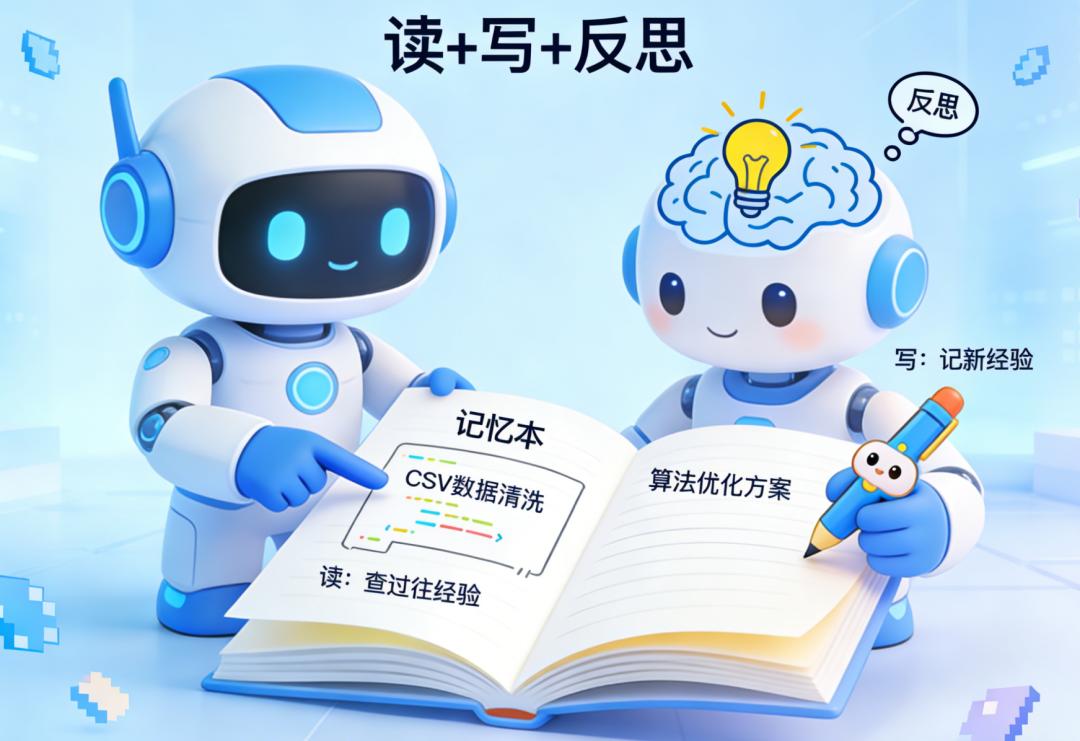
简单说,SRDP就是给大模型配了三个关键组件:一个“记忆本”(情景记忆库)、一个“查阅记忆的方法”(检索机制)、一个“记录经验的规则”(写入机制)。AI在工作时,会不断重复“查记忆→做决策→记经验”的循环,就像我们工作时“查笔记→处理任务→总结心得”一样。
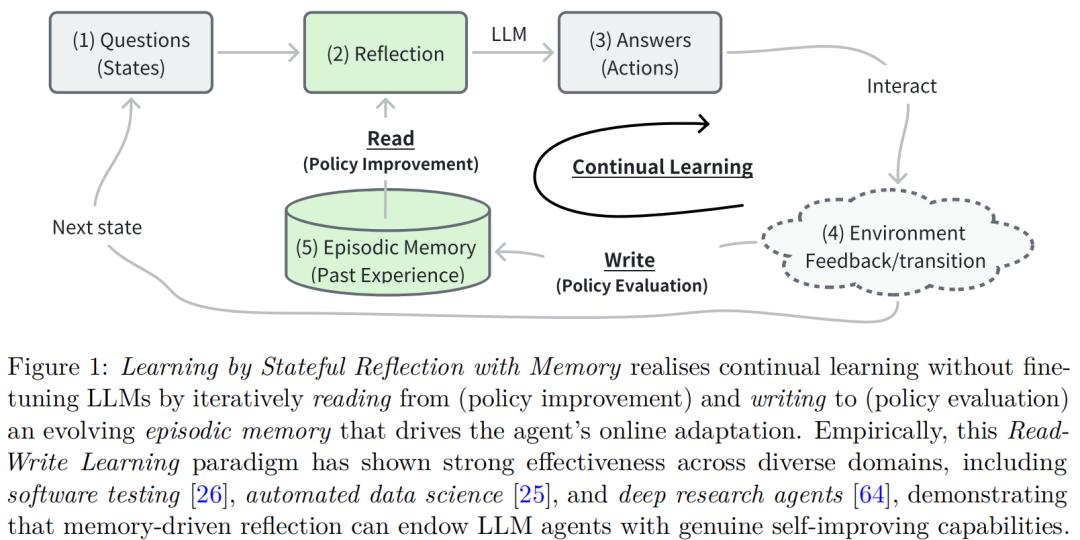
1. 核心操作:“读”和“写”,像极了我们记工作笔记
整个系统的运作,就围绕两个最简单的动作:
(1)“读”:遇到问题,先查过往经验
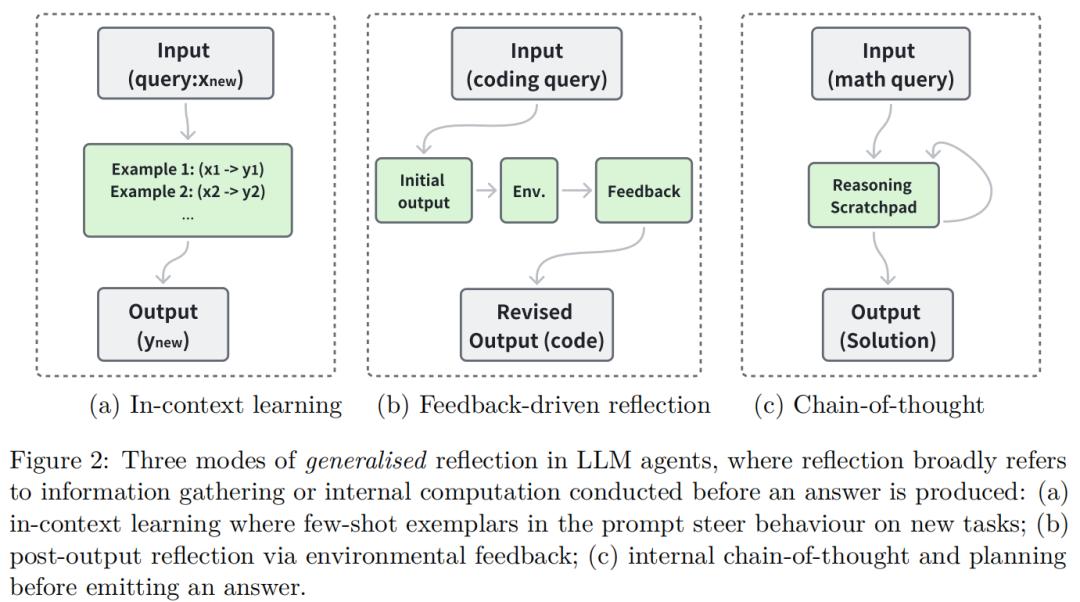
当AI遇到一个新任务(比如“写一个数据清洗的脚本”),它不会直接硬着头皮生成答案,而是先打开自己的“记忆本”,检索有没有类似的过往经历。
这个“检索”不是瞎找,而是像我们查字典一样有方法:它会根据当前任务的特点(比如“数据格式是CSV”“需要去除空值”),找到记忆中最相似的案例——比如上次帮用户处理CSV数据时,用了哪些函数、踩了哪些坑。
这里的巧妙之处在于,AI不会直接照搬记忆里的答案,而是把过往案例当成“参考”。比如上次处理的是销售数据,这次是实验数据,AI会结合当前任务的需求,调整记忆中的方法,形成新的解决方案。这就像我们做项目时,参考过去的成功案例,但不会完全复制,而是根据新需求做适配。
(2)“写”:做完任务,立刻记录经验
当AI完成任务、得到反馈(比如用户说“这个脚本能用”,或者系统检测到“运行成功”),它会把这次的经历详细记到“记忆本”里:包括“遇到的问题(状态)”“采取的行动(写的脚本)”“得到的结果(反馈)”。
更重要的是,这个“记忆本”是动态更新的——随着任务越来越多,记忆会越来越丰富,AI检索到有效经验的概率也会越来越高。就像一个医生,看的病人越多,病历本越厚,下次遇到类似病症时,诊断就越准确。
2. 关键设计:把“记忆”变成决策的一部分
传统的AI决策,只看“当前任务是什么”;而SRDP的决策,看的是“当前任务+过往记忆”。这就像两个厨师:
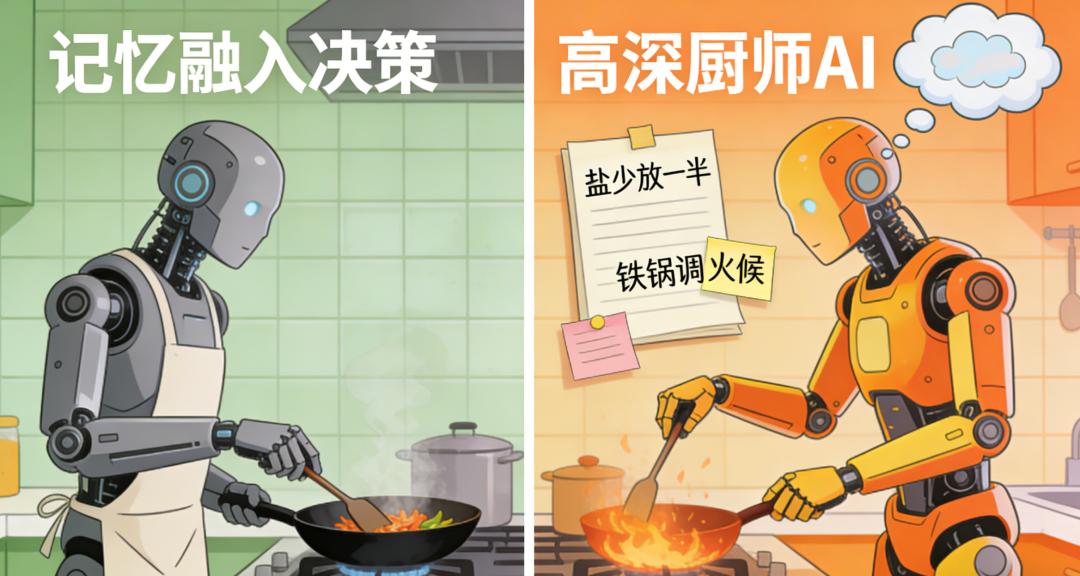
• 普通厨师(传统AI):只看眼前的菜谱(当前任务),不管之前做过多少次,每次都按菜谱一步步来,错了也不知道总结;
• 资深厨师(SRDP智能体):不仅看菜谱,还会想“上次做这道菜时,盐放多了导致口感咸,这次要少放一半”“上次用了不粘锅,这次用铁锅得调整火候”——这些“过往经验”会直接影响他当下的操作。
为了让这个逻辑严谨,论文还把“记忆+当前状态”整合起来,形成了一个“增强状态空间”。这样一来,AI的决策就依然符合马尔可夫性(简单说就是“未来的决策只和现在有关,和过去无关”),保证了系统的稳定性,也为后续的理论分析打下了基础。
为了更直观地展示这个决策过程,论文里的Figure 3画得非常清晰——它就像AI的“工作流程图”,把“查记忆→做决策”的两步走逻辑可视化了。先简单说下Figure 3的核心结构:图里的虚线框是“增强状态”,也就是“当前任务状态 + 过往记忆”;绿色节点代表“检索动作”,蓝色节点代表“AI最终的环境动作”;红色箭头是“记忆写入”,记录每次任务的结果。整个图清晰地展示了AI从接收任务到更新记忆的完整闭环。
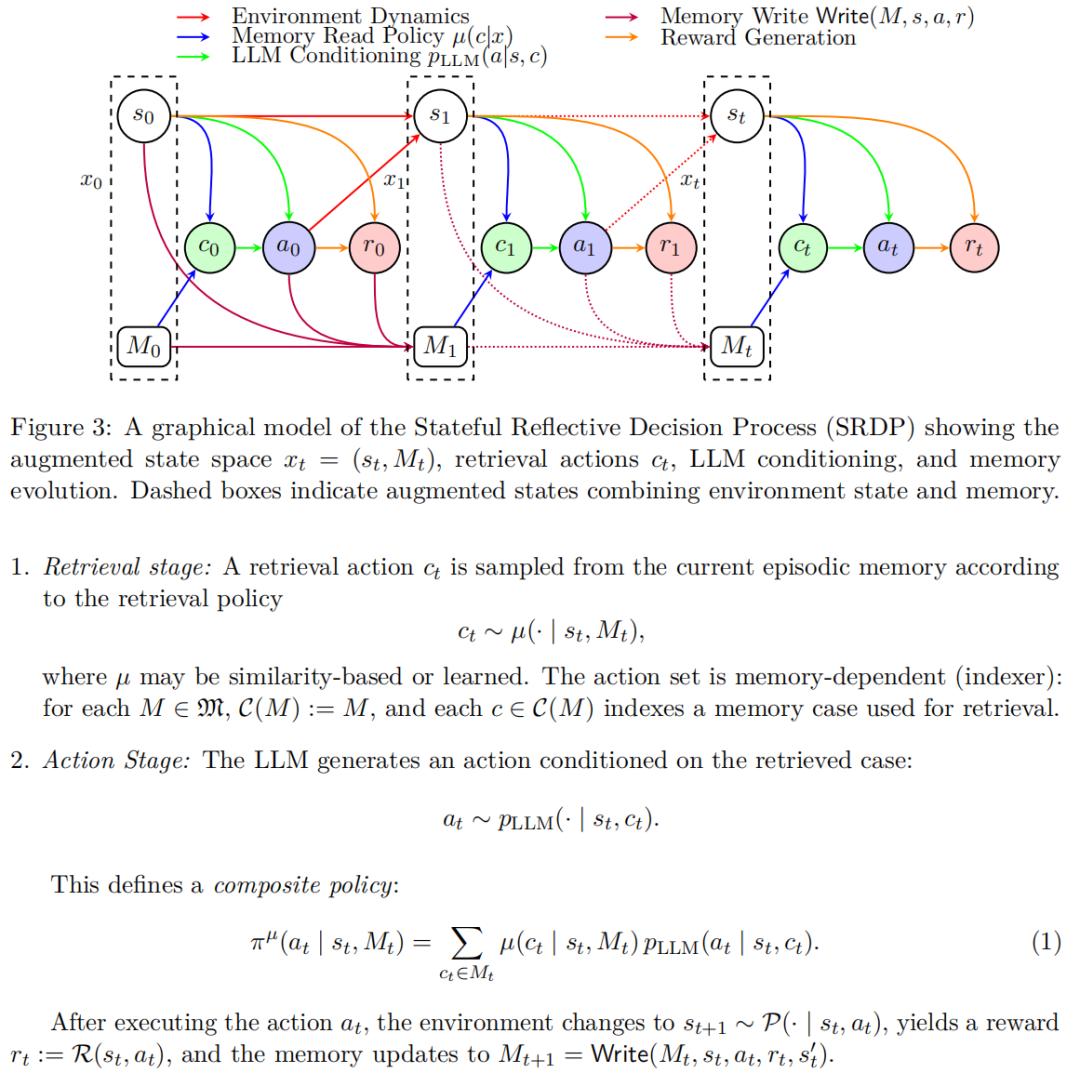
这个流程拆解开来,就是SRDP的两个核心阶段:
1)Retrieval stage:检索阶段——给当前任务找“参考案例”
这一步对应Figure 3里的绿色节点,核心是“从记忆里找有用的经验”。AI会根据当前的任务状态(比如“要写数据清洗脚本”),从自己的记忆库里,通过检索策略μ筛选出最相关的案例。
这个检索策略不是“随缘找”,而是有明确的判断标准:一方面看当前任务和记忆案例的“相似度”(比如都是处理CSV数据),另一方面看记忆案例的“局部密度”(比如某类任务的成功案例越多,优先级越高)。就像我们做数学题时,先翻笔记本找“同类型的例题”,而不是随便翻一页乱看。
更贴心的是,论文还设计了“空案例”——如果记忆库里没有相关经验(比如AI第一次处理这类任务),就会触发这个空案例,让AI直接靠自己的内置知识决策。这就像新手厨师第一次做某道菜,没有过往经验可参考,就只能严格按菜谱来。
2)Action Stage:动作阶段——结合案例生成最终决策
这一步对应Figure 3里的蓝色节点,核心是“用LLM把参考案例变成具体行动”。AI会把当前任务和检索到的案例一起传给大模型,让大模型生成最终的环境动作(比如具体的代码脚本、任务方案)。
这里的关键是“结合”而非“照搬”。比如检索到的案例是“处理销售CSV数据的脚本”,而当前任务是“处理实验CSV数据”,LLM会分析两者的差异(比如实验数据有更多缺失值),然后调整代码逻辑,生成适配当前任务的脚本。这就像资深厨师参考旧菜谱时,会根据手边的食材调整步骤,而不是死记硬背。
Figure 3里的蓝色箭头和绿色箭头,正好体现了这两个阶段的关联:蓝色箭头是“当前状态+记忆”驱动检索,绿色箭头是“检索案例+当前状态”驱动动作生成,两者环环相扣,构成了AI的决策核心。
三、为什么这个方法能成?三个核心优势
我在研究这个框架时,最惊讶的是它不仅“听起来合理”,还有扎实的理论支撑和实践效果。总结下来,它的优势主要在三个方面:
1. 理论可证明,收敛有保障
很多AI创新都是“先有实验效果,后有理论支撑”,但这篇论文反过来——先建立了完整的理论框架,证明了“随着记忆库扩大,AI的决策会收敛到最优解”。
核心突破在于,团队通过“增强状态空间”(当前任务+ episodic记忆),让原本因记忆动态更新而破坏的马尔可夫性得以恢复。这就像给动态的系统装了个“稳定器”,让传统强化学习的分析工具能直接套用,为后续收敛性证明打下基础。
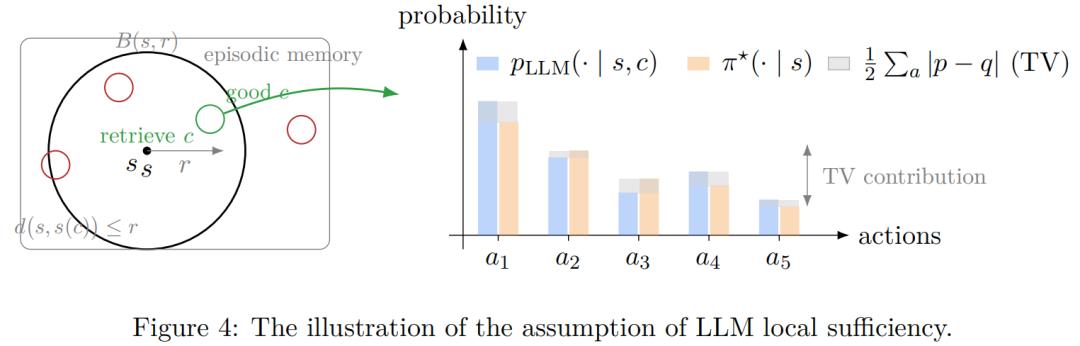
论文明确给出两大关键定理:一是固定记忆时,读写学习迭代会收敛到KL正则化目标的最优解,意味着AI的决策策略会稳定提升,不会反复波动;二是记忆缓慢更新时,通过“双时间尺度”设计——快节奏优化决策、慢节奏积累记忆,整个系统依然能收敛到最优配置。
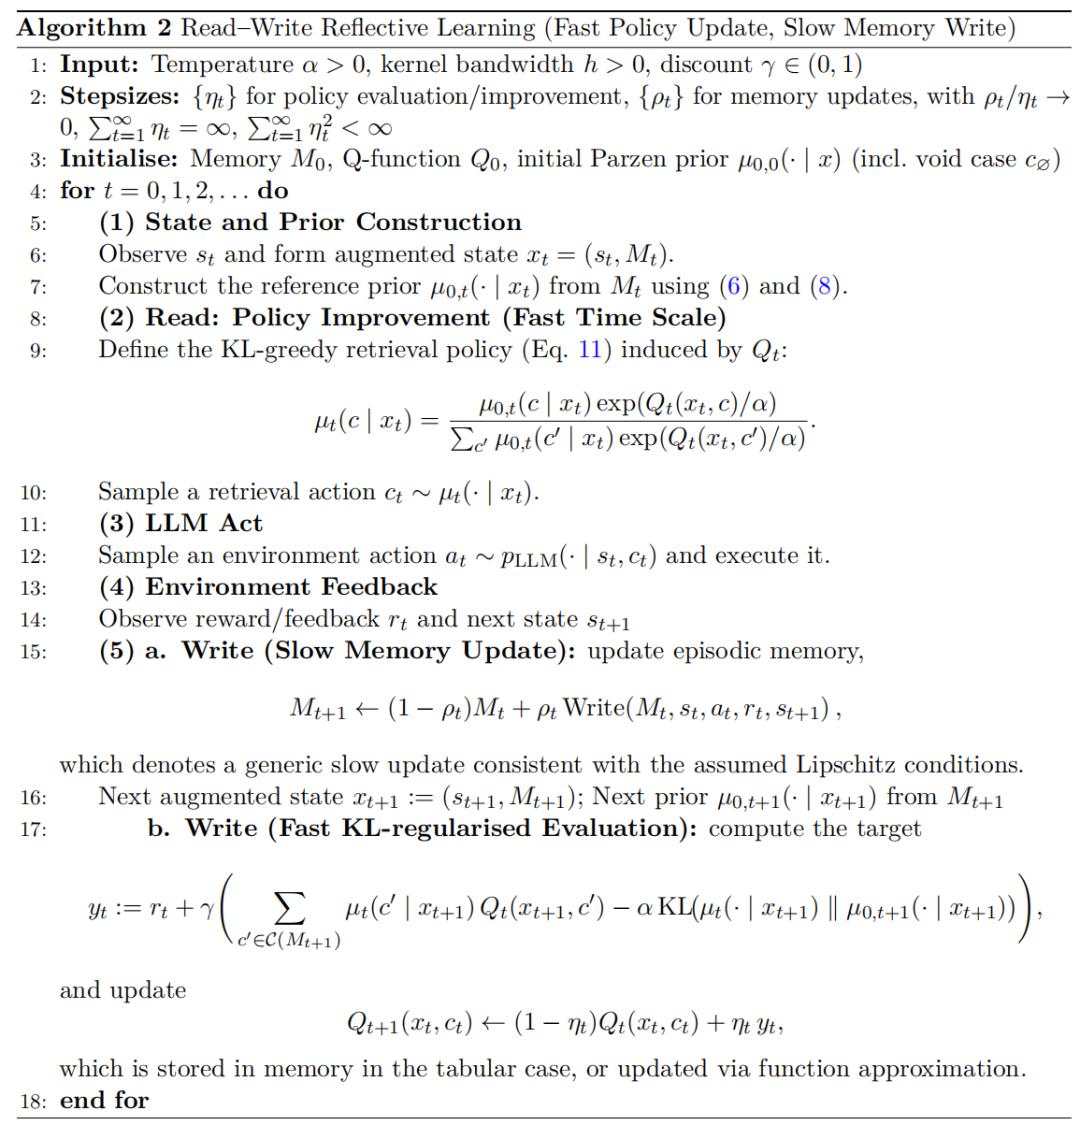
这意味着AI的进步不是“碰运气”:随着记忆库覆盖更多场景,它的决策会持续逼近“理论上的最好水平”,不会出现“学了新经验就丢了旧本领”的情况。这种从“经验性有效”到“理论上可靠”的跨越,正是SRDP能规模化应用的核心底气——毕竟,只有能稳定收敛的系统,才值得被投入实际场景依赖。
2. 学习效率极高,样本需求大幅减少
人类之所以能“举一反三”,就是因为我们能从少数经验中提炼规律。SRDP智能体也一样:它不需要大量重复的数据来训练,而是靠“高质量的记忆+有效的反思”,从几个案例中就能学到通用方法。
论文里的实验也证明了这一点:在软件测试、自动数据科学、深度研究等任务中,SRDP智能体只需要积累少量经验,性能就超过了需要大量微调的传统模型。这就像一个聪明的学徒,看师傅做几次就学会了核心技巧,而不是需要重复做几百次才能掌握。
3. 不用微调,成本极低
这是最直观的好处。传统的大模型微调,动辄需要几万、几十万条标注数据,还得用几十块GPU跑几天,普通团队根本承受不起。而SRDP智能体,只需要一个“冻结参数”的大模型(比如GPT-3.5),再加上一个记忆库,就能实现持续学习。
就像我们不用重新上学,只靠工作中积累的笔记和经验,就能不断提升专业能力——这种“边干活边学习”的模式,比“专门花时间培训”效率高多了。
四、未来能用到哪?这些场景已经开始受益
虽然这还是一篇理论为主的论文,但它的应用前景已经非常清晰。根据论文中的实验和我的判断,以下几个场景会最先受益:
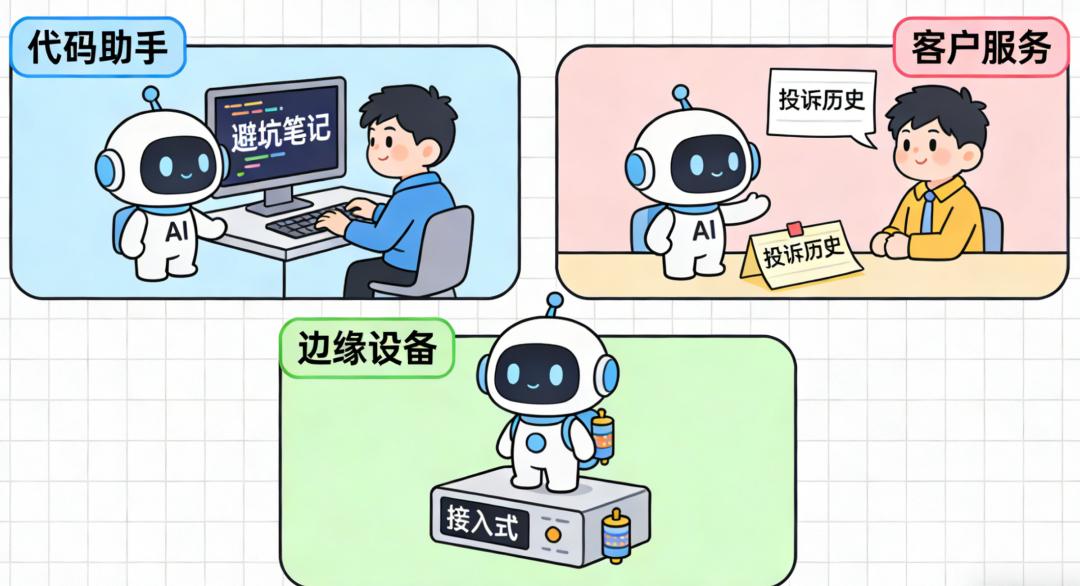
1. 专业工具类AI:越用越顺手
比如帮程序员写代码、做测试的AI助手,帮数据分析师处理数据、生成报告的工具,帮科研人员查文献、设计实验的智能体。这些工具的核心需求是“适配用户的工作习惯”“积累领域内的专业经验”,而SRDP的记忆机制正好能满足这一点。
想象一下:你的代码助手记得你喜欢的编程风格,记得你经常用的函数库,甚至记得你之前踩过的语法坑,下次写代码时直接帮你避开——这种“私人定制”的体验,比现在通用的AI工具要好用得多。
2. 长期任务类AI:持续跟进不脱节
比如项目管理AI、客户服务AI、个人助手等,这些AI需要长期跟进一个任务或一个用户,积累的经验越丰富,服务质量越高。
比如一个客户服务AI,记得某个客户之前的投诉历史、偏好的解决方案,下次客户再来咨询时,不用客户重复说明情况,就能直接给出针对性的回应;一个项目管理AI,记得之前项目中出现的延期原因、风险点,下次规划项目时,能自动调整时间表和资源分配。
3. 资源受限场景:小模型也能有大能力
在一些资源有限的场景,比如边缘设备、嵌入式系统,没法运行超大参数的模型,也没法进行微调。这时SRDP的优势就凸显出来了——只需要一个小模型,再加上一个轻量化的记忆库,就能实现“小模型+大记忆”的效果,满足复杂任务的需求。
五、现在还存在哪些挑战?
这个框架还存在需要进一步探索的问题:
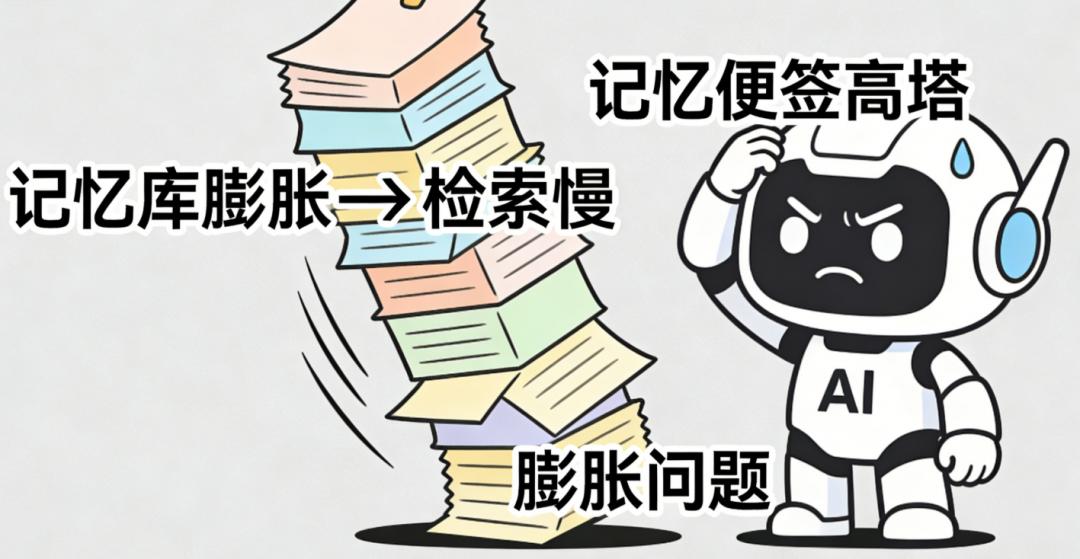
1. 记忆库的“膨胀问题”
随着任务越来越多,记忆库会越来越大,检索速度会变慢,存储成本也会增加。就像我们的笔记本记满了之后,找东西会越来越麻烦。论文中提到了一些解决方案,比如自适应调整检索的“范围”,或者定期清理没用的记忆,但如何在“记忆完整性”和“检索效率”之间找到平衡,还需要进一步研究。
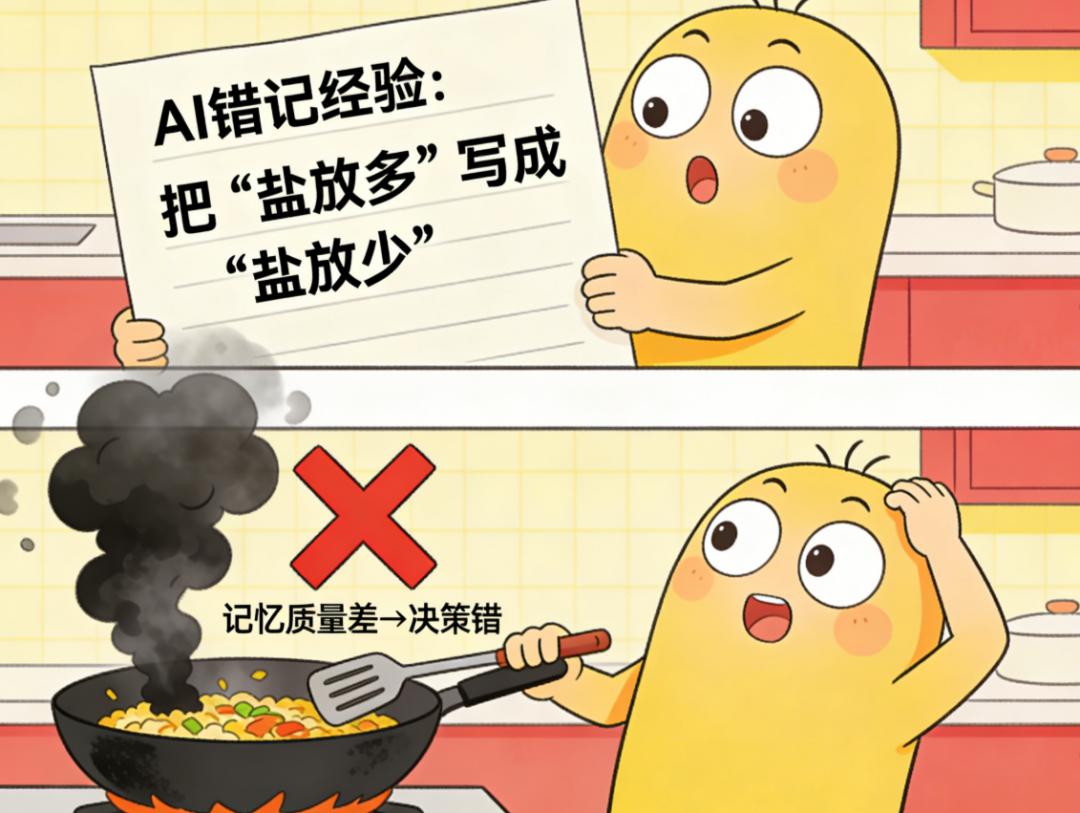
2. 记忆的“质量问题”
如果AI记录的经验是错误的,或者是低质量的,那么后续的决策也会受影响。就像一个人记错了“上次成功的方法”,下次照着做只会错得更离谱。如何让AI自动筛选高质量的经验、剔除无效或错误的记忆,是未来需要解决的关键问题。
3. 嵌入质量的影响
AI检索相似经验时,需要先把“当前任务”和“过往经验”转换成统一的“向量格式”(嵌入)。如果这个转换的质量不高,就可能找不到最相关的经验。目前这个问题依赖于预训练模型的嵌入能力,如何优化嵌入方法,让它更贴合具体任务,也是一个需要探索的方向。
六、总结:AI从“知识库”到“智能体”的关键一步
这篇论文最让我着迷的地方,在于它回归了“智能”的本质——智能不是靠“记住更多知识”,而是靠“从经验中学习”。人类之所以能成为万物之灵,不是因为我们的大脑能存储更多信息,而是因为我们能不断反思过往、积累经验、优化决策。
SRDP框架的核心价值,就是让AI具备了这种“反思和积累”的能力。它不用修改模型本身,只靠一套“可读写的记忆系统”,就实现了“边工作边学习”的闭环,不仅解决了传统AI“学了就忘”“数据饥饿”的痛点,还大幅降低了持续学习的成本。
未来,随着记忆机制的不断优化,我们可能会看到越来越多“越用越聪明”的AI:它们不再是冷冰冰的工具,而是能陪我们一起成长、一起解决问题的“伙伴”。
最后,我想问问你:如果有一个“越用越懂你”的AI助手,你最想让它帮你做什么?是工作中的专业任务,还是生活中的琐事?欢迎在评论区分享你的想法~
参考资料
• 标题:Memento 2: Learning by Stateful Reflective Memory
• 作者:Jun Wang(UCL)
• 链接:https://arxiv.org/abs/2512.22716