DeepSeek梁文峰Engram技术解读:AI认知是记忆检索推理高效分工
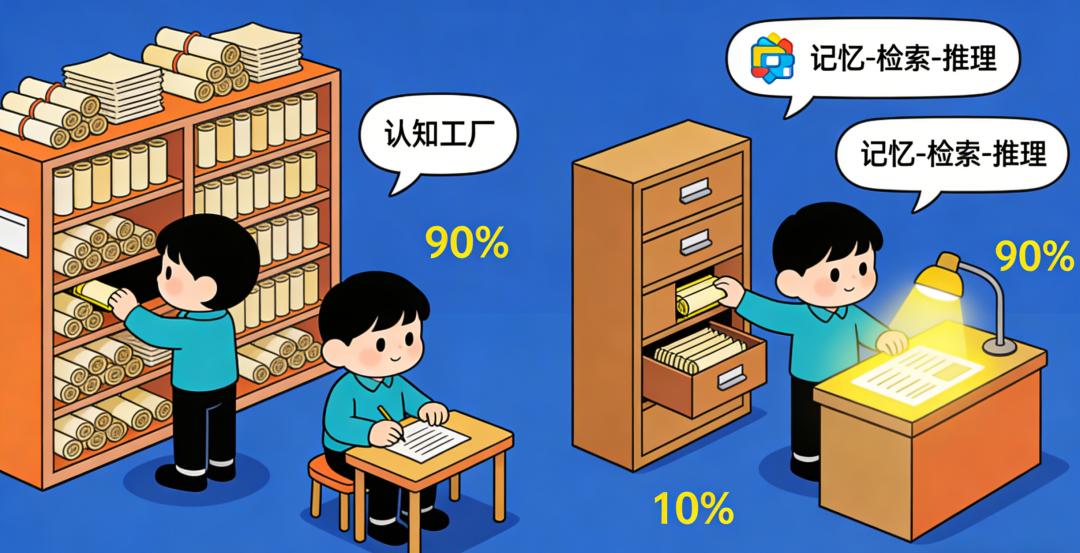
公元前3世纪的亚历山大图书馆,收藏了当时已知世界的全部典籍。但看管图书馆的学者们发现一个荒诞的现实:他们花90%的时间翻找卷轴,却只有10%的时间解读智慧。
这像极了今天的大型语言模型(LLM)。当我们让AI解决“戴安娜王妃的主要贡献”这类问题时,它需要调动多层Transformer的注意力机制和MoE(混合专家模型)的计算资源,先“重构”出“戴安娜王妃”这个实体的基本信息,再进行推理——就像学者先花数小时找到卷轴,才能开始阅读。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
DeepSeek团队的Engram技术,本质上是给AI造了一个“记忆抽屉”:把那些固定不变的知识(如多词实体、惯用短语)提前存储起来,需要时直接调取,让计算资源专注于真正的推理。这篇论文最让我兴奋的,不是效果指标的提升,而是它触碰了AI架构的核心矛盾:认知的本质,是记忆、检索、推理的高效分工。
痛点拆解:当LLM被迫“默写字典”——计算模拟记忆与检索荒谬
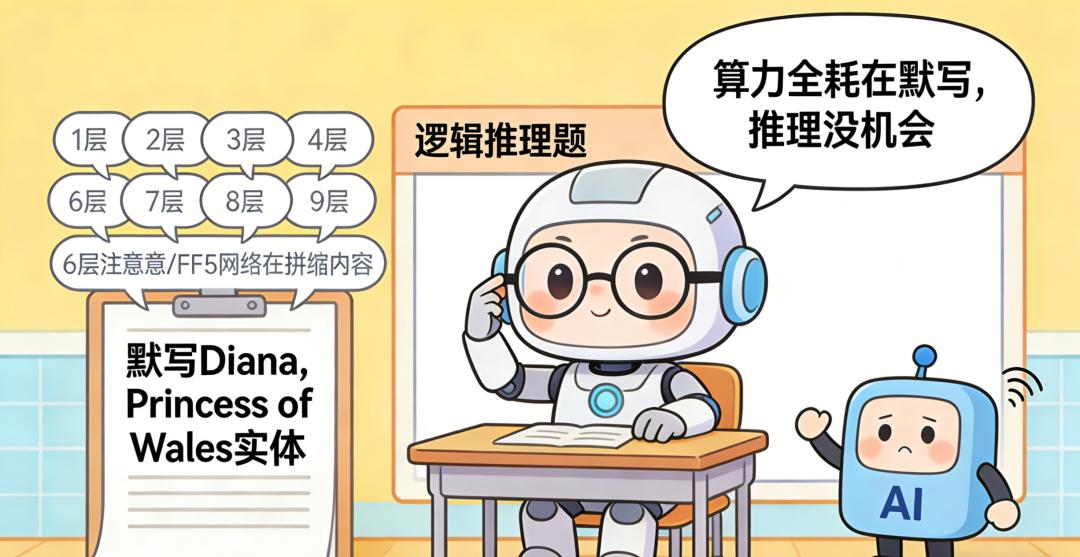
让我们回到一个具体场景:当模型处理句子“Diana, Princess of Wales”时,它要经历怎样的低效过程?
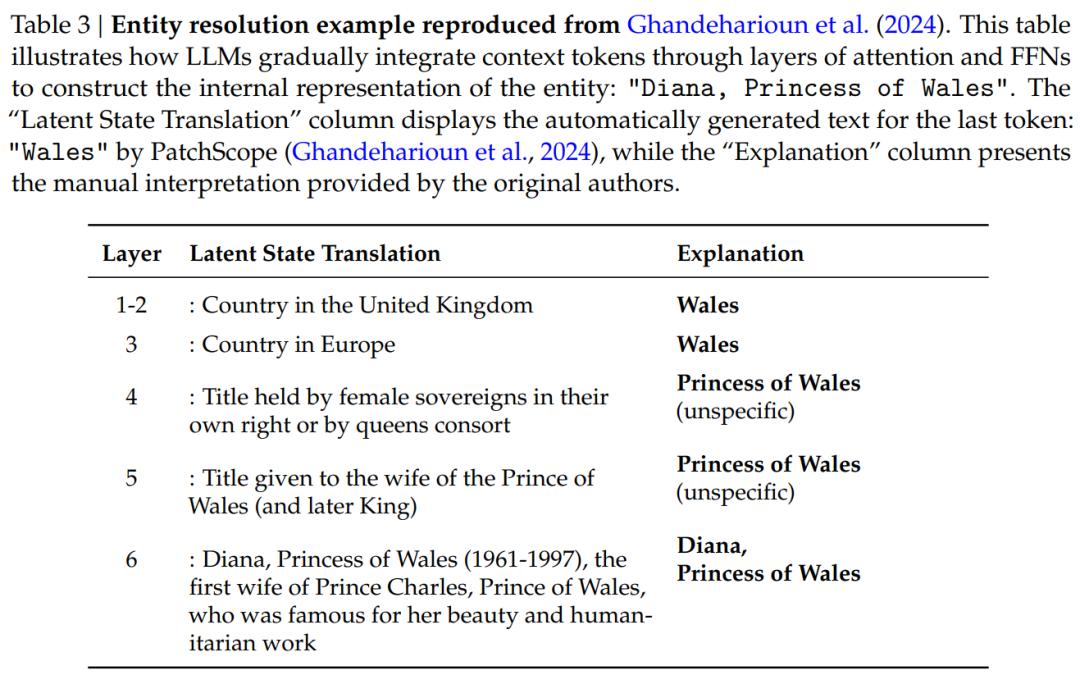
根据论文中的实验(Table 3),模型需要消耗前6层的注意力和FFN网络,才能从“Diana”到“Princess of Wales”逐步拼凑出完整实体的含义。这就像一场荒谬的考试:考生明明可以直接查阅字典,却被要求凭记忆默写词条定义,还要用这些默写的时间去解后面的逻辑推理题。
现状的低效根源,藏在两个无法调和的矛盾里:
• 静态知识的“计算浪费”:命名实体、固定搭配等语言元素,本质是高频重复的“记忆单元”,却要占用模型宝贵的“推理算力”
• 推理资源的“分配失衡”:早期层本应承接基础语义解析,却被静态知识的重构任务占满,导致深层推理缺乏足够的网络深度
说实话,这不是模型能力的问题,而是架构设计的“认知错位”——用动态计算模拟静态记忆和检索,就像用手术刀切面包,工具本身没错,只是用错了地方。
三、技术解构:Engram的本质是“认知分工”
Engram的核心创新,不是发明了N-gram嵌入,而是把“条件记忆”提升为与MoE“条件计算”并列的稀疏轴。用一个通俗的比喻解释:
如果把MoE比作“一群专家工匠”,每个专家擅长处理特定的动态任务(如逻辑推理、代码生成),那么Engram就是“工匠们的工具台抽屉”——里面放着常用的工具(固定短语、实体知识),工匠不用每次都自己打造工具,直接取用即可。
它的三大核心设计,完美呼应了人类认知逻辑:
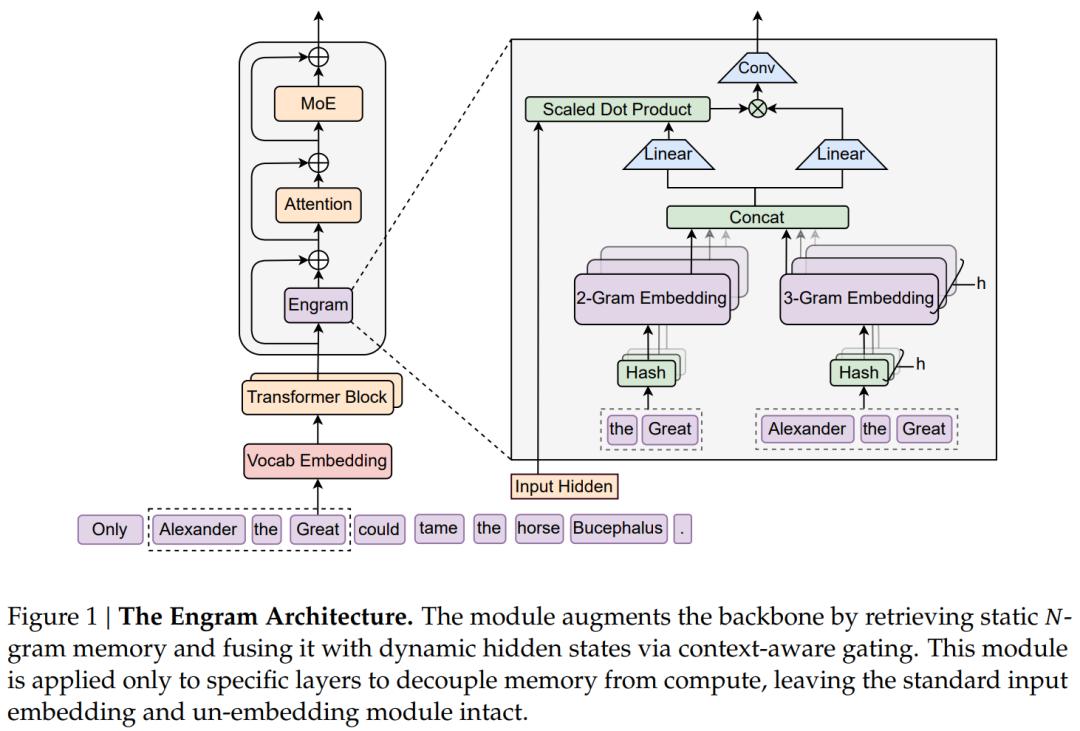
1. 哈希N-gram检索:用2-3元语法作为钥匙,通过多头部哈希实现O(1)常数时间调取,就像抽屉的标签系统;
2. 上下文门控机制:如果调取的记忆与当前语境冲突(如“苹果”指公司而非水果),会自动降低权重,避免记忆干扰;
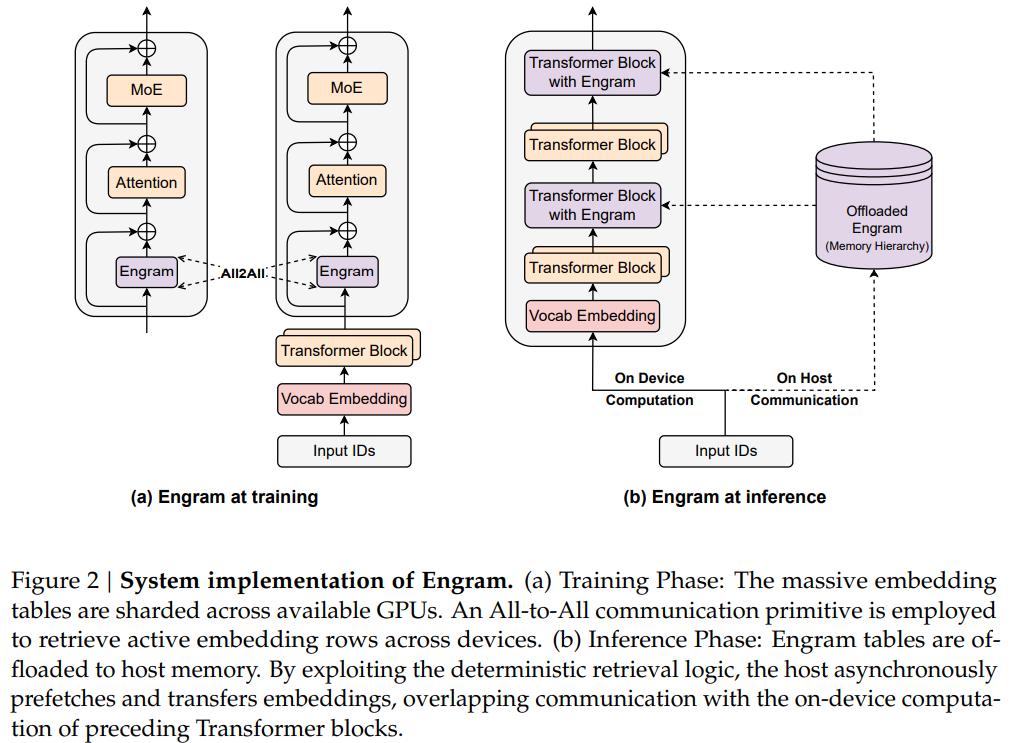
3. 内存分层卸载:把100B参数的记忆表放到主机内存,通过预取机制掩盖延迟,GPU只负责计算——这像极了人类大脑的“工作记忆”与“长期记忆”分工。
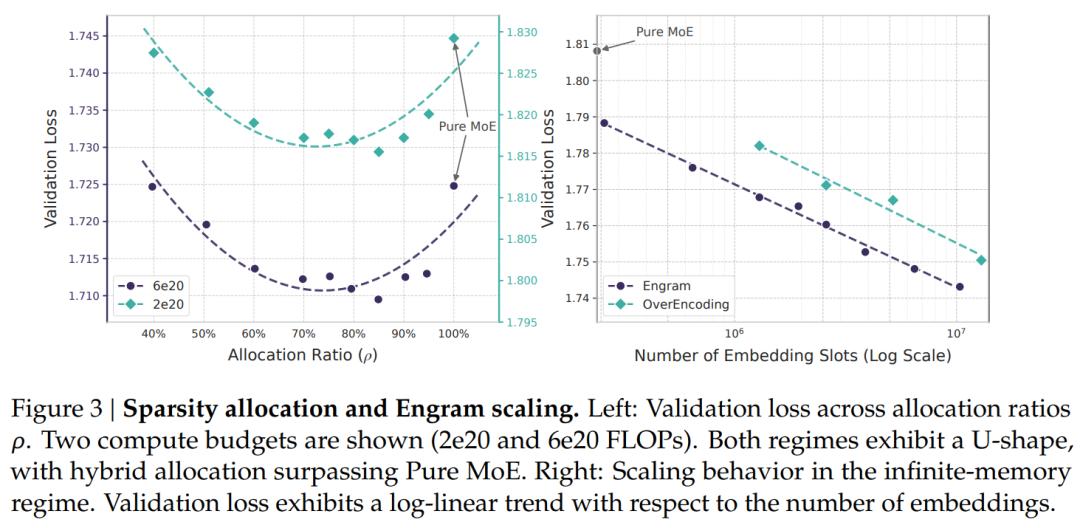
最有意思的是论文发现的U型缩放律(Figure 3):当MoE和Engram的参数分配比例在75%-80%时,模型性能最佳。这意味着“记忆”和“计算”不是替代关系,而是黄金搭档——太多记忆会让模型失去推理灵活性,太多计算则会陷入无效劳动。
四、深度拷问:为什么记忆模块能释放推理算力?
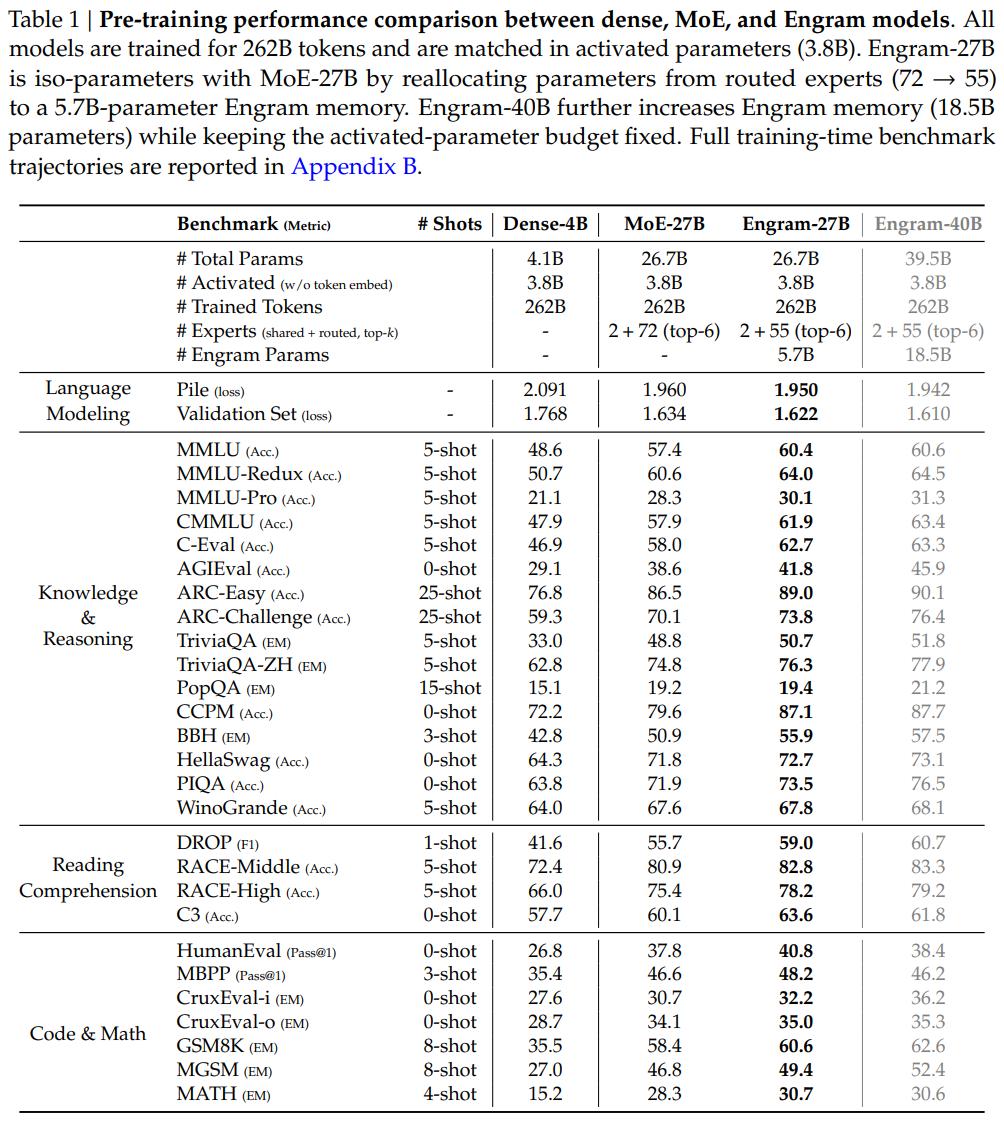
论文给出的实验数据超出预期:Engram-27B在知识类任务(MMLU)表现亮眼,但在推理类任务(BBH)和数学类任务(MATH)的提升更显著。
这背后的机制,让我想到了认知心理学中的“资源有限理论”——人类的注意力是有限资源,AI的计算资源也是如此。Engram的真正价值,不是“记住更多知识”,而是“解放推理资源”:
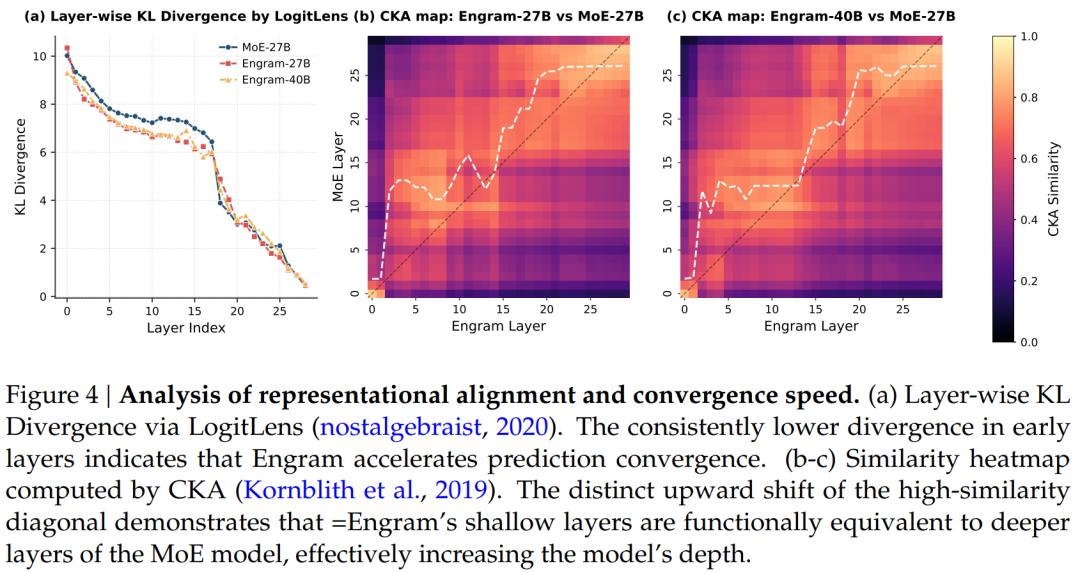
1. 有效深度提升:通过LogitLens分析(Figure 4),Engram模型在第5层的表征就相当于MoE模型第12层的效果,早期层不用再做记忆重构,相当于给推理“多了7层深度”;
2. 注意力聚焦:把本地依赖(如“四大发明”“伤寒杂病论”)交给记忆处理,注意力可以专注于全局语境(如长文本中的逻辑关联),这也是它在32k长上下文任务中(MultiQuery NIAH从84.2提升到97.0)表现突出的原因;
3. 参数效率优化:18.5B的Engram参数,能实现比MoE更多的性能提升,且不增加计算量——这就像给电脑加装硬盘,不用升级CPU就能提升整体效率。
这里的核心洞察是:AI的推理能力,不仅取决于计算力的强弱,更取决于计算资源的分配效率。
五、行业终局观:AI架构的“认知转向”
Engram不是对MoE的否定,而是对LLM架构的一次“认知校准”。它预示着未来的大模型,将从“单纯堆参数”转向“模拟人类认知结构”:
• 短期来看,条件记忆与条件计算的双稀疏轴,会成为超大模型的标准配置。就像现在的手机都有“运行内存”和“存储内存”,未来的LLM也会明确区分“推理参数”和“记忆参数”;
• 中期来看,内存分层技术会突破GPU显存限制,让模型参数向万亿级甚至百万亿级扩展——因为记忆参数可以卸载到廉价的主机内存或SSD,不用占用昂贵的HBM;
• 长期来看,这种“认知分工”会让AI更接近人类的学习模式:我们不会记住每一个细节,但会把关键知识结构化存储,用推理连接知识碎片。
说实话,这篇论文最让我兴奋的不是技术细节,而是它传递的信号:AI的下一场革命,不是算法的突破,而是对人类认知本质的模仿——就像亚历山大图书馆最终成为文明灯塔,不是因为收藏了更多卷轴,而是因为建立了更高效的检索系统。
参考资料
• 标题:Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
• 作者:Xin Cheng, Wangding Zeng, Damai Dai, Qinyu Chen, Bingxuan Wang, Zhenda Xie, Kezhao Huang, Xingkai Yu, Zhewen Hao, Yukun Li, Han Zhang, Huishuai Zhang, Dongyan Zhao, Wenfeng Liang
• 单位:DeepSeek-AI, 北京大学
• 链接:https://arxiv.org/pdf/2601.07372