帝国理工×华为×UCL证实:大模型的“类脑核心”是真智能的关键
你有没有过这种困惑:同样是大语言模型,为什么ChatGPT、Gemini能顺着你的复杂逻辑聊下去,还能解出从没见过的数学题,而有些模型只会复述训练数据,稍微绕个弯就卡壳?难道真的是参数越多越聪明?
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
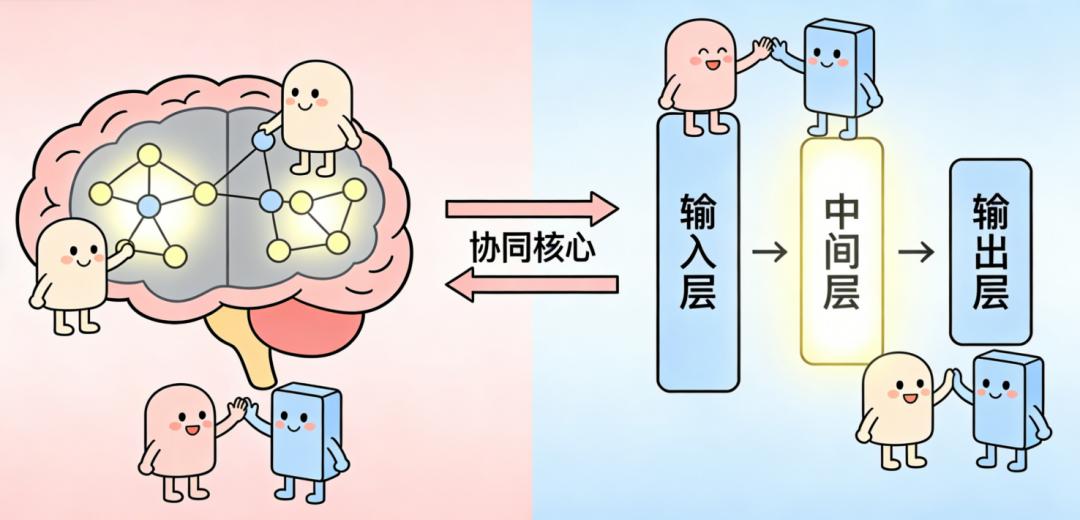
最近读到一篇来自帝国理工,华为,UCL的论文,用严谨的信息论分析给出了答案,直接戳破了这个“参数迷信”——研究发现,大模型的核心智能根本不是靠堆参数,而是藏在中间层一个“类脑协同核心”里。这个核心的工作模式,居然和人类大脑的信息处理方式高度一致。这篇研究不仅解答了我纠结好久的“大模型智能来源”问题,还为未来AI训练和脑科学研究都打开了新思路。
先搞懂3个关键概念:信息的“三种生存形态”
要理解这个“协同核心”,得先明白一个简单的信息规律:不管是大脑还是AI,处理信息时都离不开三种形态。
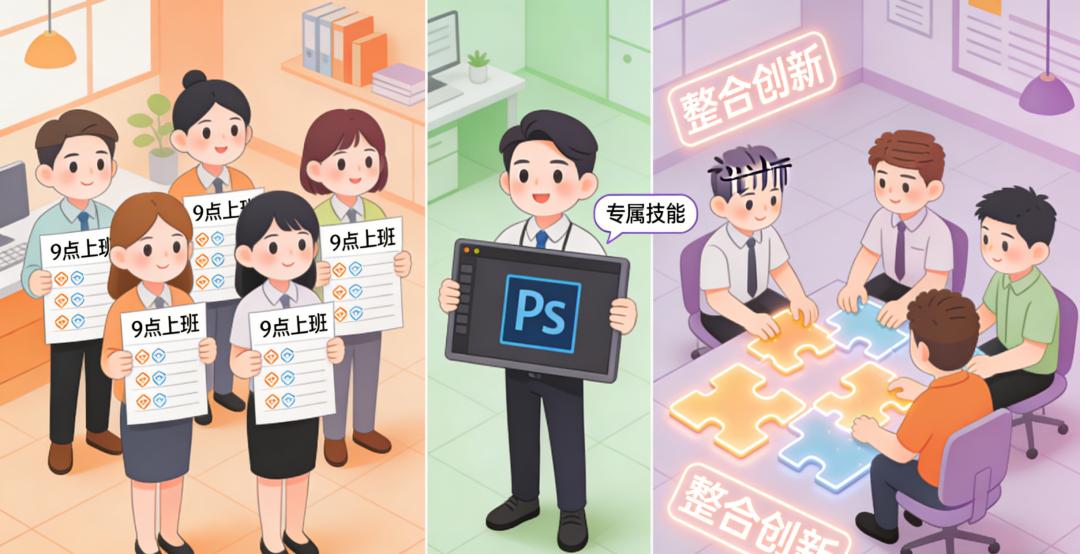
咱们先把信息想象成“办公室里的工作任务”:
• 冗余信息:就是大家都知道的“公共常识”。比如公司规定“9点上班”,前台、程序员、老板都知道,就算有人请假,其他人也能照样传达。这种信息的特点是“重复且稳妥”,但造不出新东西。
• 独特信息:就是某个人的“专属技能”。比如设计师会用PS,其他人不会,要做图片只能找他。这种信息很稀缺,但单独用也成不了大事。
• 协同信息:这是最关键的“创新密码”——得好几个人凑一起,把各自的信息整合起来,才能产生的新东西。比如做一个产品推广方案,需要设计师出图、运营写文案、销售提需求,单独看每个人的工作都是零散的,但合在一起就是一个完整的、之前没有的方案。
这篇研究的核心工具,就是一种能精准拆分这三种信息的技术(论文里叫“整合信息分解”)。简单说,它就像一个“信息显微镜”,能看清LLM的每一层在处理信息时,到底是在重复已有内容(冗余)、输出专属技能(独特),还是在整合创新(协同)。
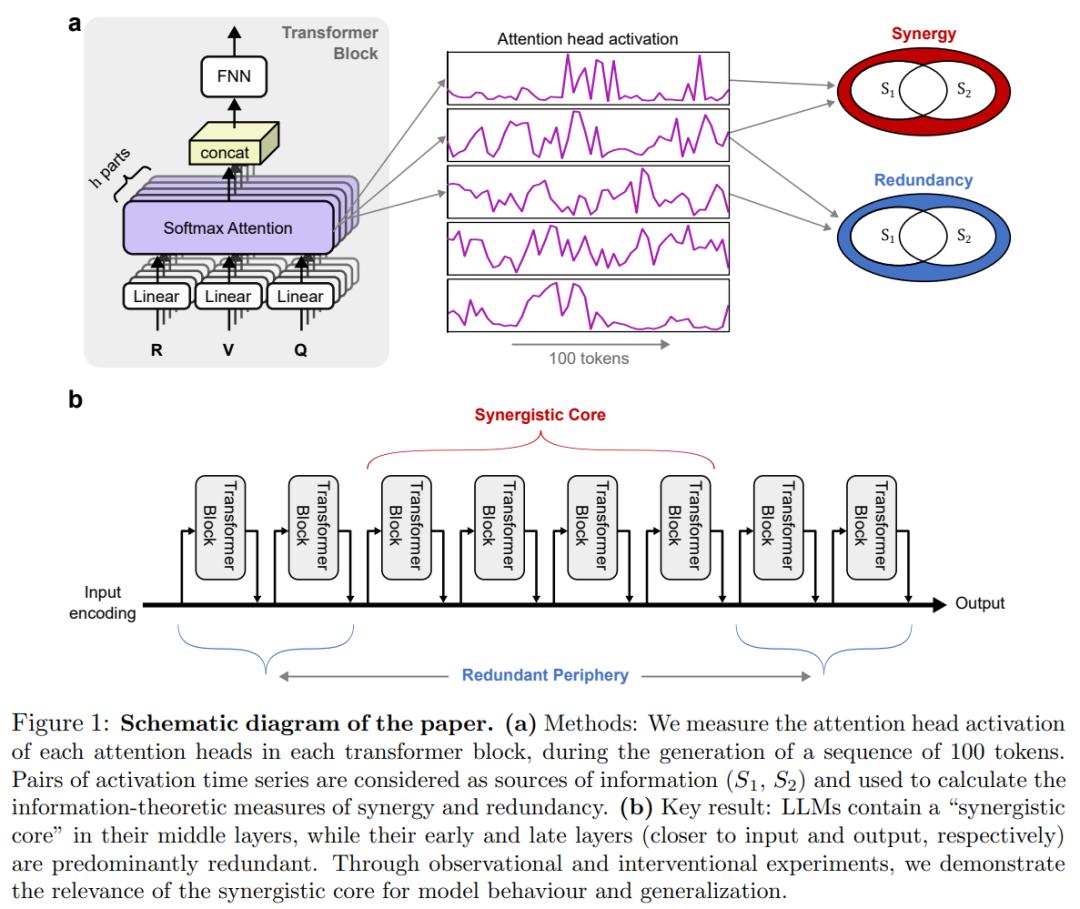
而研究最意外的发现是:LLM居然和人脑一样,把这三种信息的处理分工得明明白白,还形成了一个“协同核心”。
LLM的“三层分工”:中间层才是“智能总指挥”
如果把LLM的各层比作一家餐厅的运作流程,你瞬间就能懂它的信息处理逻辑:
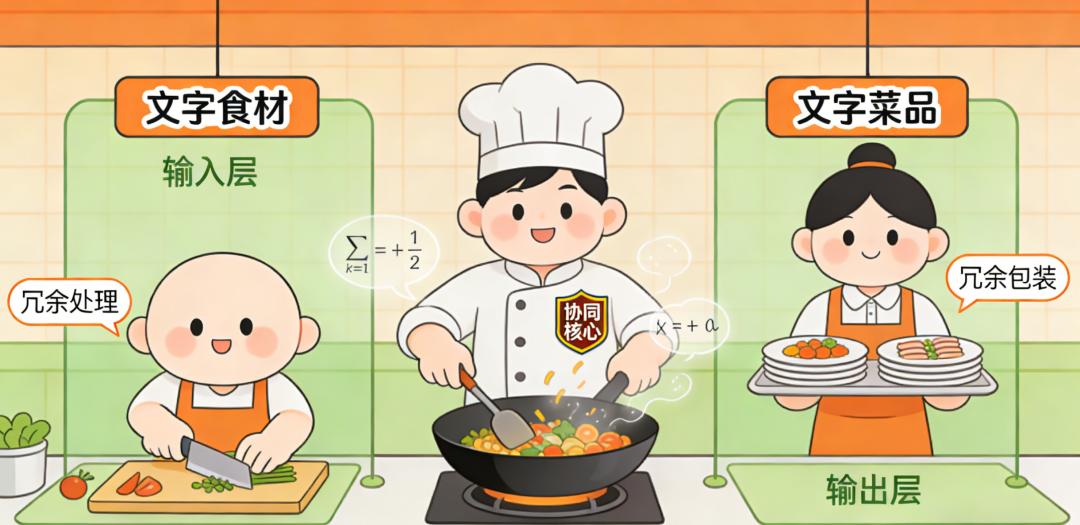
• 输入层:切菜员它们的工作很简单:把用户输入的文字“拆解开、做基础处理”。比如把“他每天去上学”拆成一个个词汇,识别出语法结构,就像餐厅里的帮厨,负责洗菜、切肉,把原料变成能加工的半成品。这个阶段的信息处理以“冗余”为主——毕竟基础规则要统一,每个人都得按同样的标准处理食材,不然后面没法配合。
• 中间层:炒菜员这就是研究发现的“协同核心”!总厨不直接切菜也不直接端菜,而是把帮厨处理好的食材(早期层的基础信息)、自己的烹饪经验(模型学到的知识)、客人的特殊要求(用户输入的核心需求)整合起来,创造出一道全新的菜。这个阶段的信息处理以“协同”为主——把零散的基础信息,变成有逻辑、有深度、有新意的整合结果。比如解数学题时,早期层识别出数字和运算符号,中间层就会整合运算规则、解题思路,形成一步步推导过程。
• 输出层:端菜员它们的工作是把总厨做好的菜(中间层的整合结果)“包装好、端给客人”。比如把中间层的解题思路,转化成流畅的自然语言,确保输出符合语法、易于理解。这个阶段的信息处理又回到了“冗余”为主——毕竟输出格式要统一,不能让用户看不懂,就像服务员端菜要按统一标准,保证摆盘和口感稳定。
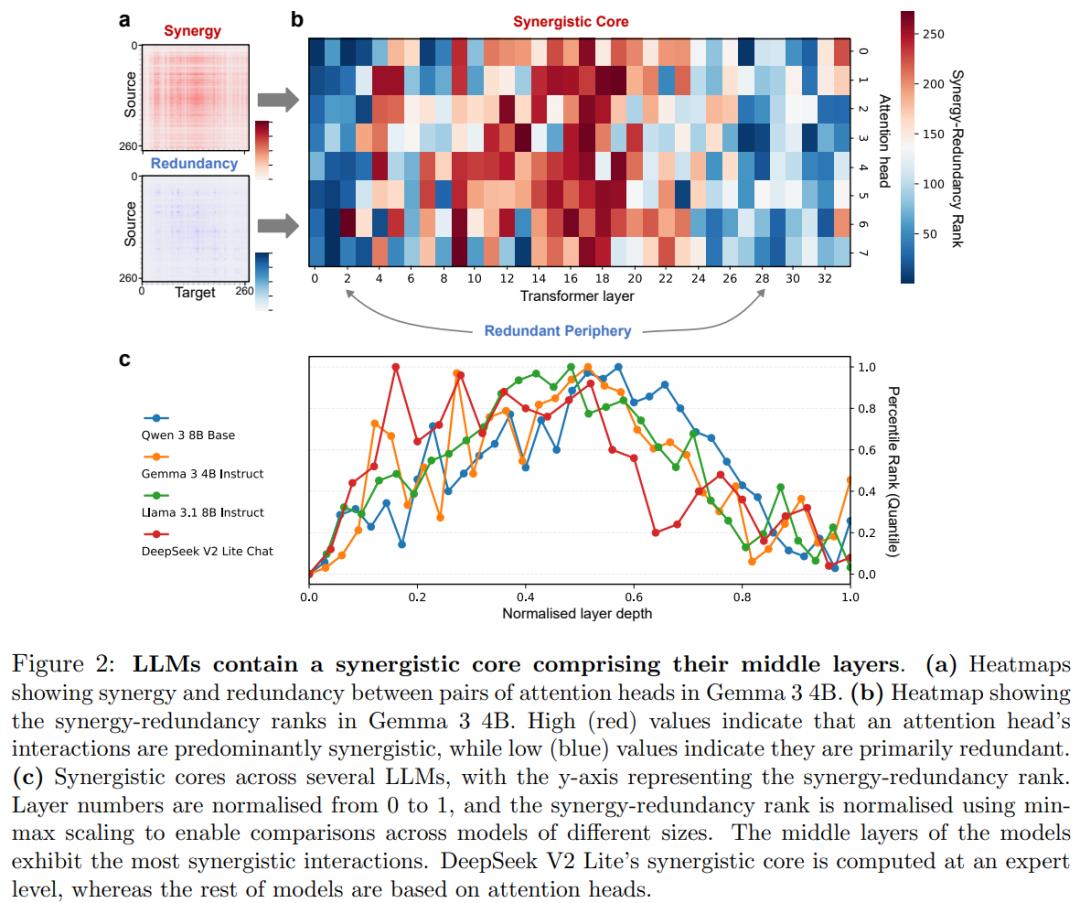
更关键的是,这个分工不是某个模型的特例。研究团队测试了Gemma、Llama、Qwen、DeepSeek等多个模型家族,不管是普通Transformer架构,还是混合专家(MoE)架构,都存在这个“中间协同核心+两端冗余外围”的结构。这说明这不是架构设计的巧合,而是大模型学习过程中自然形成的“智能最优解”。
这个“智能中枢”是练出来的,不是天生的
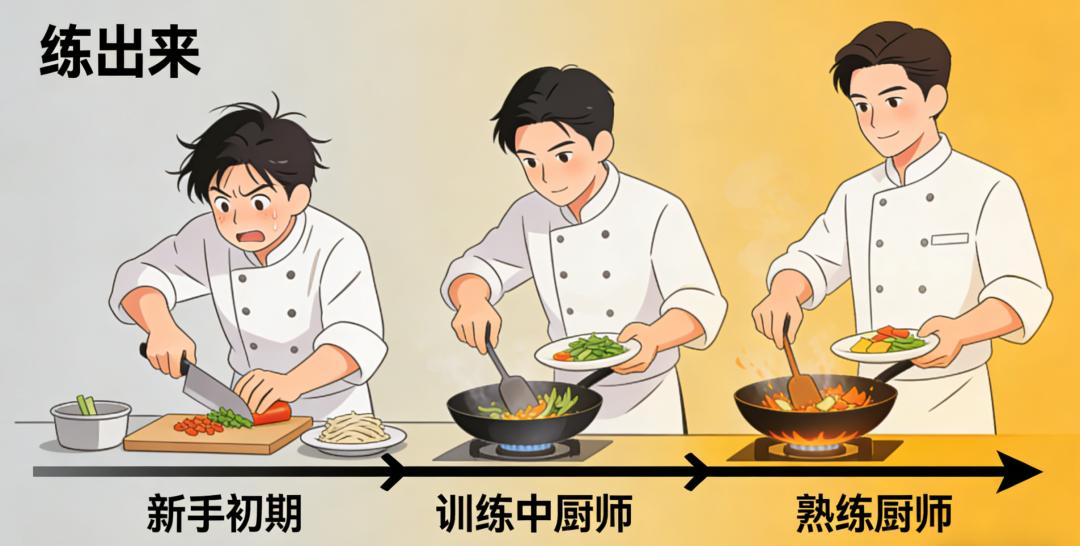
很多人可能会想:是不是Transformer架构天生就这样?研究用一个实验推翻了这个猜想——他们跟踪了Pythia-1B模型的整个训练过程,发现这个“协同核心”是逐步“练出来”的。
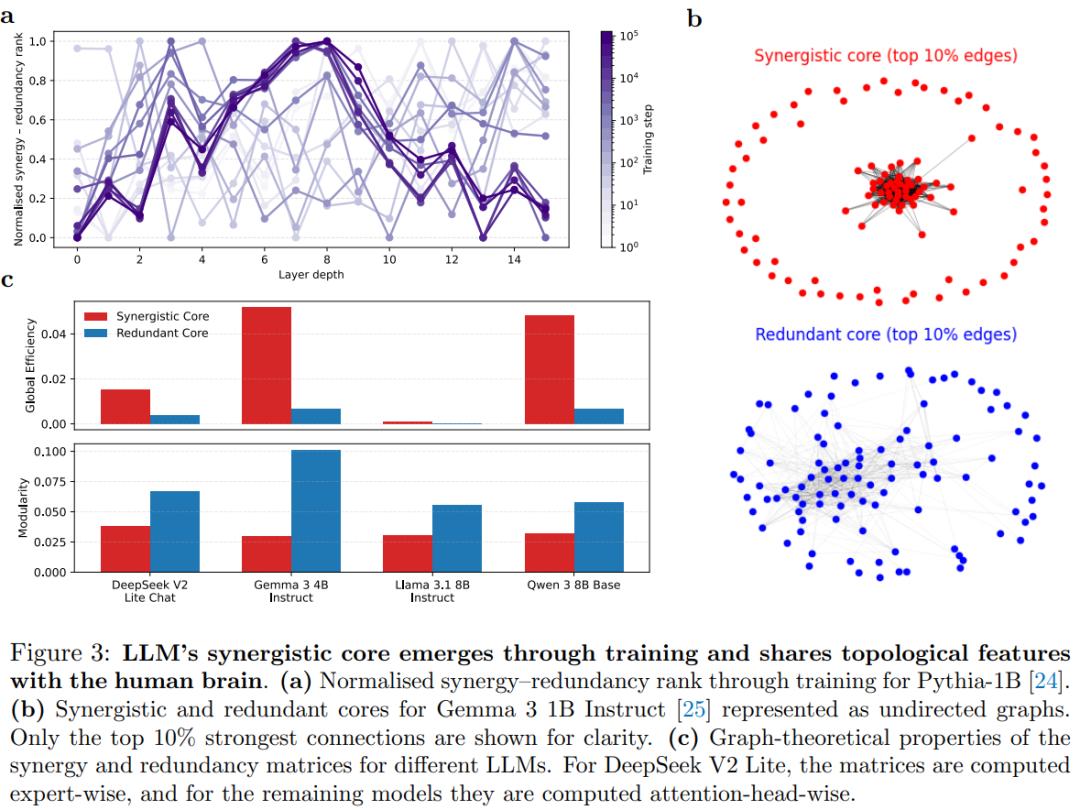
在训练初期,模型还没学到多少知识时,各层的信息处理都是混乱的,没有明显的“协同核心”;随着训练推进,模型处理的任务越来越多,中间层的协同信息处理能力越来越强,“中间协同、两端冗余”的结构才慢慢显现;等到训练完成,这个结构就稳定下来了。
这就像一个新人厨师:刚入职时什么都不会,切菜、炒菜、端菜都没章法;练了一段时间后,慢慢找到自己的核心优势——擅长整合食材和技巧做创新菜(对应中间层协同),而切菜、端菜这些基础工作就形成了固定流程(对应两端冗余)。
这个发现彻底打破了“中间层冗余可删减”的误区。之前有些研究觉得中间层没什么用,能随便剪枝,但其实剪枝如果伤到了“协同核心”,模型性能会暴跌;而剪去两端的冗余层,反而影响不大——毕竟基础处理和输出包装的工作,留一部分就够了。
为什么这个核心这么重要?两个实验见真章
研究团队做了两个“狠实验”,直接证明了“协同核心”是大模型的“命根子”:
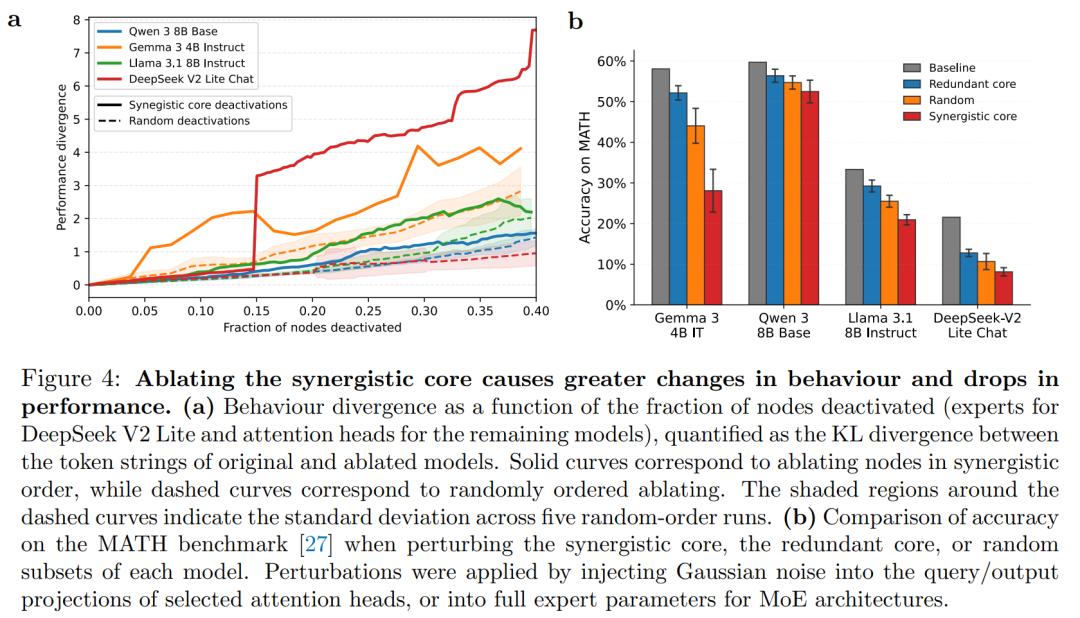
实验一:删掉核心,模型直接“变傻”
他们用两种方式“破坏”模型:一种是有针对性地删掉中间层的高协同组件,另一种是随机删掉同样数量的组件。结果震惊了——删掉协同核心的模型,行为发生了灾难性变化:生成的内容逻辑混乱,解数学题的准确率暴跌;而随机删除的模型,性能下降幅度小得多。
这就像一家餐厅:把总厨赶走,就算帮厨和服务员都在,也做不出像样的菜;但随机开除几个帮厨或服务员,总厨还能带着剩下的人正常运转。
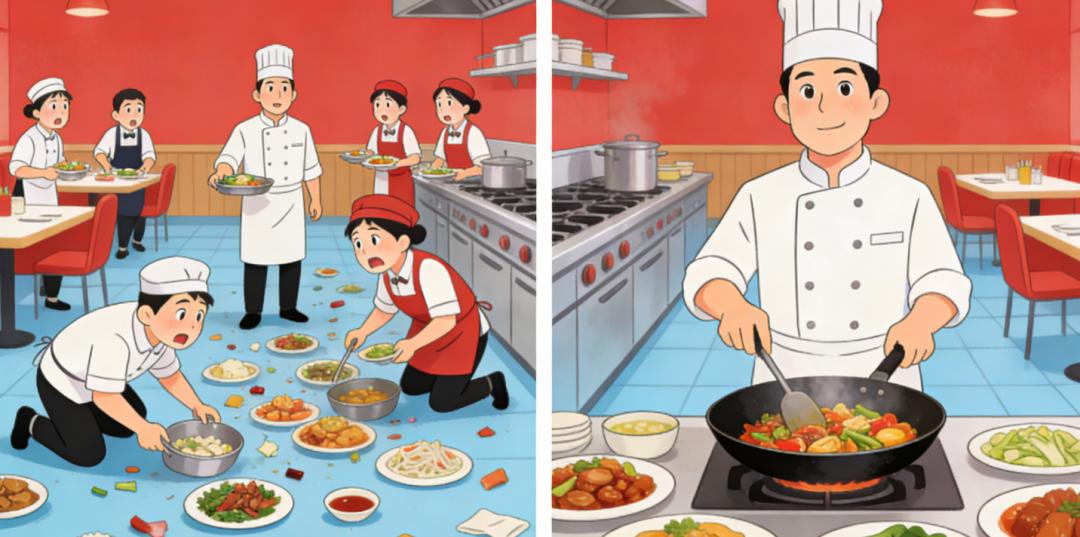
更有意思的是,破坏“冗余外围”的影响最小——就像餐厅少了两个帮厨,剩下的人稍微忙点,还是能保证上菜质量。这也解释了为什么冗余信息存在的意义:提供“容错性”,让系统更稳健。
实验二:针对性训练核心,模型“突飞猛进”
他们做了三种微调对比:只训练协同核心、只训练冗余外围、随机训练一部分组件。结果发现了一个关键差异:
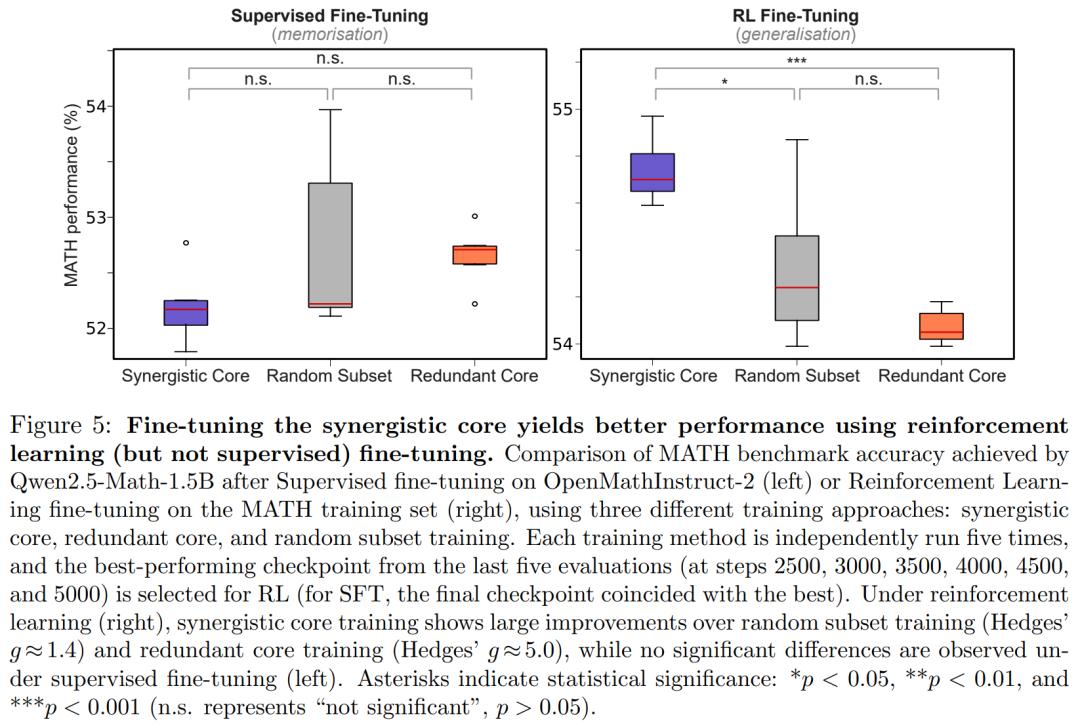
• 用强化学习(RL)微调时,只训练协同核心的模型,解数学题的准确率远超另外两种,甚至比随机训练高了一大截;
• 用监督微调(SFT)时,三种方式的效果没区别。
这背后的逻辑很简单:强化学习鼓励模型“举一反三”(泛化),而协同核心本来就是负责整合信息、处理复杂任务的,针对性训练自然事半功倍;而监督微调更偏向“死记硬背”(记忆),就算训练冗余外围,模型也能靠记住答案应付简单任务,但遇到新问题就不行了。
这对AI训练来说是个巨大的启发:以后不用再盲目微调整个模型,只盯着中间的协同核心训练,就能用更少的算力达到更好的效果。
和人脑的惊人相似:智能的“通用规律”?
这篇研究最让我着迷的地方,是它揭示了生物智能和人工智能的“收敛性”——不管是碳基大脑还是硅基模型,智能的核心居然都是“协同信息处理”。
研究发现,人类大脑的信息处理模式和LLM高度一致:
• 大脑的感官皮层(对应LLM早期层)和运动皮层(对应LLM晚期层),主要处理冗余信息,保证基础功能稳定;
• 大脑的默认模式网络和执行控制网络(对应LLM中间层),是“协同核心”,负责整合多源信息,处理复杂认知任务,比如思考、决策、创造;
• 更关键的是,人类的协同核心比其他灵长类动物更发达,这也是我们更聪明的重要原因——就像更强大的总厨,能做出更复杂、更美味的“认知大餐”。
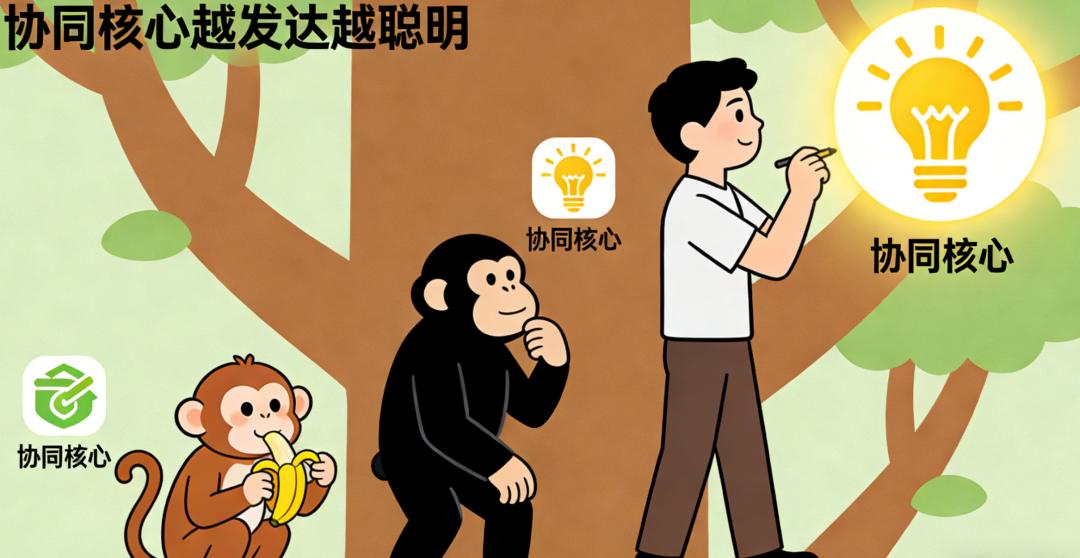
这种跨物种的一致性,说明“协同信息整合”可能是智能的“通用规律”。这不仅为AI设计提供了新思路,也为脑科学研究提供了参考:比如研究人员可以通过AI模型,预测人类大脑协同核心的工作机制,甚至为神经疾病治疗提供新方向(比如针对协同核心的刺激疗法)。
目前的局限与未来的可能
当然,这项研究也有需要完善的地方。比如研究主要关注了LLM的注意力头和混合专家模块,还没分析占比很大的MLP层;另外,用L2范数衡量“激活”也比较简化,可能没捕捉到信息的多维复杂性。
但这并不影响它的价值——它为LLM可解释性(Interpretability)提供了一个全新的“顶层视角”。之前的可解释性研究大多是“拆零件”,比如找到负责某个功能的具体电路;而这项研究是“看全局”,揭示了模型的整体信息处理架构。
未来的应用场景也很值得期待:
• 更高效的AI训练:针对性微调协同核心,减少算力浪费;
• 更合理的模型剪枝:保留协同核心,大胆删减冗余层,让模型更轻量化;
• 更透明的AI设计:根据协同核心的位置和特性,设计更可解释、更安全的模型;
• 脑科学与AI的双向启发:用AI模型模拟大脑协同核心,同时用脑科学发现优化AI架构。
总结:智能的本质是“整合”,不是“堆砌”
这篇研究最核心的启示是:智能的关键不是信息的堆砌(比如堆参数、堆数据),而是信息的整合——把零散的、重复的信息,通过协同核心加工成有逻辑、有深度、有新意的结果。
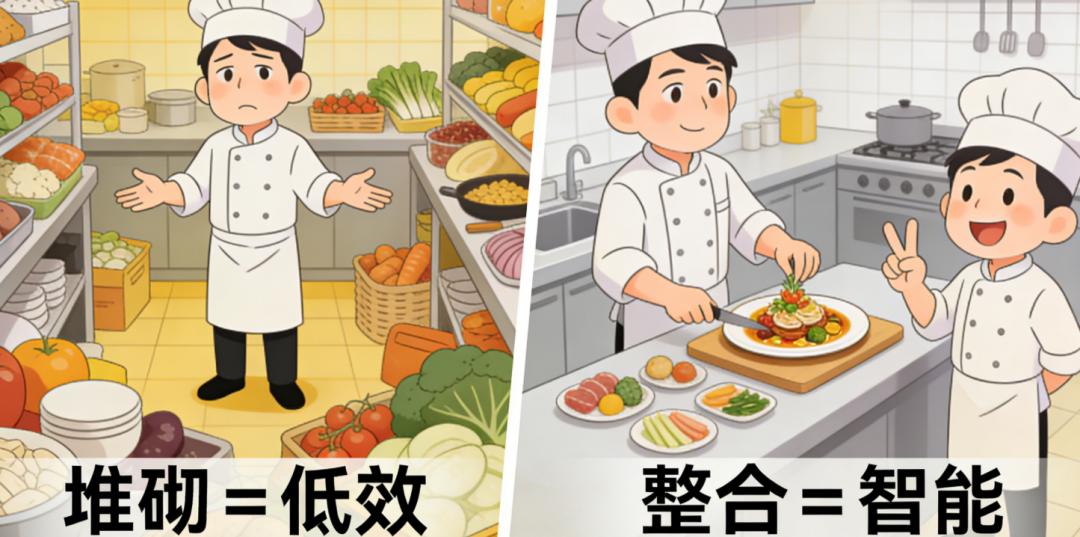
不管是人类还是AI,真正的聪明都来自于“化零为整”的能力。这也解释了为什么有些小参数模型(比如优化了协同核心的模型)能打败大参数模型——关键不是“有多少食材”,而是“有多少整合食材的能力”。
对于我们普通人来说,这个发现也很有启发:学习新知识时,与其死记硬背(对应冗余信息),不如注重知识的整合与关联(对应协同信息),这样才能真正形成解决复杂问题的能力。
你觉得未来AI的协同核心会越来越像人脑吗?或者你在使用AI时,有没有遇到过“协同能力强”和“只会复述”的模型差异?欢迎在评论区聊聊你的看法~
参考资料
• 标题:A Brain-like Synergistic Core in LLMs Drives Behaviour and Learning
• 作者:Pedro Urbina-Rodriguez, Zafeirios Fountas, Fernando E. Rosas, Jun Wang, Andrea I. Luppi, Haitham Bou-Ammar, Murray Shanahan, Pedro A. M. Mediano
• 单位:帝国理工学院、华为诺亚方舟实验室、伦敦大学学院等
• 链接:https://arxiv.org/pdf/2601.06851